需要掌握:ASCII、GBK、Unicode、UTF-8编码
打开文件
读写文件,要先通过内置open()函数打开文件
语法
open('文件路径',mode='模式',encoding='编码')
常用参数说明:
- file: 必需,文件路径(相对或者绝对路径)。
- mode: 可选,文件打开模式,可省略。详细介绍在下面
- encoding: 可选,指定编码,如utf-8,省略时采用系统默认编码,windows默认采用GBK编码
读取文本文件常用模式:
- 默认模式:rt,t是文本模式,rt表示只读文本文件
- 文本文件:
- ‘r’:只读
文件指针放在文件的开头(关于文件指针的解释在下面)
文件 必须存在,否则抛异常 - ‘r+’:读写
文件指针放在文件的开头
文件 必须存在,否则抛异常
- ‘r’:只读
例子
读取文件:
f=open('d:\\1.txt','r')
f=open('d:\\1.txt','r',encoding='UTF-8')
关闭文件
读写文件后应 及时关闭 ,关闭后将 不能 对文件进行任何 操作。如果不关闭,那么 文件一直被占用,会出现问题,如:
- 不能改文件名
- 有时运行某软件时会提示XXX文件被占用,为了避免该情况,读写文件后应及时关闭
- 操作系统对 打开文件的次数有限制
当 程序退出 后,文件会释放
补充:
有的软件,在运行时, 会一直独占文件 ,这种时候,就不能关闭 。
如:word、ppt、excel等,在实现某软件服务器时,在运行期间要一直输出日志,所以一直独占日志文件
语法
f.close()
例子
运行期间不关闭文件对象,无法对文件进行其他操作,如不能改名。
当程序退出后,会释放文件,可以做其他操作
见下面代码:
#coding=utf-8
import time

f=open('c:/users/mym/desktop/1.txt','r')
time.sleep(10)#休眠10秒
在这10秒内,改变文件名称,弹出窗口如下:

10秒后程序退出,可以修改文件名
操作系统打开文件的次数有限制
i=0
while True:
    #文件对象会自动销毁
    f=open('c:/users/mym/desktop/1.txt','r',encoding='utf-8')
    no=f.fileno()#每打开一次文件,会加1
    print(i,no)
    i+=1
测试执行,发现f.fileno()返回的是固定几个值,是因为python自动回收了,修改如下:
i=0
l=[]
while True:
    f=open('c:/users/mym/desktop/1.txt','r',encoding='utf-8')
    l.append(f)#将文件对象添加到list中,就不会被自动销毁
    no=f.fileno()#每打开一次文件,会加1
    print(i,no)
    print(i,f.fileno())
    i+=1
测试执行,抛异常如下:
OSError: [Errno 24] Too many open files: 'c:/users/mym/desktop/1.txt'
打开文件次数过多
注意:
操作文件结束后要及时关闭文件
读取文件
读取文本文件,先是读取二进制数据到内存,然后进行 编码转换,转换后是人眼可识别的字符
读取文本文件有 三种 方法
方法1:
读取 全部内容 或者 指定的字符数 ,包括 换行符\n
语法:
f.read([size])
参数
- size:设置 读取的长度。文本文件模式以 字符 为单位
如果 未给定 或 负数 则 读取 所有,适用于读取 小文件 ,因为读取几个G的大文件,可能会将内存占满
注意:
读取UTF-8 with BOM的文件时,会出现问题,解决方法见
http://www.malaoshi.top/show_1EF2LSjQUHxw.html
返回值
返回读取的内容
文本文件包括 换行符\n 字符
例子:
f=open('c:/users/mym/desktop/1.txt','r')
c=f.read()
print(c)
f.close()
适用于读取小文件
python换行符与操作系统换行符
通过debug方式可知,内存中的换行符是\n(也是unix、linux的换行符),但在windows系统中换行符是\r\n,python内部做转换了
方法2:
读取一行(即:遇到”\n”字符停止读取),包括 “\n” 字符。
适用于读取大文本文件
注意:
有时大文本文件都在一行里,这种情况读取可能会引发内存不够的错误
语法:
f.readline([size])
参数
- size : 如果 未指定长度 或为 负数,读取一行。
如果是非负数,当size比一行的字符数小,那么就读取长度是size的内容;如果size比一行的字符数大,那么就读取一行
一般不指定
返回值
返回读取的内容,包括 “\n” 字符
例子
使用windows自带的编辑器notepad,编辑内容如下:
床前明月光
疑是地上霜
举头望明月
低头思故乡
保存(默认保存是GBK编码),然后编写python程序读取该文件,代码如下:
f=open('c:/users/mym/desktop/1.txt','r')
c=f.readline()
print(c)
f.close()
这是读取第一行
例子
改造上面的程序,可以读取所有行
f=open('c:/users/mym/desktop/6.txt','r+',encoding='gbk')
line=f.readline()
print(line,end='')
while line:
    line=f.readline()
    print(line,end='')
f.close()
读取所有行
方法3:
文件对象是 可迭代对象 对象,可使用for...in...语句
例子:
f=open('c:/users/mym/desktop/6.txt','r+',encoding='gbk')
for line in f:
    print(line,end='')
f.close()
方法4:
读取所有行,并按照行放入到list中,包括 “\n” 字符
适用于读取小文本文件
语法
f.readlines([size])
参数
- size — 如果 未指定长度 或为 负数,读取所有行。
如果指定size,将返回接近size的行,也就是说可能只读到文件的一部分,且具体长度不确定。
一般不指定
返回值
返回列表,包含所有的行。
包括 “\n” 字符
例子
使用windows自带的编辑器notepad,编辑内容如下:
床前明月光
疑是地上霜
举头望明月
低头思故乡
保存(默认保存是GBK编码),然后编写python程序,用二进制模式读取该文件,代码如下:
f=open('c:/users/mym/desktop/3.txt','r')
content=f.readlines()
print(content)
f.close()
执行结果如下:
['床前明月光\n', '疑是地上霜\n', '举头望明月\n', '低头思故乡\n']
注意
读取整个文件后,文件指针指向 文件末尾,再次读取将 没有内容
解决方法用f.seek(0),将文件指针移动到开头
方法5 (不推荐)
文件对象是 迭代器 对象,可通过 next() 函数 返回文件的 下一行,如果到达结尾(EOF),则触发 StopIteration异常
例子:
f=open('c:/users/mym/desktop/1.txt','r+',encoding='gbk')
line=next(f)

while line:
    print(line,end='')
    line=next(f)
f.close()
最后一次执行时,会抛出StopIteration错误,这样影响程序运行,为了不让其抛出,要用try...except语句捕捉异常,但这种写法麻烦,下面是更好的写法
文件指针
当对文件进行操作时,内部有 文件指针 定位当前内容的位置,当用 读取模式 打开文件时,文件指针指向文件的开始位置,读取长度是n的内容后,文件指针会移动到n+1的位置
所以 读完 整个文件后,如果不移动文件指针,将 无法再次读取文件内容
打开文件如下图:
当文件内容都是英文时,一个 字节 对应一个 英文字符
读取整个文件后如下图:

移动文件指针
移动文件指针到指定位置,为负数时抛出异常
语法:
f.seek(offset[, whence])
参数
- offset — 移动的偏移量,单位:字节,不论文本还是二进制模式
- whence — 可选,表示要从哪个位置开始偏移;
需要引入os模块,import os,值如下:- os.SEEK_SET:从文件开头算起,默认值
- os.SEEK_CUR:从当前位置算起。文本文件模式读取,不能设置此项
- os.SEEK_END:从文件末尾算起。文本文件模式读取,只能设置到末尾,向前偏移报错
返回值
无
例子1
f=open('c:/users/mym/desktop/1.txt','r')
c=f.read()#读取文件后,文件指针指向末尾
print(c)
f.seek(0)#需要将文件指针指向开头,才能再次读取
c=f.read()
print(c)
f.close()
例子2
使用windows自带文本编辑器notepad,新建文本文件,并通过notepad写入床前明月光,保存(默认保存采用GBK编码)。然后编写python程序,将文件指针移动1个字节,然后读取文件,代码如下:
f=open('c:/users/mym/desktop/1.txt','r')
c=f.seek(1)#移动一个字节
c=f.read()#读取文件
print(c)
f.close()
执行报错,如下:
UnicodeDecodeError: 'gbk' codec can't decode byte 0xa1 in position 0: illegal multibyte sequence
原因:
notepad默认保存为GBK编码,一个汉字占用 2个字节 ,当 移动一个字节 ,开始读取时,无法正确将 字节 转为 汉字
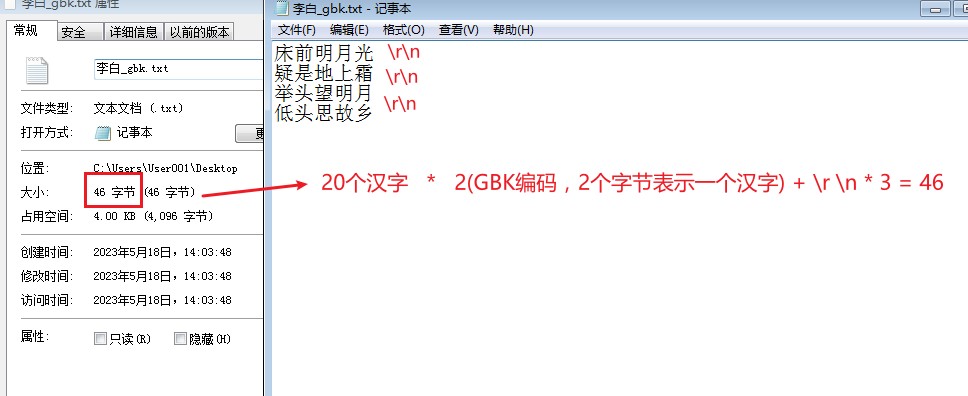
UTF-8编码中汉字通常占3个字节,很生僻汉字占4-6个字节
注意:
由于上面原因,移动指针会造成错误,一般不要移动文件指针
获取文件指针位置
语法:
file.tell()
参数
无
返回值
返回文件指针的当前位置
例子:
f=open('c:/users/mym/desktop/1.txt','r')
c=f.read()
print(c)
print(f.tell())
f.close()
感谢:
http://www.runoob.com/python/python-files-io.html
http://www.runoob.com/python3/python3-file-methods.html
https://blog.csdn.net/qq_37383691/article/details/76060972