介绍
朴素贝叶斯是一种简单的 贝叶斯算法,因为贝叶斯定理涉及到了概率学、统计学,其应用相对复杂,因此我们只能以简单的方式使用它,比如天真的认为,所有事物之间的特征都是相互独立的,彼此互不影响
分类算法
贝叶斯分类是一类分类算法的总称,这类算法均以贝叶斯定理为基础,故统称为贝叶斯分类。而朴素贝叶斯分类是贝叶斯分类中最简单,也是常见的一种分类方法。
日常生活中我们每天都进行着分类过程。例如,当你看到一个人,你的脑子下意识判断他是学生还是社会上的人;你可能经常会走在路上对身旁的朋友说“这个人一看就很有钱”之类的话,其实这就是一种分类操作。
例子
已知某学校男生占60%,女生占40%,男生只穿裤子,女生有一半穿裤子,一半穿裙子
正向概率问题
随机选一个学生,穿长裤的概率是多少,穿裙子的概率是多少
逆向概率问题
随机选一个学生,只能看见穿的是长裤,但不知道性别,需要推断出该学生是女生的概率?
解答:
穿裤子是女生的概率 = 学校女生的概率 * 女生中穿裤子的概率 / 学校中穿裤子的概率
公式如下:
P(女生|穿裤子) = P(女生) * P(穿裤子|女生) / P(穿裤子)
分布求解:
学校女生的概率是0.4女生中穿裤子的概率是0.5学校中穿裤子的概率 = 男生穿裤子的概率 + 女生穿裤子的概率男生穿裤子的概率是0.6(学校男生的概率) * 1(男生中穿裤子的概率,男生都穿裤子) = 0.6女生穿裤子的概率是0.4(学校女生的概率) * 0.5(女生中穿裤子的概率) = 0.2
带入公式:
0.4(学校女生的概率) * 0.5(女生中穿裤子的概率) / ( 0.6(男生穿裤子的概率) + 0.2(女生穿裤子的概率) )
公式
将上面例子的公式:
P(女生|穿裤子) = P(女生) * P(穿裤子|女生) / P(穿裤子)
简化如下:
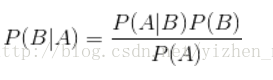
换成分类任务的表达式:
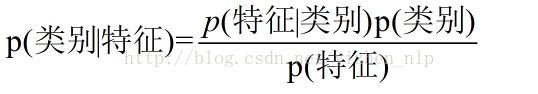
最终求 p(类别|特征)
例子
男生想女生求婚,男生有四个特征,与女孩嫁不嫁相关,这四个特征是:
- 颜值:不帅、帅
- 性格:不好、好
- 个子:高、矮
- 上进:不上进、上进
目前有以下数据:

当某男生的特征是:不帅、性格不好、个子矮、不上进,计算出:女生嫁给他的概率
分析
这是分类问题,而且是二分类,女生 “嫁”、“不嫁”
男生的四个特征之间,是 相互独立 的,彼此互不影响
通过上述分析,可以通过 朴素贝叶斯 计算分类的概率
转为朴素贝叶斯问题就是,计算 p(嫁|(不帅、性格不好、身高矮、不上进)) 与 p(嫁|(帅、性格好、个子高、上进)) 的概率
带入到朴素贝叶斯公式:
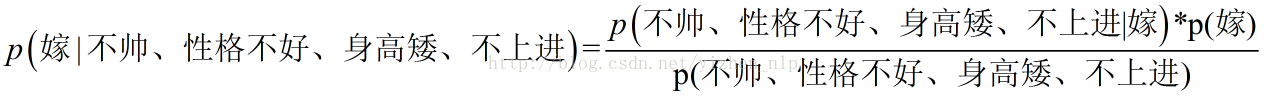
由此,我们将 (嫁|不帅、性格不好、矮、不上进) 转换成三个可求的值:
P(嫁)P(不帅、性格不好、矮、不上进|嫁)P(不帅、性格不好、矮、不上进)
进一步分解可以得:
P(不帅、性格不好、矮、不上进|嫁) = P(不帅|嫁)P(性格不好|嫁)P(矮|嫁)P(不上进|嫁)
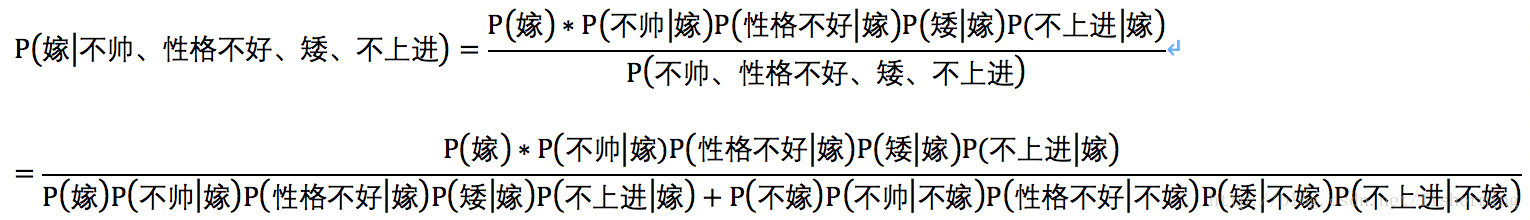
P(不帅、性格不好、矮、不上进) = P(嫁)P(不帅|嫁)P(性格不好|嫁)P(矮|嫁)P(不上进|嫁)+P(不嫁)P(不帅|不嫁)P(性格不好|不嫁)P(矮|不嫁)P(不上进|不嫁)
将上面的公式整理一下可得:
计算 p(嫁)
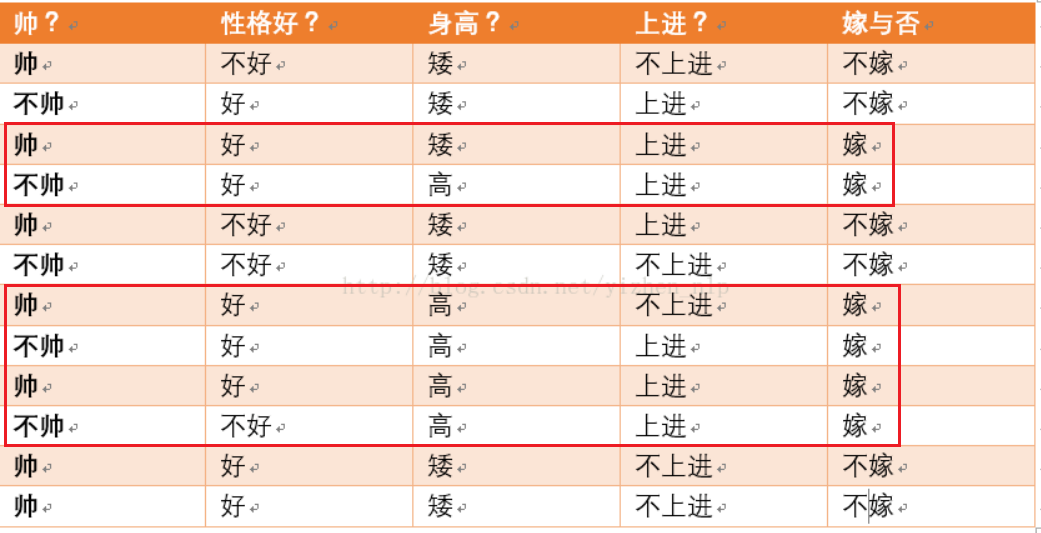
p(嫁) = 6 (嫁的数量) /12(总共数据量) = 1/2
计算 p(不帅|嫁)
p(不帅|嫁) 的含义:在嫁的情况下,不帅有多少
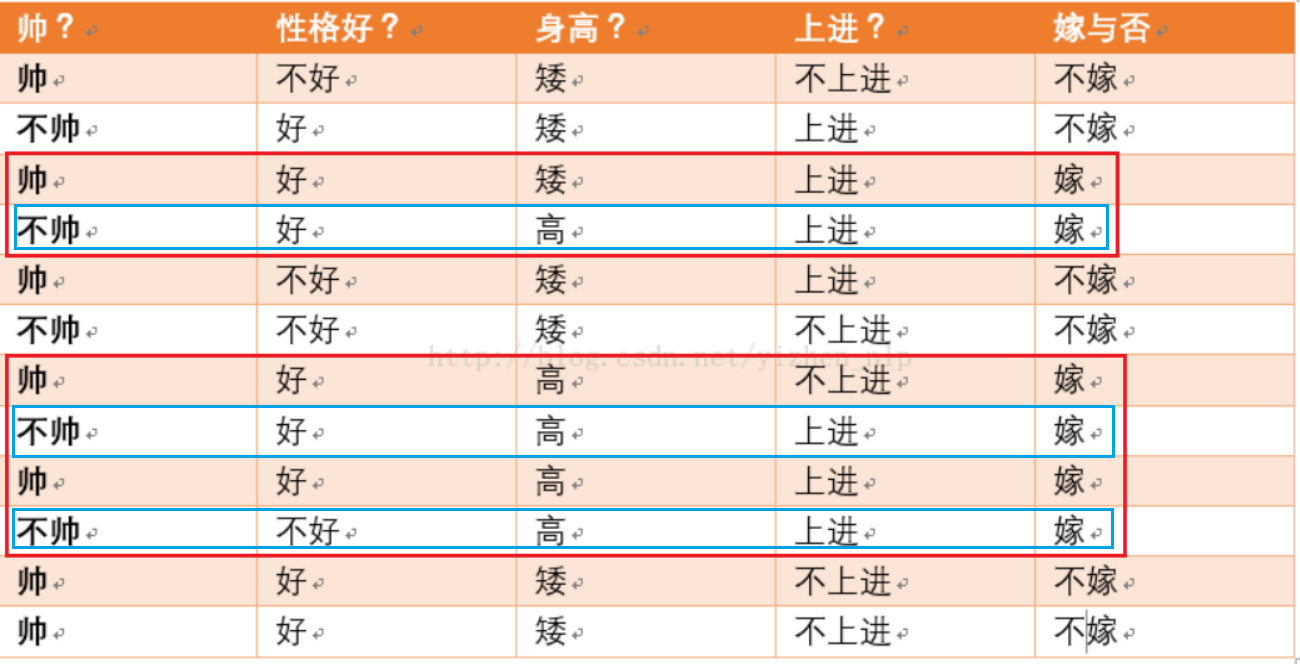
p(不帅|嫁) = 3 (嫁的情况下,不帅的数量) / 6(嫁的数量) = 1/2
计算 p(性格不好|嫁)
p(性格不好|嫁) 的含义:在嫁的情况下,性格不好有多少
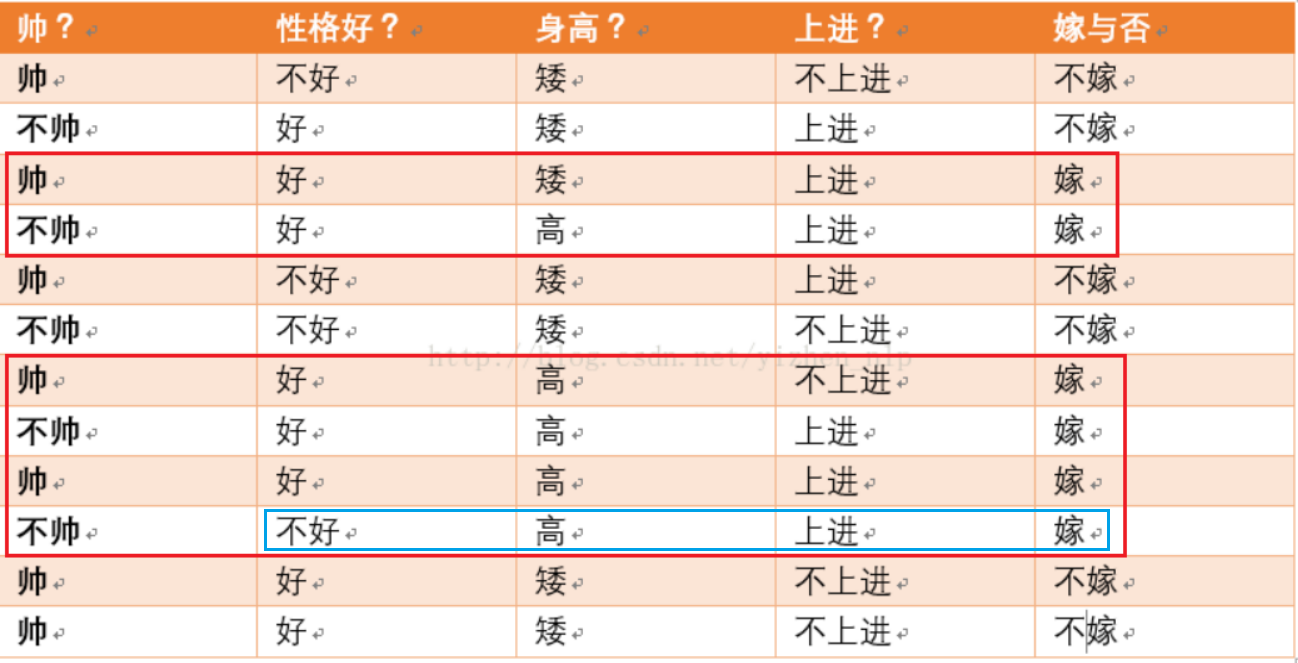
p(性格不好|嫁) = 1 (嫁的情况下,性格不好的数量) / 6(嫁的数量) = 1/6
计算 p(矮|嫁)
p(矮|嫁)的含义:在嫁的情况下,个子矮的有多少
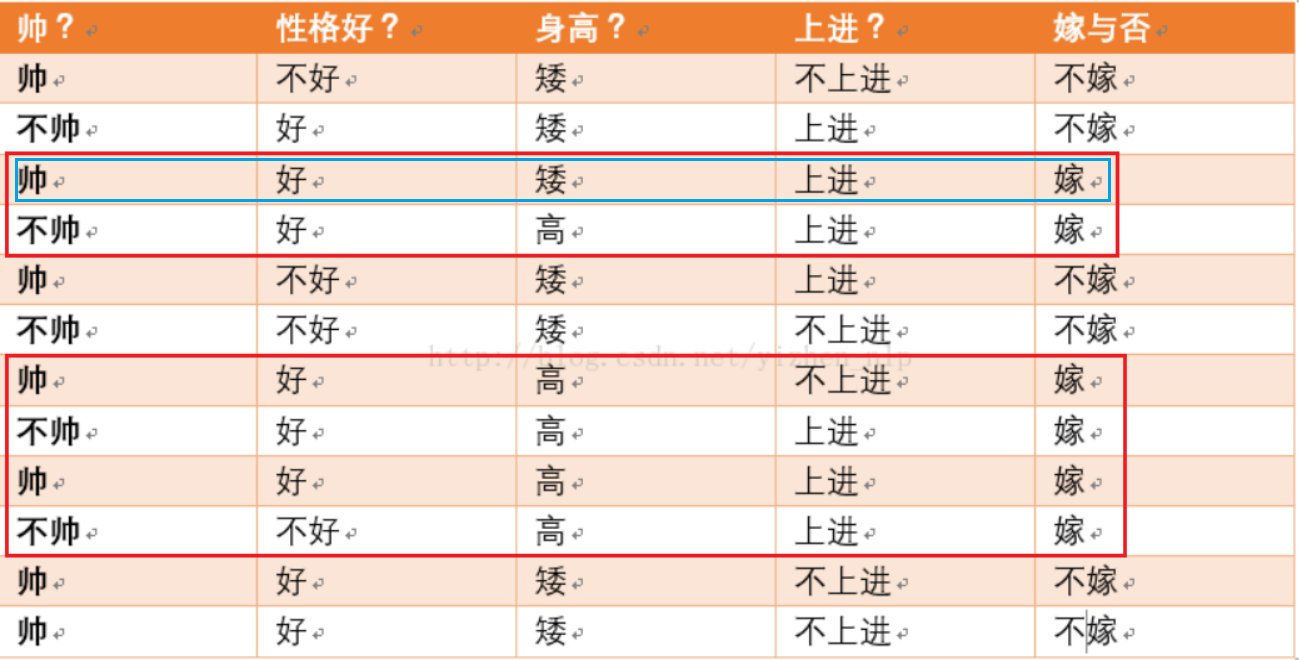
p(矮|嫁) = 1 (嫁的情况下,个子矮的数量) / 6(嫁的数量) = 1/6
计算 p(不上进|嫁)
p(不上进|嫁)的含义:在嫁的情况下,不上进的有多少
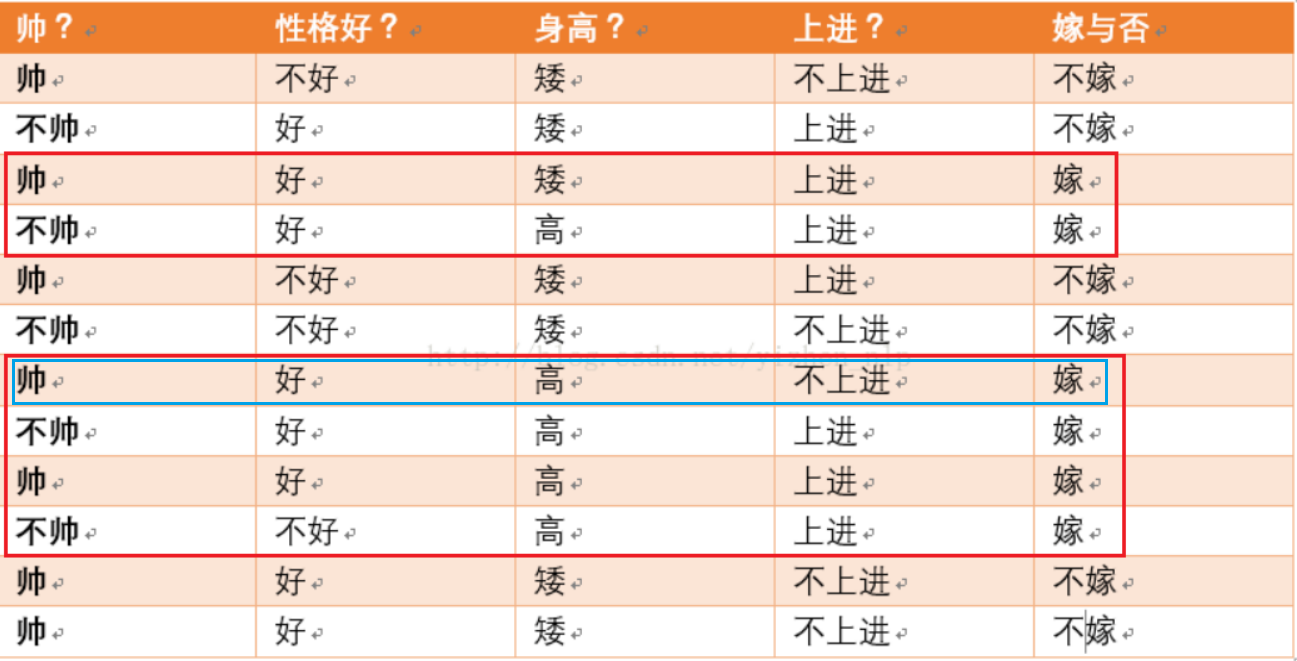
p(不上进|嫁) = 1 (嫁的情况下,不上进的数量) / 6(嫁的数量) = 1/6
计算 p(不嫁)
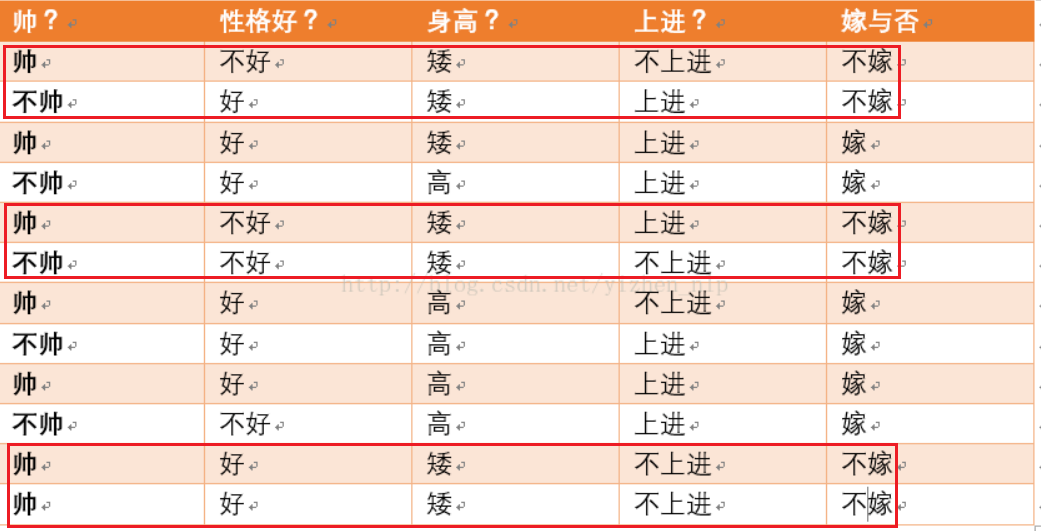
p(不嫁) = 6 (不嫁的数量) /12(总共数据量) = 1/2
计算 p(不帅|不嫁)
p(不帅|不嫁) 的含义:在不嫁的情况下,不帅有多少
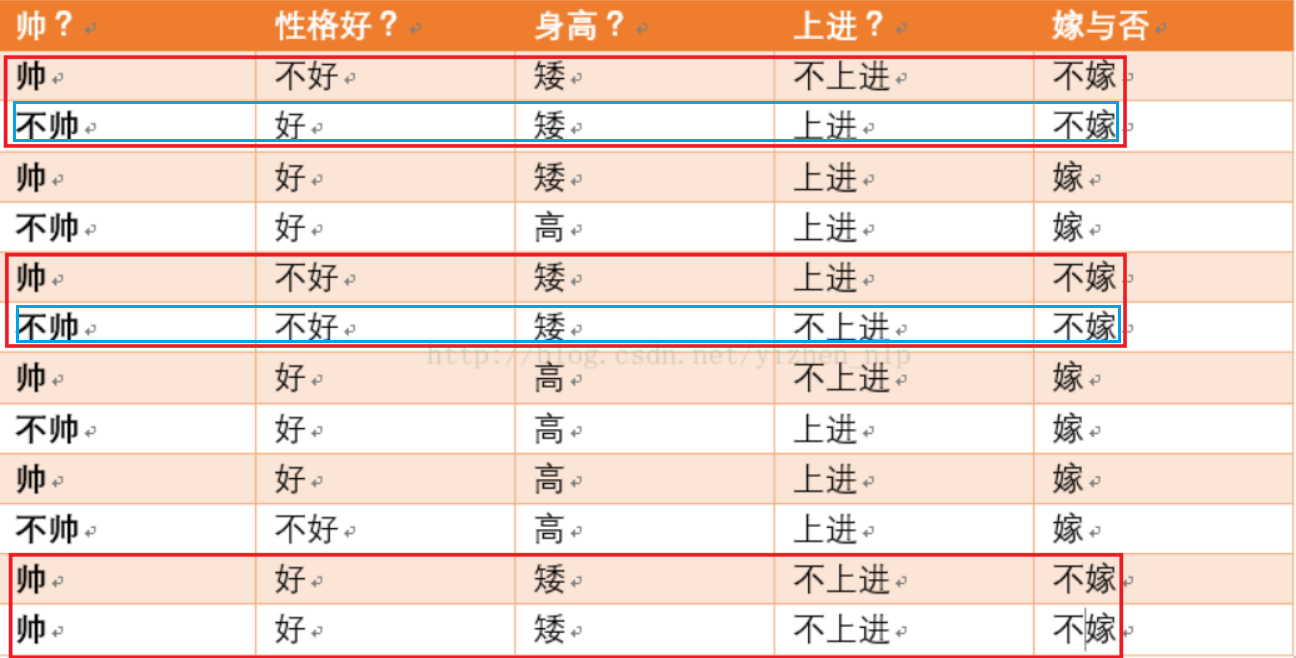
p(不帅|不嫁) = 2 (不嫁的情况下,不帅的数量) / 6(嫁的数量) = 1/3
计算 p(性格不好|不嫁)
p(性格不好|不嫁) 的含义:在不嫁的情况下,性格不好的有多少
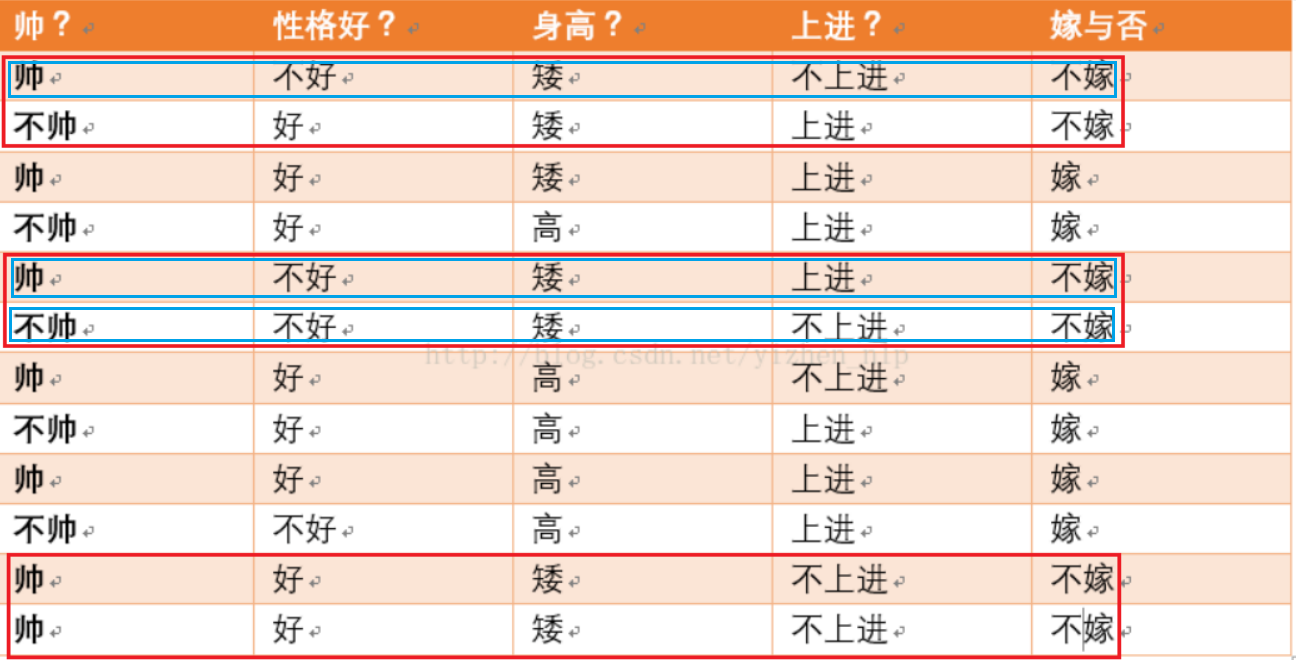
p(性格不好|不嫁) = 3 (不嫁的情况下,性格不好的数量) / 6(嫁的数量) = 1/2
计算 p(矮|不嫁)
p(矮|不嫁) 的含义:在不嫁的情况下,个子矮的有多少
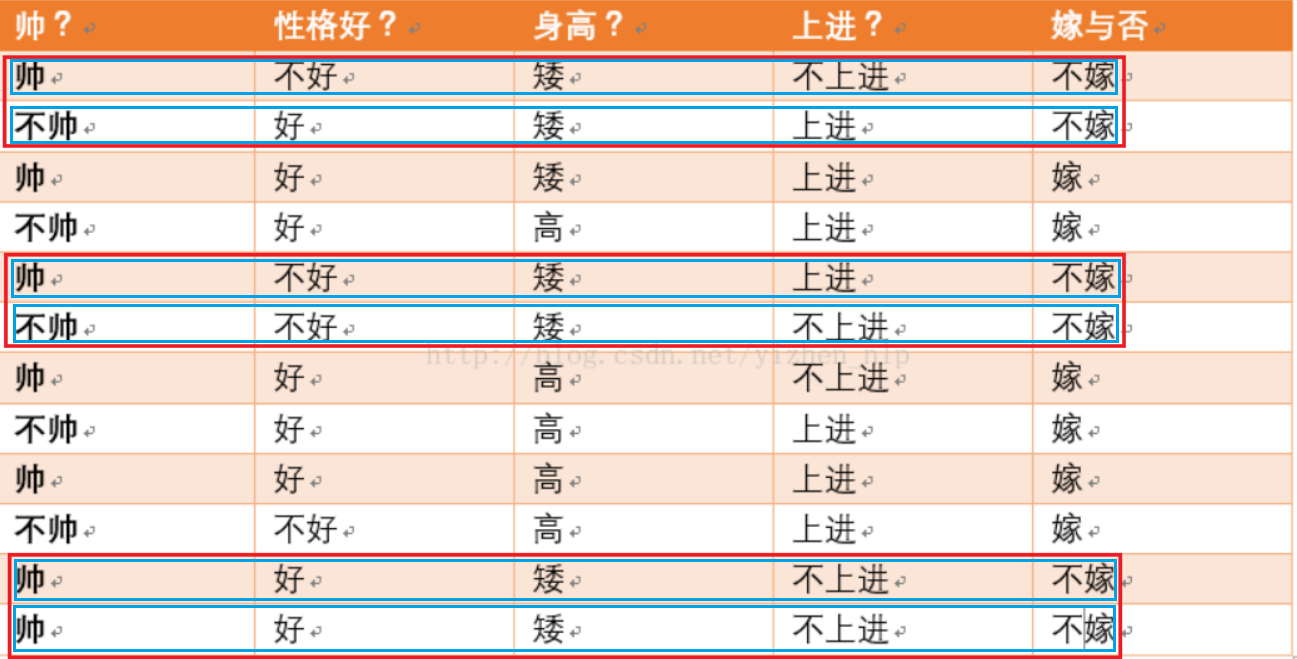
p(矮|不嫁) = 6 (不嫁的情况下,个子矮的数量) / 6(嫁的数量) = 1
计算 p(不上进|不嫁)
p(不上进|不嫁) 的含义:在不嫁的情况下,不上进的有多少
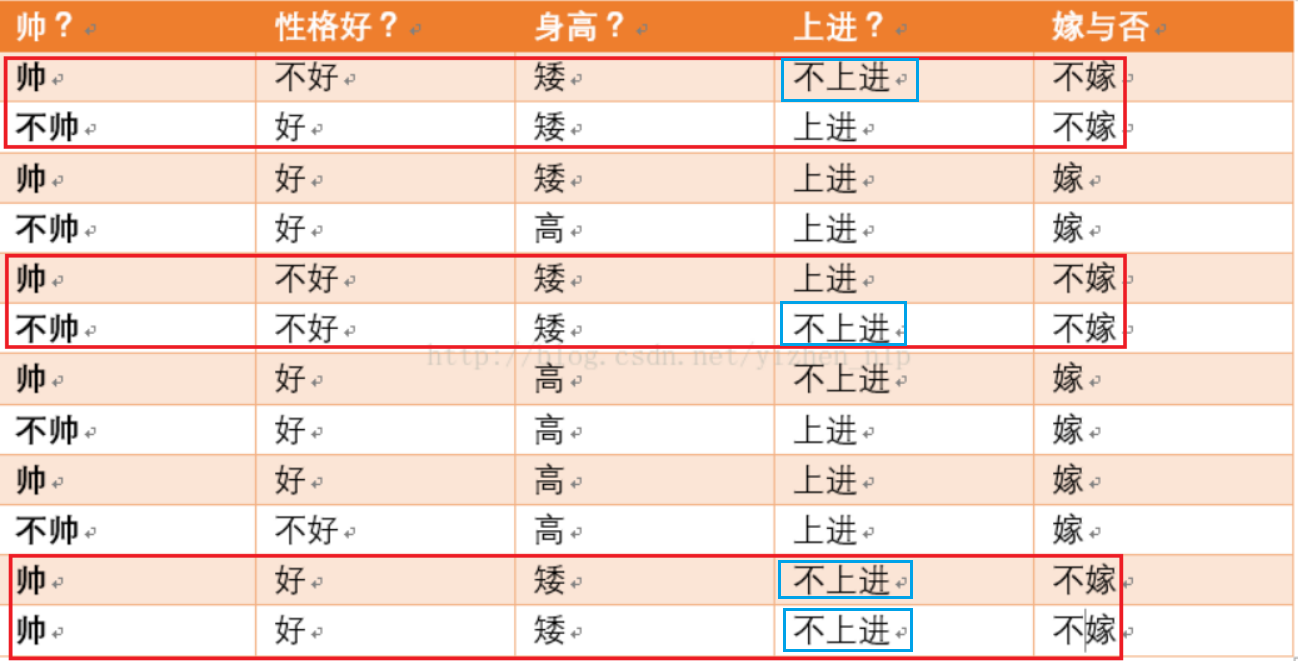
p(不上进|不嫁) = 4 (不嫁的情况下,不上进的数量) / 6(嫁的数量) = 2/3
计算 P(不帅、性格不好、矮、不上进)
通过上面分析可知:
P(不帅、性格不好、矮、不上进)
= P(嫁)P(不帅|嫁)P(性格不好|嫁)P(矮|嫁)P(不上进|嫁)+P(不嫁)P(不帅|不嫁)P(性格不好|不嫁)P(矮|不嫁)P(不上进|不嫁)
= 1/2 * 1/2 * 1/6 * 1/6 * 1/6 + 1/2 * 1/3 * 1/2 * 1* 2/3
= 1/864 + 1/18
带入贝叶斯公式
李雷的特征:不帅、性格不好、个子矮、不上进,女生嫁给他的概率:
P(嫁|不帅、性格不好、矮、不上进)=(1/864) / (1/864+1/18)=1/49=2.04%
优缺点
优点
- 算法逻辑简单,易于实现(算法思路很简单,只要使用贝叶斯公式转化即可!)
- 分类过程中时空开销小(假设特征相互独立,只会涉及到二维存储)
缺点
朴素贝叶斯假设属性之间相互独立,这种假设在实际过程中往往是不成立的。在属性之间相关性越大,分类误差也就越大。
参考:
https://blog.csdn.net/fisherming/article/details/79509025
https://blog.csdn.net/AMDS123/article/details/70173402
http://c.biancheng.net/ml_alg/sklearn-bayes.html