概述
输入值 与 输出值 均为 连续值 ,这种预测就是 线性回归 问题
线性回归是机器学习、深度学习中最重要的算法
回归的起源参见
https://www.malaoshi.top/show_1EF3kBEIOzFX.html
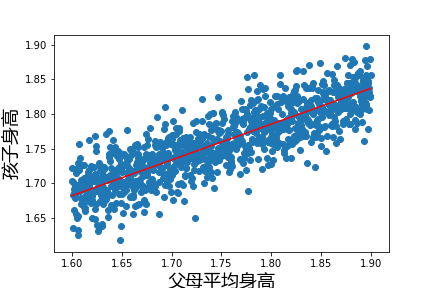
由上文可知规律是:y= 0.516*x+0.8567 (单位为米)
案例:父母平均身高和孩子身高
写成公式:y=kx+b,此公式也是 直线方程 的 斜截式 ,k 是直线的 斜率,b 是直线在y轴上的 截距,所以将这种回归称之为: 线性回归
如下图,x坐标是父母平均身高 , y坐标孩子身高,通过散点图明显可知是 直线关系
一般将公式:y=kx+b,写为:y=wx+b,w是weight缩写,表示 权重,b是bias,表示 偏置量
线性回归预测
同高尔顿,是知道若干 父母平均身高 和 孩子身高,并从这些数据中,总结出规律,即找到最佳的 权重 和 偏置量:
即公式y= 0.516*x+0.8567 (单位为米) 中的权重:0.516,偏置量:0.8567
找到 最佳 权重 、偏置量 后,根据此规律进行预测
一元线性回归
像这种:y=wx+b,只有一个变量的,称之为:一元线性回归
多元线性回归
案例:追女神的成功率
要追女神,首先得了解喜欢什么样的人,假设我们做调查,让女神给颜值高和打篮球的男生打分,得到100个样本,得出以下规律:
- 颜值越高的男生,小姐姐越喜欢,成直线关系
- 打篮球越好的男生,小姐姐越喜欢,成直线关系
但是还不知道这两项的 权重 和 偏置量 ,我们要通过线性回归找到最佳的 权重 和 偏置量,才能做到精准预测
整理成公式
将上面的样本整理成公式:
y=w1x1+w2x2+b
其中:
- x1:表示颜值分数
- w1:表示颜值的权重
- x2:表示会打篮球的分数
- w2:表示打篮球的权重
- b:表示偏置量
- y:表示总分
图像
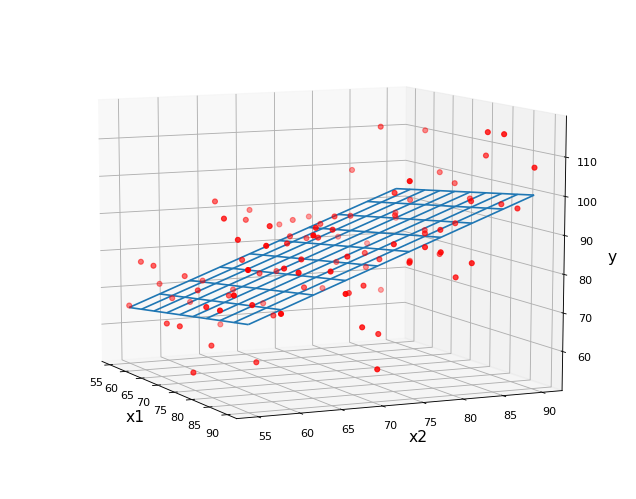
如下图:上面公式有3个变量,所以是三维图像:
- y轴:表示小姐姐喜欢的程度,
- x1轴:表示男生颜值的高低程度,
- x2轴:表示打篮球的好坏程度,
- 蓝色平面:表示从这些点找到的规律
多元线性回归
像这种:y=w1x1+w2x2+w3x3+....+wnxn+b,有多个变量的,称之为:多元线性回归
为了让上面公式 统一,通常将b写成w0*1,也就是说 将偏置量b 当成 权重w0,上面公式改为如下:
y=w1x1+w2x2+w3x3+....+wnxn+w0*1
线性回归能解决的问题
当 目标值 是连续的,并且 特征 与 目标值 是 直线关系 ,都可以预测
如贷款额度、房价预测、投放广告销售预测
回归与分类的区别:
分类,是当 目标值 是离散的,一般用 分类算法 进行预测。如人脸识别
总结
- 线性回归只能解决 线性关系 模型
- 线性回归就是求出最佳的 权重 和 偏置量
案例:大学成绩(废弃)
有些大学的某些课程,分数并不是期末成绩,而是由多个考核得出的,比如:
- 出勤分,满分100,占总成绩的20%:
分数=100*20% - 期末考试分,满分100,占总成绩的80%:
分数=100*80%
总分:总分=100*20%+100*80%+10,此处的10是偏置量,比如平时表现等
写成公式:y=w1x1+w2x2+b
打分
打分时,是知道每个学生的 出勤率、期末考试分,然后分别乘以 权重,再加上 偏置量,得出总分
线性回归预测
与打分不同,线性回归预测 是知道 若干学生 的 出勤率、期末考试分,和 总分,但是 不知道 权重 和 偏置量,通过回归算法,找到最接近 真实的 权重 和 偏置量
如下图,类似上面的 父母身高和孩子身高图像,但学生成绩有3个变量,所以是三维图像,红点表示学生的成绩,蓝色平面表示从这些点找到的规律,也就是最佳的w1、w2、b: