概述
Advertising.csv数据集有200行,共4列:
- 第一列:电视广告投放量
- 第二列:广播广告投放量
- 第三列:报纸广告投放量
- 第四列:销售额
本文以此数据集来实现多层感机,感性的理解多层感知机的实现
代码实现
numpy读取数据
跳过第一行表头;只读取索引是1、2、3、4的列(索引是0的列,是序号)
import numpy
import matplotlib.pyplot as plt

arr=numpy.loadtxt(r'C:\Users\mym\Desktop\数据集\Advertising.csv', delimiter=',', skiprows=1,usecols=(1,2,3,4))
print(arr[:50])
执行结果:
[[230.1  37.8  69.2  22.1]
 [ 44.5  39.3  45.1  10.4]
 [ 17.2  45.9  69.3   9.3]
 [151.5  41.3  58.5  18.5]
 [180.8  10.8  58.4  12.9]
 [  8.7  48.9  75.    7.2]
 [ 57.5  32.8  23.5  11.8]
 [120.2  19.6  11.6  13.2]
 [  8.6   2.1   1.    4.8]
 [199.8   2.6  21.2  10.6]]
电视广告投放量与销售额的关系
plt.scatter(arr[:,0],arr[:,3])
plt.show()
执行如下图,可知是线性关系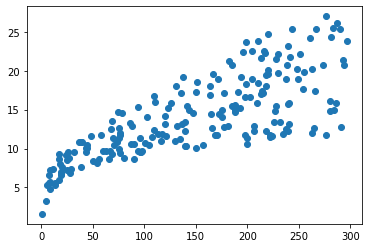
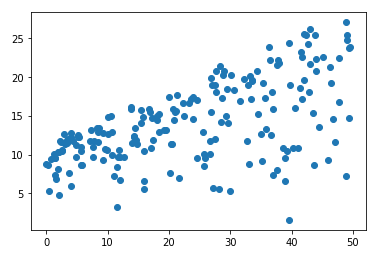
广播广告投放量与销售额的关系
plt.scatter(arr[:,1],arr[:,3])
执行如下图,可知是线性关系(不是很明显)
报纸广告投放量与销售额的关系
plt.scatter(arr[:,2],arr[:,3])
执行如下图,可知报纸广告投放量与销售额的关系 不大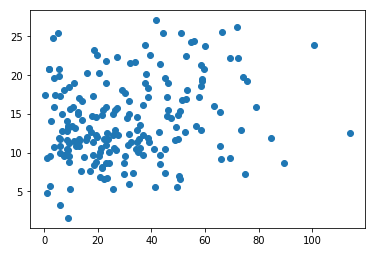
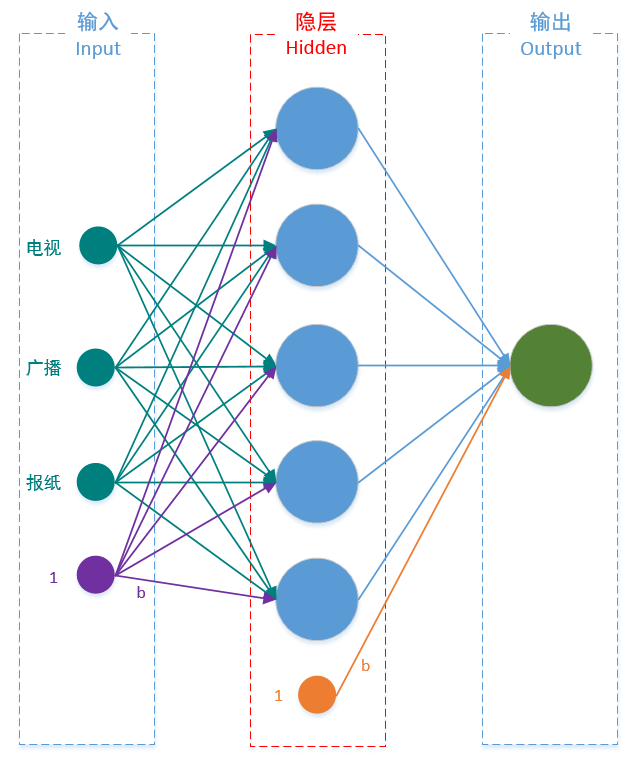
建立模型
import tensorflow as tf
'''
添加输入层:要指定输出数量(感知机的数量)、输入的形状、激活函数
添加输出层:指定输出数量
'''
model=tf.keras.Sequential([tf.keras.layers.Dense(5,input_shape=(3,),activation='relu'),
                          tf.keras.layers.Dense(1)])
# 显示摘要信息
model.summary()
执行结果如下:
Model: "sequential_6"
_________________________________________________________________
Layer (type)                 Output Shape              Param #
=================================================================
dense (Dense)             (None, 5)                 20
_________________________________________________________________
dense_1 (Dense)             (None, 1)                 6
=================================================================
Total params: 26
Trainable params: 26
Non-trainable params: 0
_________________________________________________________________
注意:
- 第一层的参数数量是20,因为
(3个特征值+1个b)*5个感知器 - 第二层的参数数量是6,因为
5个感知器的输出值+1个b
开始训练
# 指定梯度下降,损失函数是均方误差
model.compile(optimizer='adam',loss='mse')
# 取出前140行数据进行训练,训练500次
model.fit(x[0:140],y[0:140],epochs=500)
执行结果:
Epoch 1/500
200/200 [==============================] - 0s 595us/sample - loss: 2.9748
Epoch 2/500
200/200 [==============================] - 0s 70us/sample - loss: 2.9321
Epoch 3/500
200/200 [==============================] - 0s 80us/sample - loss: 2.9211

.....................................................

Epoch 498/500
200/200 [==============================] - 0s 65us/sample - loss: 0.8194
Epoch 499/500
200/200 [==============================] - 0s 65us/sample - loss: 0.8184
Epoch 500/500
200/200 [==============================] - 0s 70us/sample - loss: 0.8127
测试预测能力
取出 原数据 特征值 的140-200行记录,进行预测目标值
prd=model.predict(x[140:]).reshape(60,)
print(prd)
将 预测 目标值 与 原数据 目标值 做比较,看准确率
print(y[140:]-prd)