概述
之前用于深度学习的经典案例是 MNIST数据集,是 手写数字 图像
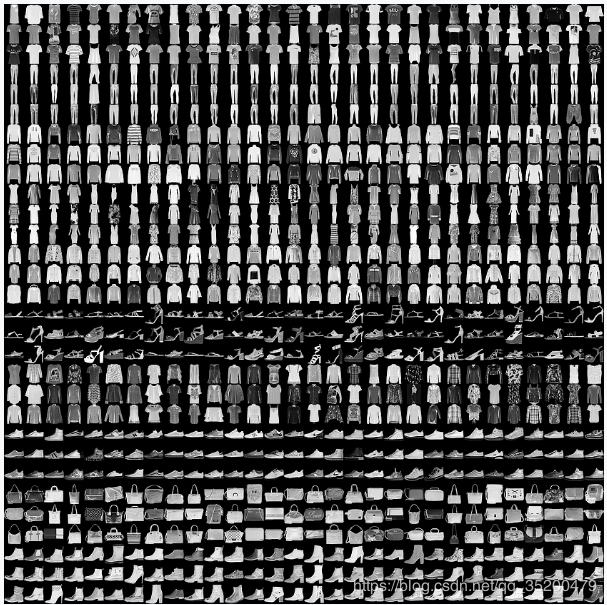
Fashion MNIST 数据集 是 服饰图像,更有挑战性, 是替换 MNIST数据集的
两者格式完全相同
常用于验证某个算法能否正常运行
数据说明
图像
包含 70000 张 灰度 图像
图像是一个28*28的像素数组,每个像素的值为0~255之间的8位无符号整数(uint8)
类别
共有 10个类别
| 编号 | 分类 | 中文 |
|---|---|---|
| 0 | T-shirt/top | T恤 |
| 1 | Trouser | 裤子 |
| 2 | Pullover | 套头衫 |
| 3 | Dress | 连衣裙 |
| 4 | Coat | 外衣 |
| 5 | Sandal | 凉鞋 |
| 6 | Shirt | 衬衫 |
| 7 | Sneaker | 运动鞋 |
| 8 | Bag | 包 |
| 9 | Ankle boot | 短靴 |
获取数据
方式一(不推荐)
通过代码下载(这种下载基本失败),如下
import tensorflow as tf

(train_image,train_label),(test_image,test_label)=tf.keras.datasets.fashion_mnist.load_data()
第一次执行时自动到服务器下载,但下载速度较慢,下载成功后,以后再执行,就不会下载了
方式二(推荐)
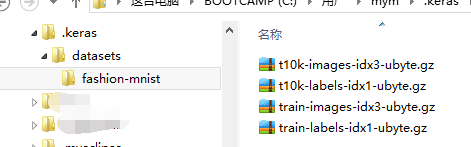
事先下载,下载后放入到指定目录下:
windows系统 放到下面目录:
C:\Users\当前用户名\.keras\datasets如下图:
macOS系统 放到下面目录:
~/.keras/datasets
再执行下面代码时,就可以直接使用,不再下载,如下:
import tensorflow as tf

(train_image,train_label),(test_image,test_label)=tf.keras.datasets.fashion_mnist.load_data()
代码
加载数据
import tensorflow as tf

(train_image,train_label),(test_image,test_label)=tf.keras.datasets.fashion_mnist.load_data()
其中 训练 数据有 60000 张图像,测试 数据有 10000 张图像
查看图像数据形状
# 查看形状
print(train_image.shape)

print(test_image.shape)
结果:
(60000, 28, 28)
(10000, 28, 28)
训练数据 有60000个,图像是 28宽 28高,也就是说每个图像有28*28=784个特征
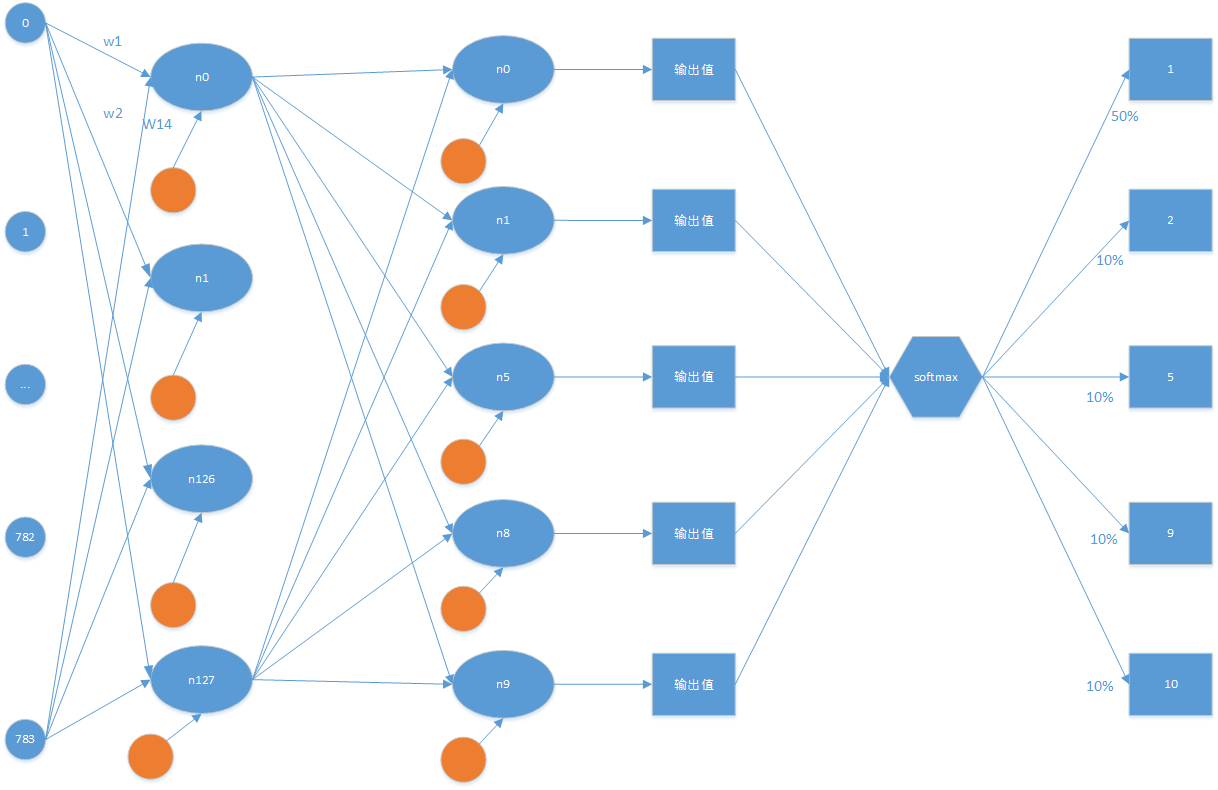
也就是说,在神经网络模型中,输入值 共有 784 个
测试数据 有10000个,图像是 28宽 28高
显示图像
通过matplotlib显示图像
# 显示第一张图像
import matplotlib.pyplot as plt
plt.imshow(train_image[0])
显示如下,图片会变大,并且会有颜色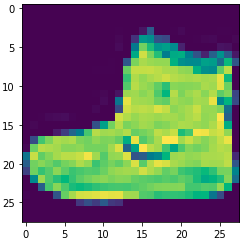
使用PIL库显示真实的图片:
from PIL import Image

Image.fromarray(train_image[0])
显示如下:
分析图像数据
print(train_image[0].shape)
# 查看最大值
np.max(train_image[0])
图像数据,是0-255之间的RGB值
查看类别数据形状
print(train_label.shape)

print(test_label.shape)
执行结果:
(60000,)
(10000,)
分析类别数据
train_label
类别是数字,每个数字对应一个类别,上面有对应表格,共有10个类别
也就是说,在神经网络模型中,输出层 有 10个 感知机(神经元)
★★ 图像数据 归一化(重要)
归一化参见:
https://www.malaoshi.top/show_1EF44SFFqg9G.html
将图像0-255的RGB转换成0-1的数据
train_image=train_image/255
test_image=test_image/255

train_image[0]
建立模型
model=tf.keras.Sequential()

# 图像数据是二维数据,需要将二维数据转换成一维数据
model.add(tf.keras.layers.Flatten(input_shape=(28,28)))
# 数量不能太少,会欠拟合,也不能太多,会过拟合
model.add(tf.keras.layers.Dense(128,activation='relu'))
# 10个分类,softmax的作用就是将10个输出值变成概率值,这些概率值之和为1
model.add(tf.keras.layers.Dense(10,activation='softmax'))

model.summary()
softmax激活函数参见:
https://www.malaoshi.top/show_1EF43MehJmCw.html
配置训练模型
由于目标值 分类 是 序号 (0-9之间),所以使用 sparse_categorical_crossentropy 损失函数
model.compile(optimizer='adam',loss='sparse_categorical_crossentropy',metrics=['acc'])
损失函数参见:
https://www.malaoshi.top/show_1EF4La0KENhc.html
开始训练
model.fit(train_image,train_label,epochs=5)
评估模型
评估模型,就是预测训练数据,将预测结果与真实结果做比对,并计算出正确率
model.evaluate(test_image,test_label)
进行预测
通过模型预测训练数据
prd_label=model.predict(test_image)
查看预测结果
prd_label.shape
执行结果是
(10000, 10)
10000个图片,对应预测结果10000行,但是为什么是10列?
查看第一行记录
prd_label[0]
结果如下:
array([1.5847332e-05, 1.1821714e-07, 4.4911198e-07, 2.4028379e-06,
       2.4881649e-08, 1.4185666e-03, 7.7166405e-05, 3.2755506e-01,
       1.9131189e-04, 6.7073911e-01], dtype=float32)
将第一行的结果求和:
np.sum(prd_label[0])
结果是
1
说明这每行10列的结果,是 softmax激活函数 的结果,10列对应10个结果的概率,这10个概率相加,正好等于1
分析预测结果
这里需要用到tf.argmax()函数,参见
https://www.malaoshi.top/show_1EF4LCNXBuQr.html
# 预测结果是长度为10的数组,分别表示各个类别的概率,其和是1
print(prd_label[0])
# 获取最大概率的索引
label_num=tf.argmax(prd_label[0])
print(type(label_num))
label_num=int(label_num)
print(type(label_num))
print(label_num,test_label[0])
显示预测结果,并计算预测准确率,看与评估结果是否一致
# 显示预测结果,并计算预测准确率,看与评估结果是否一致
prd_label=np.argmax(prd_label,axis=1)

error_num=0
for item in range(len(prd_label2)):
    if int(prd_label2[item])!=test_label[item]:
        error_num+=1

print('错误总数:',error_num)
print('正确率:',1-error_num/10000)