概述
本文介绍逻辑回归的前向传播,也叫正向传播
一句话解释:将神经网络正向走一遍
输入层—->隐藏层—->输出层
案例
为了便于观察,这里建立2个全连接层,1层有4个神经元,2层有1个神经元,激活函数时sigmoid,如下图:

样本demo如下:
| 特征x1(父母平均身高) | 孩子是否超过1.8 | |
|---|---|---|
| 样本1 | 1.7 | 0 |
| 样本2 | 1.8 | 1 |
| 样本3 | 1.9 | 1 |
计算第1层
这里主要讲解 h1 的计算
初始化权重和偏置量
在keras中的全连接网络中:
- 权重 默认初始化的方式是 随机的
- 偏置量 默认为0
为了方便计算,手动设置 权重和偏置量,如下
| 权重 w1 | 偏置量 b1 |
|---|---|
| 0.1 | 0 |
注意:
运算后的结果 与 样本真实值 会有误差
计算公式
h1结果=x1*w1+b1
x表示特征,即父母平均身高
偏置量b1的转换
为了让公式更加统一,将 b1 理解成 x0*w1_0,如下:
h1结果=x0*w1_0+x1*w1_1
注意:
- x0永远为1
- 在初始化时,b1值是0,x0永远为1,所以此时w0是0
- 特征多了一个
转成矩阵运算(3个样本,神经元h1)
由于有很多个样本,用循环计算复杂,通过 矩阵 计算更加简单,转换公式如下:

注意:
- 样本矩阵,行是样本,列是特征
- 样本中的特征只有1个,但将偏置量b理解成
x0*w1_0,所以 特征多了一个
转成矩阵运算(3个样本,神经元h1 h2 h3 h4)

最终结果如下
代入3个样本,4个神经元,最终结果如下:
第1行的4列是样本1.7 与 4个神经元运算的结果
第2行的4列是样本1.8 与 4个神经元运算的结果
第3行的4列是样本1.9 与 4个神经元运算的结果
keras 代码验证
上述是理论,接下来我们要通过keras代码,查看输出的结果
实现思路,建立好模型后,需要手动设置权重为0.1,直接调用predict()方法进行预测,就会以权重(0.1)和偏置量(0)进行计算
import tensorflow as tf
import numpy as np

x=[1.7,1.8,1.9]

model=tf.keras.Sequential()
model.add(tf.keras.layers.Dense(4,input_shape=(1,),kernel_initializer=tf.initializers.Constant(0.1)))
model.summary()

out_result = model.predict(x)
out_result
执行结果如下:
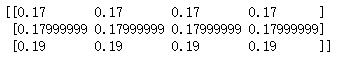
[[0.17       0.17       0.17       0.17      ]
 [0.17999999 0.17999999 0.17999999 0.17999999]
 [0.19       0.19       0.19       0.19      ]]
numpy 代码验证
import numpy as np
import math

x=np.array([
    [1,1.7],
    [1,1.8],
    [1,1.9]
])

w=np.array([
    [0,0,0,0],
    [0.1,0.1,0.1,0.1],
])


result=x.dot(w)
执行结果如下:
[[0.17 0.17 0.17 0.17]
 [0.18 0.18 0.18 0.18]
 [0.19 0.19 0.19 0.19]]
计算第2层
第2层只有一个神经元,分成2个步骤进行运算
初始化权重和偏置量
同上,为了方便计算,手动设置 权重 和 偏置量,如下
| 权重 w5_1 | 权重 w5_2 | 权重 w5_3 | 权重 w5_4 | 偏置量 b5 |
|---|---|---|---|---|
| 0.1 | 0.1 | 0.1 | 0.1 | 0 |
注意:
运算后的结果 与 样本真实值 会有误差
计算步骤1
以样本1为例,样本1 经过 第1层 的 4个神经元 计算后,得到4个结果,将这 4个结果作为特征,进行第2层的计算
公式如下:
h1*w5_1+h2*w5_2+h3*w5_3+h4*w5_4+b5
为了让公式更加统一,将 b5 理解成 h0*w5_0,如下:
h0*w5_0+h1*w5_1+h2*w5_2+h3*w5_3+h4*w5_4
注意:
- h0永远为1
- 在初始化时,b5值是0,h0永远为1,所以此时 w5_0是0
- 特征多了一个
计算步骤1 - 转成矩阵运算(1个样本)
用循环计算复杂,通过 矩阵 计算更加简单,如下:
计算步骤1 - 转成矩阵运算(3个样本)
由于有很 多个样本,用循环计算复杂,通过 矩阵 计算更加简单,如下:
注意:
- 第一个矩阵是 第1层 的输出结果,行是样本,列是1个样本在4个神经元的计算结果
计算步骤1 - 结果如下
array([[0.068],
       [0.072],
       [0.076]])
计算步骤2 - sigmoid
计算步骤1的结果,是线性计算的结果,范围是 负无穷 到 正无穷。
为了实现分类,就需要对这个结果再次进行计算,将范围 映射到 0-1之间。
这样,大于等于0.5(即 50%)的,就认为是1,小于等于0.5(即 50%)的,就认为是0,这样就实现了二分类
计算公式:
x表示 上一步骤 的结果
将上一步骤的样本1结果0.068,代入公式,结果:0.516993452360945
样本2的结果0.072,代入公式,结果:0.5179922280289649
样本3的结果0.076,代入公式,结果:0.5189908599459256
keras 代码验证
上述是理论,接下来我们要通过keras代码,查看输出的结果
实现思路,建立好模型后,需要手动设置权重为0.1,直接调用predict()方法进行预测,就会以权重(0.1)和偏置量(0)进行计算
import tensorflow as tf
import numpy as np

x=[1.7,1.8,1.9]

model=tf.keras.Sequential()
model.add(tf.keras.layers.Dense(4,input_shape=(1,),kernel_initializer=tf.initializers.Constant(0.1)))
model.add(tf.keras.layers.Dense(1,activation="sigmoid",kernel_initializer=tf.initializers.Constant(0.1)))
model.summary()

out_result = model.predict(x)
out_result
执行结果如下:
[[0.51699346]
 [0.5179922 ]
 [0.5189909 ]]
o1输出层
将h2的结果输出
[[0.51699346]
 [0.5179922 ]
 [0.5189909 ]]
numpy验证
import numpy as np
import math

h=np.array([[1,0.17, 0.17, 0.17, 0.17],
       [1,0.18, 0.18, 0.18, 0.18],
       [1,0.19, 0.19, 0.19, 0.19]])


w5=np.array([[0],[0.1],[0.1],[0.1],[0.1]])

result=h.dot(w5)
result
定义sigmoid函数
def sigmoid(x):
    return 1/(1+math.e**x)

sigmoid(result)
执行结果如下:
array([[0.51699345],
       [0.51799223],
       [0.51899086]])