概述
Batch Normalization ,简称BN,批归一化
出自论文:《Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift》
Covariate Shift 现象
早在 机器学习 时,就有 Covariate Shift 现象,起源于统计学领域的一篇文章 “Improving predictive inference under covariate shift by weighting the log-likelihood function”
机器学习过程本质就是 学习数据分布,一旦 训练数据 与 测试数据 的 分布不同,那么网络的 泛化能力 就会 大大降低,即:在训练集上训练的 模型,在测试集上不会取得好效果,这种现象就叫 “covariate shift”
为了解决此问题,将数据做归一化预处理,如:图像数据在预处理时,一般是 除以255
Internal Covariate Shift 现象
从BN论文名字可以看出,BN是用来解决“Internal Covariate Shift”问题的
对于 深度学习 这种包含 很多隐层 的网络结构,在训练过程中,经过 激活函数 运算后,分布逐渐发生 偏移 或者 变动,导致 各层参数不断变化,导致每个隐层都会面临 covariate shift 的问题。
在训练过程中,隐层的 输入分布 总是 变来变去,导致网络模型很难稳定的学规律,这就是“Internal Covariate Shift”,简称 ICS
Internal指的是深层网络的隐层,是发生在网络内部的事情。covariate shift 问题只发生在输入层
导致梯度消失
由于上述问题,使得各隐层的分布,逐渐靠近 激活函数 的上下限,导致反向传播时低层神经网络的 梯度消失,这是深层神经网络训练收敛越来越慢的原因
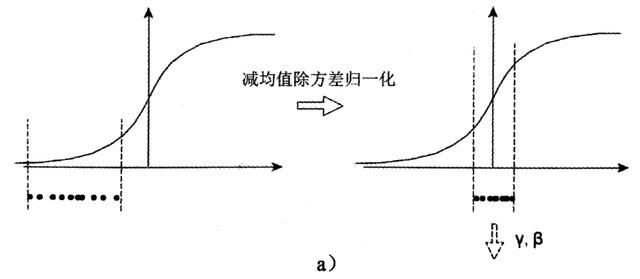
如:当激活函数是sigmoid时,数据分布在两侧时,梯度下降就会很慢,甚至梯度消失,如下图
Batch Normalization
为了解决 “Internal Covariate Shift” 问题,提出 Batch Normalization:让每个隐层的输入分布固定下来
BN算法原理
缩放
通过算法,把隐层的 数据分布 拉回到 均值为0、方差为1 的标准正态分布
这样使得激活输入值落在非线性函数对输入比较敏感的区域,这样输入的小变化就会导致损失函数较大的变化,意思是这样让梯度变大,避免梯度消失问题产生,而且梯度变大意味着学习收敛速度快,能大大加快训练速度。
将隐层的 数据,做 normalization,即:z-score标准化
需要求出这一 batch 数据的 平均值 和 标准差
s型函数的问题
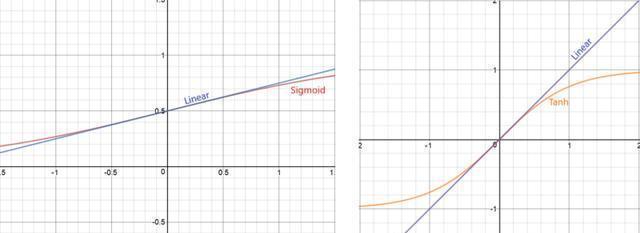
Sigmoid 函数在-1,1之间的梯度变化不大,当某一层的特征数据本身就分布在 的两侧,归一化后,标准差也限制在了1,把数据变换成分布于sigmoid函数的中间部分,此时 非线性函数 相当于 线性函数
多层的线性函数变换是没有意义的,所以没有达到非线性变换的目的,可能会削弱网络的性能。
S型激活函数 都会发生这种情况,如:tanh激活函数
位移
为了解决上面问题,对变换后 均值为0 、方差为1 的 特征数据 又进行处理,y=scale*x+shift,每个神经元增加了两个参数 scale 和 shift,这两个参数是 通过训练学习到的
意思是通过 scale 和 shift 把 特征数据 ,从标准正态分布 左移 或者 右移一点 并长胖一点或者变瘦一点,每个实例挪动的程度不一样,这样等价于非线性函数的值从正中心周围的线性区往非线性区动了动。
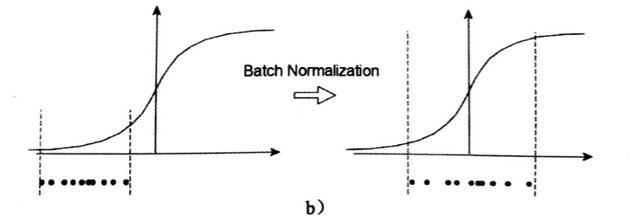
核心思想应该是想找到一个线性和非线性的较好平衡点,既能享受非线性的较强表达能力的好处,又避免太靠非线性区两头使得网络收敛速度太慢。当然,论文作者并未明确这样说。
train与inference时的差别
在训练时,我们可以计算出batch的均值和方差,迭代训练过程中,均值和方差一直在发生变化。
但是在推理时,均值和方差是固定的,它们在训练过程中就被确定下来。
《Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift》中给出的确定方式和TensorFlow中存在不同,这里我们介绍TensorFlow中的方式,即采用滑动平均MovingAverage的方法,公式为: moving_average_value * momentum + value * (1 - momentum),其中value为当前batch的平均值或方差,moving_average_value为滑动均值或滑动方差。
最终,模型训练完毕后,在推理时使用滑动平均值moving_mean和滑动方差moving_variance对feature maps进行变换。
优点
- 可以使用更大的学习速率,提高训练速度
- 初始化权重变得容易
- 防止梯度消失
支持更多的激活函数,如sigmoid
可以使用更深的神经网络 - 本身也是一种正则方式,可以代替其他正则方式,如:dropout、L2正则
缺点
Batch Normalization中的batch就是批量数据,即每一次优化时的样本数目,通常BN网络层用在卷积层后,用于重新调整数据分布。
假设神经网络某层一个batch的输入为X=[x1,x2,…,xn],其中xi代表一个样本,n为batch
当 batch 值很小时,计算的均值和方差不稳定。研究表明对于ResNet类模型在ImageNet数据集上,batch从 16 降低到 8 时,开始有非常明显的 性能下降。
所以BN不适应于当训练资源有限而无法应用较大的batch的场景。
使用
- 一般在 卷积层之后 使用。也有说在 全连接层之后 使用
- 一般在 非线性激活之前 使用,也有说在 激活之后使用 效果更好
- 在训练时training=True, 在测试时training=False
什么时候用
- 神经网络训练时遇到收敛速度很慢
- 梯度消失
- 在一般使用情况下也可以加入BN来加快训练速度,提高模型精度
keras api
https://www.malaoshi.top/show_1EF4YE1tLZ5t.html
感谢:
https://www.jianshu.com/p/437fb1a5823e
https://www.jianshu.com/p/3da70e672c8b
https://blog.csdn.net/qq_42823043/article/details/89765194
https://blog.csdn.net/weixin_41481113/article/details/83386646