需要掌握:
迁移学习Transfer Learning
预训练模型
概述
也称为:finetune, 利用 预训练模型,针对自己的任务再进行调整。
为什么需要 微调?
因为预训练模型,可能无法100%解决我们的问题:
- 可能别人的训练数据和我们的数据之间不服从同一个分布;
- 可能别人的网络能做比我们的任务更多的事情;
- 可能别人的网络比较复杂,我们的任务比较简单。
如何微调
微调一般分为以下几种:
特征提取
将预训练模型当做 特征提取 来使用
以 VGG16 模型为例,使用 卷积层(及池化层) ,提取图片的特征
全连接层 和 输出层,与 分类 有关,在自定义训练中,一般不用,所以去掉。
也就是说:将VGG16的 卷积层(及池化层),当做一个固定的特征提取机,应用到新的数据集中。

采用预训练模型的结构
使用预训练模型的结构,但将 所有的权重随机化,然后依据自己的数据集进行训练。
训练特定层,冻结其他层
进行部分的训练:将模型起始的一些层的权重保持不变,重新训练后面的层,得到新的权重。
在这个过程中,我们可以多次进行尝试,取得最佳效果
微调规律
如何微调预训练模型,是由 数据集大小 和 新旧数据集 (预训练的数据集和我们要解决问题的数据集) 相似度 来决定的。
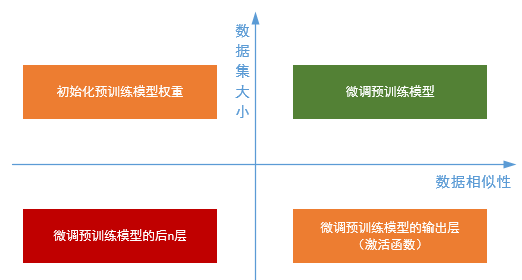
数据集小,数据相似度不高
上图红色部分,这种情况难度最大,因为深度学习,需要较多的数据进行训练,才能达到好的效果
可以 冻结 预训练模型中 前m层的权重,然后 重新训练 后面的n层
根据实际问题,决定是否修改输出层
因为数据的 相似度不高,重新训练的过程就变得非常关键。
而新数据集大小的不足,则是通过 冻结 预训练模型的 前m层进行 弥补。
数据集小,数据相似度高
上图右下角部分,这种情况,使用预处理模型作为 特征提取器
因为数据与预训练模型的训练数据 相似度很高,所以使用 自带的权重, 可能 不需要 重新训练模型。
只需要 调整输出层,解决实际问题即可。
例子:
使用在ImageNet上训练的 VGG16模型 来识别一组新照片中的小猫小狗,由于需要被识别的图片与ImageNet库中的图片类似,但是输出结果中只需要两项——猫或狗。
此时,只需要 调整 全连接层 和 输出层,从1000个类别 改为2个类别
数据集大,数据相似度不高
上图左上角部分
因为有一个很大的数据集,所以神经网络的训练过程将会比较有效率。
但是,因为实际数据与预训练模型的训练数据之间存在 很大差异,采用预训练模型 可能 不是 好方式
一般 将预处理模型中的 权重 全都 初始化(及随机权重),在新数据集的基础上重新开始训练。
数据集大,数据相似度高
上图右上角部分,最理想情况
采用预训练模型会变得非常高效。最好的运用方式是保持模型原有的结构和初始权重不变,在新数据集的基础上重新训练。
感谢:
https://blog.csdn.net/zsl091125/article/details/81413868