概述
强化学习,reinforcement learning
是 智能体 以 “试错” 的方式进行学习,与 环境 进行交互,通过反馈 (即:奖罚) 指导行为,目标是使智能体获得最大的 奖赏
由 Bellman 将其抽象为 马尔可夫决策过程 (Markov Decision Process,MDP)
案例
通过下面案例,加深理解
将无人驾驶简化成走迷宫游戏,将 城市街道 简化成下面的 迷宫,将无人驾驶想象成小汽车在迷宫里行走
标记A处是死路
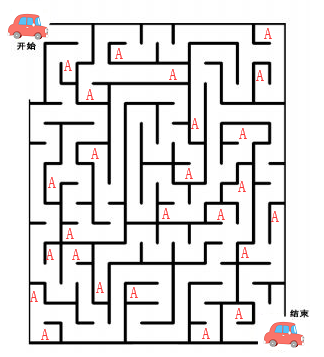
组成
- 把无人驾驶汽车称之为 智能体
- 迷宫(省略红绿灯、车道线的街道)称之为 环境
- 将无人车前进、左转、右转称之为 动作
- 无人车会走入死路、走出活路,称之为 状态
- 走入死路,会惩罚;走出活路,会奖励,称之为 奖励
- 行驶中会不断产生 奖罚,为了奖励累加,减少惩罚,组合一系列的动作,称之为 策略
当奖励最大化时,无人车会行驶到目的地
行驶过程
- 无人车在迷宫中行驶
- 不断与环境进行交互,需要探索和试错
- 走入死路,即惩罚;活路,即奖励
- 行走会影响当前奖励,也会影响后续的所有奖励
- 目标:走出迷宫,即:奖励最大化
奖励的特点
1. 延迟奖励
当前时刻 t 的状态 St ,执行动作 At, 会在下一时刻(t+1时刻)获得一个对 t 时刻的奖励: Rt+1。
如下图: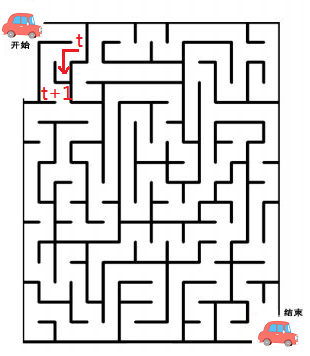
2. 最大化奖励之和
有些 动作,可以影响到好多步之后的 奖励, 因此强化学习的目标:最大化奖励之和
如下图:当小车行驶到红色箭头处时,会影响到后面n步的奖励,因为无论怎么走,都是死路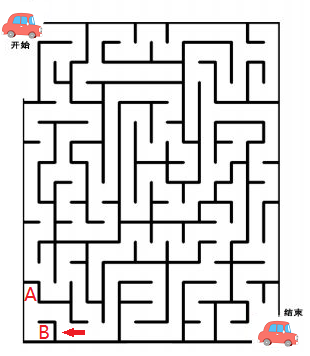
强化学习特点:
- 智能体和环境之间不断进行交互,不断试错
- 没有监督者,只有一系列的奖励
- 奖励不是及时的,而是延时的
- 算法接受的数据是有时间顺序的
- agent的动作可以对环境产生持续影响
强化学习 VS 监督学习、无监督学习
参见:
https://www.malaoshi.top/show_1EF4l8rV8x6p.html
启发
在神经科学中,人类研究人脑并发现了一种遵循著名的强化算法的 奖励系统;
在心理学中,人们研究的经典条件反射和操作性条件反射,也可以被认为是一个强化问题;
所有的这些问题都可以被认为一种强化学习问题:优化决策 以 实现最佳结果
发展历程
1956年 Bellman 提出了动态规划方法。
1977年Werbos提出只适应动态规划算法。
1988年sutton提出时间差分算法。
1992年Watkins 提出 Q-learning 算法。
1994年rummery 提出Saras算法。
1996年Bersekas提出解决随机过程中优化控制的神经动态规划方法。
2006年Kocsis提出了置信上限树算法。
2009年kewis提出反馈控制只适应动态规划算法。
2014年silver提出确定性策略梯度(Policy Gradients)算法。
2015年Google-deepmind 提出 Deep-Q-Network 算法。
在2016年,AlphaGo击败李世石之后,融合了 深度学习 的 强化学习 技术大放异彩
组成成分
强化学习主要由7个部分组成:
- 智能体(agent):强化学习的本体,作为学习者或者决策者;
- 环境(environment):强化学习智能体以外的一切,主要由状态集合组成;
- 状态(state):一个表示环境的数据,状态集则是环境中所有可能的状态;
- 动作(action):智能体可以做出的动作,动作集则是智能体可以做出的所有动作;
- 奖励(reward):智能体在执行一个动作后,获得的正/负反馈信号,奖励集则是智能体可以获得的所有反馈信息;
- 策略(policy):强化学习是从环境状态到动作的映射学习,称该映射关系为策略。通俗的理解,即智能体如何选择动作的思考过程称为策略;
- 目标:智能体自动寻找在连续时间序列里的最优策略,而最优策略通常指最大化长期累积奖励。在此基础上,智能体和环境通过状态、动作、奖励进行交互的方式为:智能体执行了某个动作后,环境将会转换到一个新的状态,对于该新的状态环境会给出奖励信号(正奖励或者负奖励)。随后,智能体根据新的状态和环境反馈的奖励,按照一定的策略执行新的动作。
智能体(agent) 和 环境(environment)
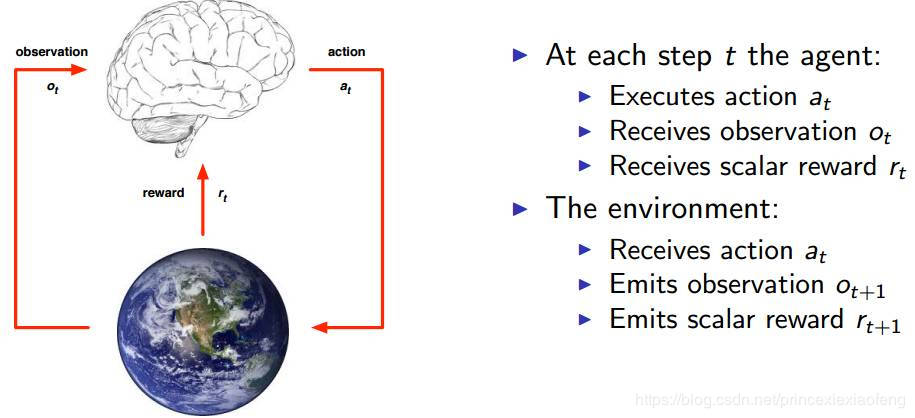
每 t 时刻, agent完成以下过程:
- 执行action At
- 收到观测量 Ot
- 收到反馈奖励 Rt
对于环境:
- 接收action At
- 更新观测量 Ot+1
- 产生奖励 Rt
智能体通过强化学习,可以知道自己在什么状态下,应该采取什么样的动作使得自身获得最大奖励
因此,强化学习实际上是智能体在与环境进行交互的过程中,学会最佳决策方式。可用来解决通用人工智能的问题。因此强化学习也被称为通用人工智能的机器学习方法。
状态 status
执行上图的强化学习,会产生一系列的observation、reward、action,将其保存下来,就构成了历史数据(history)
通过历史数据,就可以让agent选择哪一个action,让environment选择observation和reward。
state的定义:state是用来决定下一步做什么的信息量
历史数据(history)有这样的作用,可以将state看做是history 的函数: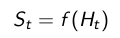
3种state
- environment state
环境的内部状态,即environment采用哪些信息来选择下一步的observation和reward - agent state
哪些信息用于选择下一步的动作,是强化学习算法直接采用的信息,可以表示为历史的任意函数Sat=f(Ht)Sta=f(Ht) - information state
包括了历史数据中所有有用的信息,当state满足 马尔科夫条件,则下一时刻的状态完全由当前时刻决定,可以将其他历史信息扔掉啦!
完全观测环境 VS 部分可观测环境
环境分为:
- 可完全观测环境(Fully Observation Environment)
环境的信息对智能体可见 - 部分可观测环境(Partially Observation Environment)
环境的 一部分信息 对智能体 不可见,如玩扑克不知道对方的牌
完全可观测 环境,特点:
O_t= S_a^t=S_t^e
Agent state = environment state = information state
这是一个 马尔科夫过程
部分可观测 环境,特点:
Agent state != environment state
是部分可观测 马尔科夫过程(POMDP)
agent 需要根据观测量构建agent state S_t^a
agent
agent主要包括以下要素:
- 策略(Policy)
- 价值函数(Value function)
- 智能体模型
policy
策略,简言之就是agent的行为准则,对应着action和state之间的关系。
通常分为:
- 确定性策略(deterministic policy):a=π(s)a=π(s) ,即一个action为state的函数。
- 随机策略(stochastic policy):π(a|s)=P[At=a|St=s]π(a|s)=P[At=a|St=s],对应action相对state的条件概率。
Value function
强化学习的目标:最大化reward之和,但不是每一个学习过程都有终止状态,那么reward之和不能简单计算,所以需要用一个价值函数来估计未来的reward。
模型
根据是否包含 Policy 和 value function 可以分为:
- Value Based
只有价值函数 - Policy Based
只有策略 - Actor Critic
有价值函数
有策略
根据是否建立了 模型,可以分为:
- 无模型(Model Free)
策略 和/或 价值函数 - 有模型(Model Based)
策略 和/或 价值函数
无模型 vs 有模型
区别:智能体是否能完整了解或学习到所在环境的模型
有模型学习:对环境有提前的认知,可以提前考虑规划,但是缺点是如果模型跟真实世界不一致,那么在实际使用场景下会表现的不好。
免模型学习:放弃了模型学习,在效率上不如前者,但是这种方式更加容易实现,也容易在真实场景下调整到很好的状态。所以免模型学习方法更受欢迎,得到更加广泛的开发和测试。
探索 VS 经验
探索(Exploration)还是 经验(Exploitation)
思考问题:是去原来的理发师理发,还是换一个理发师理发
强化学习作为一种探索试错学习,agent需要发现一个好的策略,为了发现这个好的策略,他需要平衡这两者间的关系:
- Exploration:探索新的环境,换言之,就是要不断扩大state的地图,不断搜索以前没遇到的state,并挑战不同的action
- Exploitation: 对已经探索到的环境信息选择可以获得最大reward的action。
https://blog.csdn.net/LagrangeSK/article/details/80943045
https://blog.csdn.net/princexiexiaofeng/article/details/89063568
https://www.intel.ai/demystifying-deep-reinforcement-learning/#gs.q6w218
https://blog.csdn.net/weixin_43612023/article/details/89389408
https://blog.csdn.net/j754379117/article/details/83037799