介绍
全卷积神经网络,Fully Convolutional Networks for Semantic Segmentation,简称:FCN
所有的层都是卷积层,故称为全卷积网络
2014年发表,是用于语义分割的 最简单 且 流行 的神经网络之一
输入可为任意尺寸的彩色图,输出为语义分割后的图像,输出与输入尺寸相同
论文:
https://arxiv.org/abs/1411.4038
FCN分类
FCN又细分为3类:
- FCN-32S
- FCN-16S
- FCN-8S
不同类别的准确率
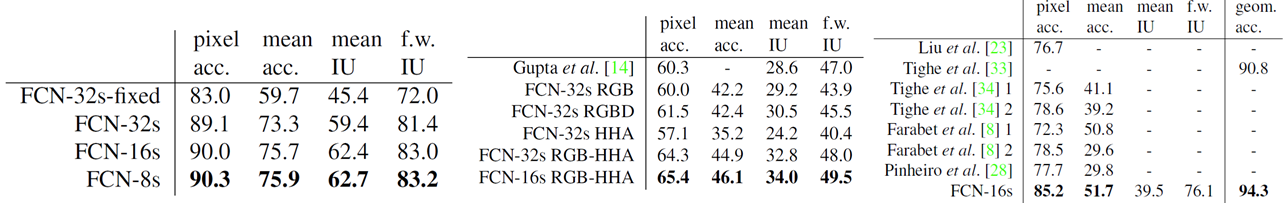
Pascal VOC 2011数据集(左),NYUDv2数据集(中),SIFT流数据集(右)
- FCN-8s 是Pascal VOC 2011中最好的。
- FCN-16s 是NYUDv2中最好的。
- FCN-16s 是SIFT Flow中最好的。
CNN vs FCN
CNN卷积神经网络
对于CNN卷积神经网络,比如VGG16,最后是全连接层,将图片(二维矩阵)压缩成一维,最后输出的是类别的概率 或者 是数值,这样适合 回归 和 分类 任务。
但是丢失细节信息,不能很好地给出物体的 具体轮廓,将每个像素进行分类,做到精确的分割很有难度。

多层结构能自动学习特征(在跳跃结构会用到):
- 较浅的卷积层感知域较小,学习到一些局部区域的特征
前几个卷积层,图像还没有变小,假设卷积核大小是(3,3),相对而言感知区域较小 - 较深的卷积层具有较大的感知域,能够学习到更加抽象一些的特征。
经过几个卷积层、池化层后,图像都会变小,假设卷积核大小是(3,3),相对而言感知区域较大
FCN神经网络
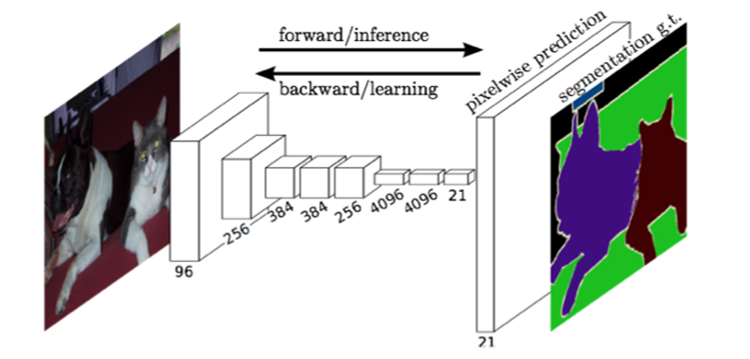
语义分割是对图像进行像素级的分类,最后输出的是 将像素分类好的 图像。
FCN可以接受 任意尺寸 的输入图像,经过卷积层得到feature map,每经过一个卷积层 、池化层,图像都会变小,然后用 反卷积层 对 feature map 进行 上采样, 使它 恢复 输入图像的尺寸, 同时保留了原始输入图像中的 空间信息,从而可以对每个像素都产生了一个预测,
关键技术
主要使用了三种技术:
- 卷积化(Convolutional)
不含全连接层(fc),可适应任意尺寸输入 - 上采样(Upsample)
使用反卷积(另称转置卷积)层,能够输出精细的结果 - 跳跃结构(Skip Layer)
结合不同深度层结果的跳级(skip)结构,同时确保鲁棒性和精确性。
卷积化(Convolutional)
将原来CNN卷积神经网络(如vgg16)的3个全连接层去掉,此时,最后输出的图像不叫 feature map,称之为:heatmap ,即:热图
然后再后面 加上 3 个卷积层,即:所有的层都是卷积层,所以称为 全卷积网络
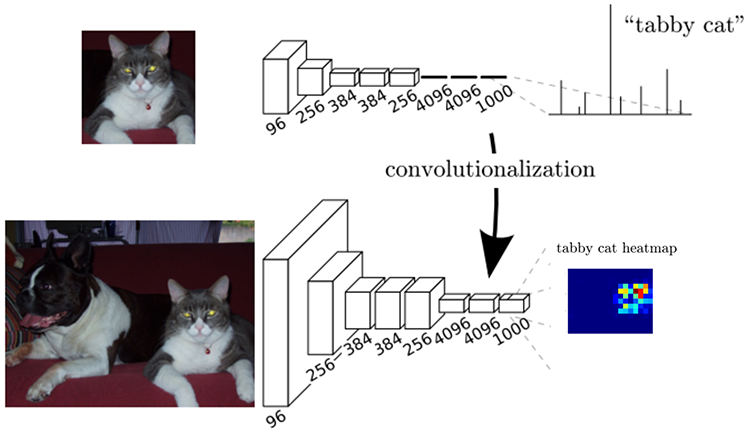
新添加的3个卷积层:
| 层 | 卷积核数量 | 卷积核大小 | padding | 卷积后图像尺寸 |
|---|---|---|---|---|
| 第一个卷积层 | 4096 | (7,7) | same | 不改变 |
| 第二个卷积层 | 4096 | (1,1) | same | 不改变 |
| 第三个卷积层 | 3 | (1,1) | same | 不改变 |
看上去数字上并没有什么差别,但是 卷积 跟 全连接 是不一样的概念,计算过程也不同
注意:
在FCN32S中,为了防止过拟合,第1个、第2个卷积层后面会加上dropout层
上采样(Upsample)
普通的 卷积、池化会 会 缩小图片的尺寸,比如VGG16 ,每次最大池化后都会缩小 1/2,一共 5 次池化,图片缩小 1/32。
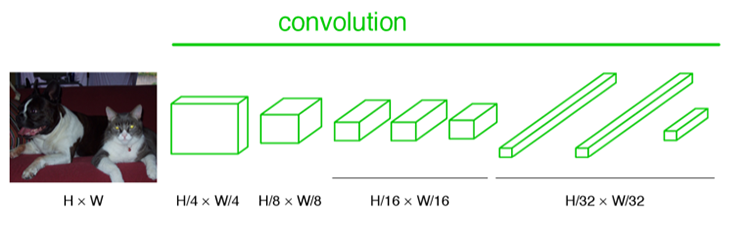
为了得到和原图等大的分割图,需要用 上采样,放大32倍后,就会得到原图大小的 分割图
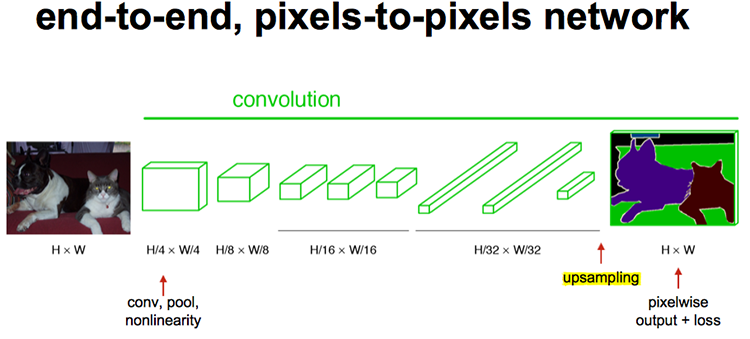
这样就实现了 end-to-end,pixels-to-pixels
注意:
- FCN用上采样中的反卷积
- 不同的神经网络使用上采样的方式不同
详细参见:
https://www.malaoshi.top/show_1EF52HM7gu6g.html
为什么在VGG16的基础之上实现FCN
FCN作者分别在AlexNet、VGG16、GoogLeNet 的基础之上,实现FCN,经过比较,结果如下:
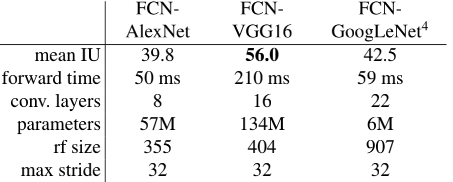
可见FCN-VGG16的 平均交并比(下面有解释) 最高
FCN32S
实现了 卷积化 和 上采样,也就实现了 FCN32S 神经网络
参见:https://www.malaoshi.top/show_1EF53OZZLiWQ.html
跳跃结构(Skip Layer)
实现了 卷积化 和 上采样,也就实现了 FCN32S 神经网络,可以实现语义分割,但是得到的结果往往比较粗糙
所以作者将不同池化层的结果进行上采样之后来优化输出。
具体结构如下:
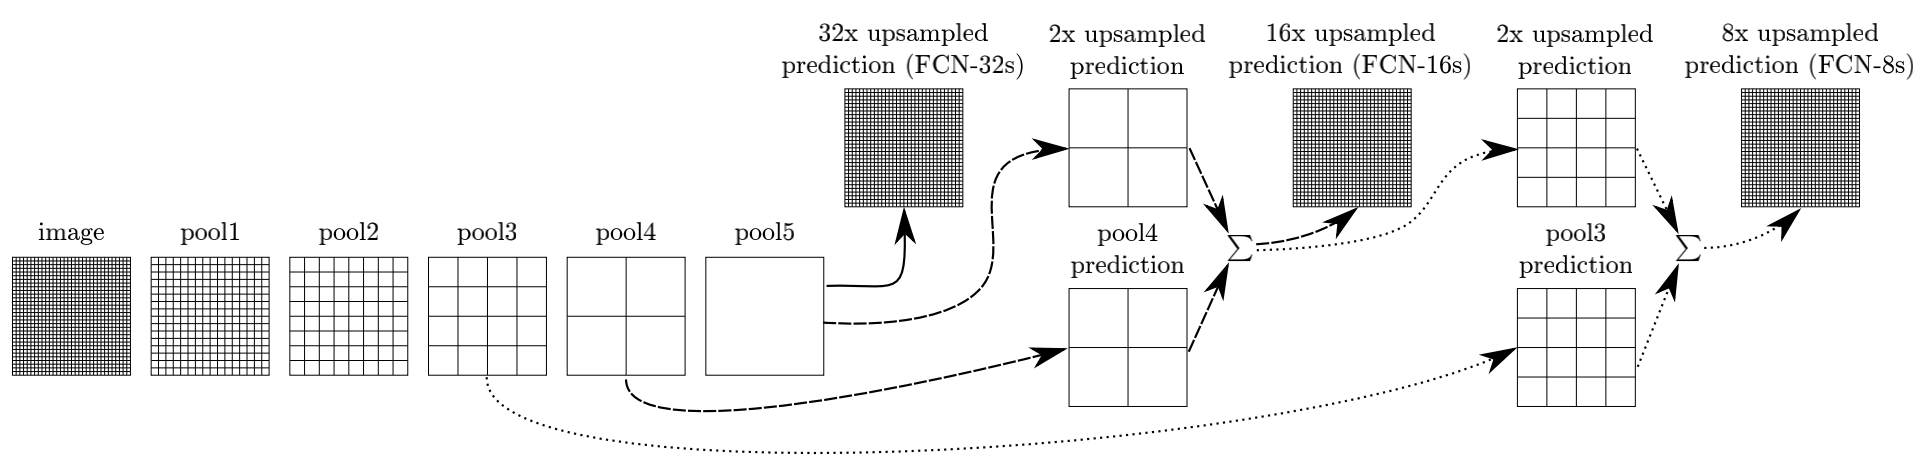
image是原图像,pool1,pool2,…,pool5为池化操作(没经过一次pool,图片缩小1/2)
注意:
图中32x、2x、16x,8x 是指对应的特征图上采样n倍(即变大n倍)
FCN-16S过程
- 将
pool5先进行2x upsampled prediction,输出的结果尺寸与pool4的大小是一样的 - 将上一步的结果与
pool4进行add操作。 - 将上一步的结果进行
16x upsampled prediction,输出结果大小是之前的16倍。
第1步放大2倍,第2步放大16倍,也就是总共放大32,这样最后图像大小也变为原来的大小
FCN-8S过程
- 将
pool5先进行2x upsampled prediction,输出的结果尺寸与pool4的大小是一样的 - 将
pool4与2x pool5进行add操作。 - 将
add 结果进行2x upsampled prediction,输出结果大小是之前的2倍,尺寸与poo3是一样的,将结果 与poo3相加 - 将上一步的结果 进行
8x upsampled prediction,输出结果大小是之前的8倍
此时一共放大2*2*8=32倍,与输入图像image的尺寸相同
FCN-32S、FCN-16S、FCN-8S 比较
评价结果:
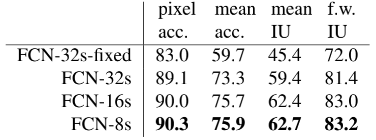
语义分割结果:
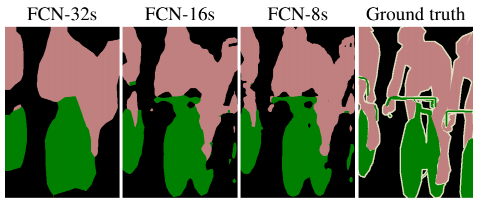
ground truth:真实数据
FCN-4S、FCN-2S是否可行
如果继续仿照FCN作者的步骤,可以对pool2,pool1实现同样的方法,可以有FCN-4s,FCN-2s,最后得到end to end的输出。
这里作者给出了明确的结论,超过FCN-8s之后,结果并不能继续优化。
评价准则
像素精度(pixel accuracy ):每一类像素正确分类的个数/ 每一类像素的实际个数。
均像素精度(mean pixel accuracy ):每一类像素的精度的平均值。
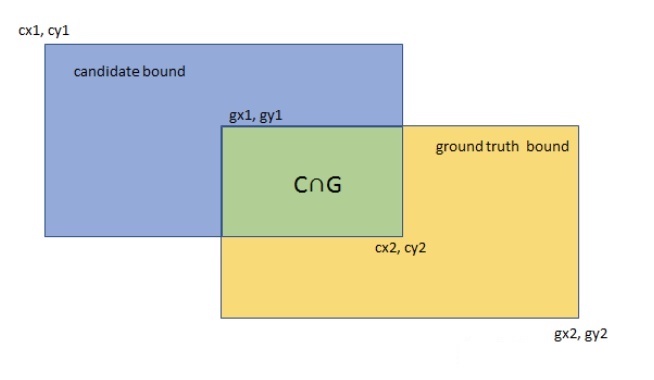
平均交并比(Mean Intersection over Union):求出每一类的IOU取平均值。IOU指的是两块区域相交的部分/两个部分的并集,如下图 绿色部分/总面积。
权频交并比(Frequency Weight Intersection over Union):每一类出现的频率作为权重
缺点
由于转置-卷积(或解卷积)操作的输出的不均匀重叠而导致棋盘伪像的存在。
由于编码过程中信息的丢失,边界分辨率差
使用了较浅层的特征,因为fuse操作会加上较上层的pool特征值,导致高维特征不能很好得以使用,同时也因为使用较上层的pool特征值,导致FCN对图像大小变化有所要求,如果测试集的图像远大于或小于训练集的图像,FCN的效果就会变差。
感谢:
http://blog.qure.ai/notes/semantic-segmentation-deep-learning-review#fcn
https://towardsdatascience.com/review-fcn-semantic-segmentation-eb8c9b50d2d1
https://zhuanlan.zhihu.com/p/37618829
https://www.cnblogs.com/xiaoboge/p/10502697.html