关于 PASCAL VOC 点击
介绍
PASCAL VOC 2007 数据集共包含9963幅图:
- 训练集-5011幅
- 测试集-4952幅
共包含20个种类(数字代表数据集中对应的正样本个数):
| 分类 | 训练集数量 | 测试集数量 |
|---|---|---|
| aeroplane | 238 | 204 |
| bicycle | 243 | 239 |
| bird | 330 | 282 |
| boat | 181 | 172 |
| bottle | 244 | 212 |
| bus | 186 | 174 |
| car | 713 | 721 |
| cat | 337 | 322 |
| chair | 445 | 417 |
| cow | 141 | 127 |
| diningtable | 200 | 190 |
| dog | 421 | 418 |
| horse | 287 | 274 |
| motorbike | 245 | 222 |
| person | 2008 | 2007 |
| pottedplant | 245 | 224 |
| sheep | 96 | 97 |
| sofa | 229 | 223 |
| train | 261 | 259 |
| tvmonitor | 256 | 229 |
person数量较多
官方网址:
http://host.robots.ox.ac.uk/pascal/VOC/voc2007/index.html
下载地址
训练数据和验证数据:
http://host.robots.ox.ac.uk/pascal/VOC/voc2007/VOCtrainval_06-Nov-2007.tar
测试数据:
http://host.robots.ox.ac.uk/pascal/VOC/voc2007/VOCtest_06-Nov-2007.tar
开发工具包:
http://host.robots.ox.ac.uk/pascal/VOC/voc2007/VOCdevkit_08-Jun-2007.tar
解压
tar xvf VOCtrainval_06-Nov-2007.tar
tar xvf VOCtest_06-Nov-2007.tar
tar xvf VOCdevkit_08-Jun-2007.tar
train、val、test区别
- train 是训练集
- val 是validation的简称,是训练过程中的测试集
- test 就是训练模型结束后,用于评价模型结果的测试集
training 和 val 都是在训练的时候起作用,两者数据没有交集,作用是验证是否过拟合、以及用来调节训练参数等。
文件结构
下载解压后,VOCtrainval_06-Nov-2007 和 VOCtest_06-Nov-2007 文件结构(文件夹同名)相同,不要覆盖,要额外处理
文件结构如下:
JPEGImages
    *.jpg
Annotation
    *.xml
ImageSets
    Action
            *_train.txt
            *_trainval.txt
            *_val.txt
    Layout
        train.txt
        trainval.txt
        val.txt
    Main
        *_train.txt
        *_trainval.txt
        *_val.txt
    Segmentation
        train.txt
        trainval.txt
        val.txt
SegmentationClass
    *.png
SegmentationObject
    *.png
介绍:
- JPEGImages — 原图像
- Annotations — xml文件,内容是用于目标检测的物体标注信息(边框的x,y,width,height)
- ImageSets — 内容较复杂,见下面介绍
- SegmentationClass — 语义分割的label
- SegmentationObjec — 实例分割的label
JPEGImages 文件夹
存放原始图像,包含 train图片 和 val图片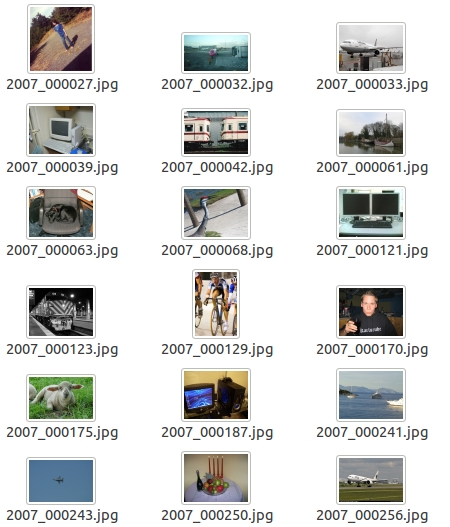
命名方式:年份_编号.jpg
PS:voc 2007 的图片命名没有年份
尺寸:一般为(横向图) 500*375 或(纵向图) 375*500,基本不会偏差超过100
注意:
训练中,一般将这些图片都resize到300*300或是500*500,所有原始图片不能离这个标准过远
Annotations 文件夹
存放的是.xml格式的 标签文件,每一个.xml文件都对应于JPEGImages文件夹中的一张图片(同名)
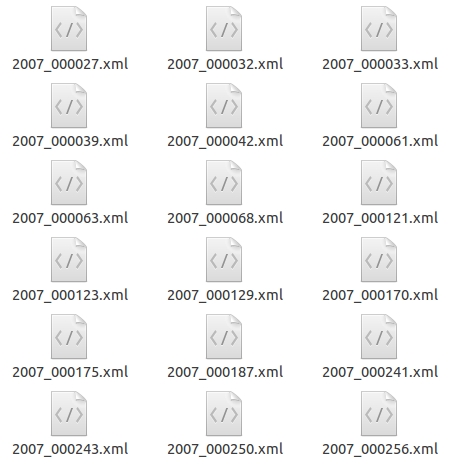
内容是用于目标检测的物体标注信息(边框的x,y,width,height)
文件内容格式:
<annotation>
    <folder>VOC2007</folder>
    <filename>000001.jpg</filename>  # 文件名
    <source>
        <database>The VOC2007 Database</database>
        <annotation>PASCAL VOC2007</annotation>
        <image>flickr</image>
        <flickrid>341012865</flickrid>
    </source>
    <owner>
        <flickrid>Fried Camels</flickrid>
        <name>Jinky the Fruit Bat</name>
    </owner>
    <size>  # 图像尺寸(长宽以及通道数)
        <width>353</width>
        <height>500</height>
        <depth>3</depth>
    </size>
    <segmented>0</segmented>  # 是否用于分割
    <object>  #检测到的物体
        <name>dog</name>  # 物体类别
        <pose>Left</pose>  # 拍摄角度:front, rear, left, right, unspecified
        <truncated>1</truncated>  # 是否被截断(比如在图片之外),或者被遮挡(超过15%),0表示完整
        <difficult>0</difficult>  # 检测难易程度,0表示容易识别。主要根据目标的大小,光照变化,图片质量来判断
        <bndbox> #bounding-box(xmin、ymin表示左上角坐标,xmax、ymax表示右下角x、y坐标)
            <xmin>48</xmin>
            <ymin>240</ymin>
            <xmax>195</xmax>
            <ymax>371</ymax>
        </bndbox>
    </object>
    <object> #检测到多个物体
        <name>person</name>
        <pose>Left</pose>
        <truncated>1</truncated>
        <difficult>0</difficult>
        <bndbox>
            <xmin>8</xmin>
            <ymin>12</ymin>
            <xmax>352</xmax>
            <ymax>498</ymax>
        </bndbox>
    </object>
</annotation>
ImageSets
下面有3个文件夹
ImageSets/Layout
有以下3个文件:
- train.txt - 包含训练数据
- trainval.txt - 包含训练和验证数据
- val.txt - 包含验证数据
包含人体部分的数据
PS:我下载的数据不符,经查找,人体部位的图片都不包括,难道我下的数据被篡改了????
ImageSets/Main 文件夹
该文件夹下的文件较多,如下:
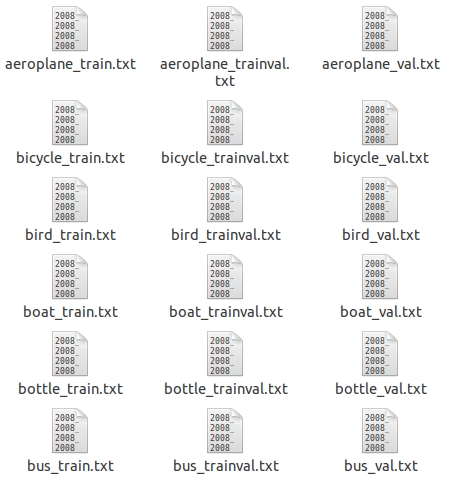
指定某个分类,包含哪些图片,总共分为20类,每个分类有3个文件,如下:
*_train.txt:存放训练使用的数据,每一个class的train数据都有5717个,-1为负样本,1为正样本*_val.txt:存放验证结果使用的数据,每一个class的val数据都有5823个,-1为负样本,1为正样本*_trainval.txt:将上面两个进行了合并,每一个class有11540个,-1为负样本,1为正样本
另有3个文件:
- train.txt:不分类,只是将用于 训练 的图片包含在该文件中
- trainval.txt:不分类,只是将用于 训练 和 验证 的图片包含在该文件中
- val.txt:不分类,只是将用于 验证 的图片包含在该文件中
文件内容
都差不多,存储20个分类类别标签,-1表示负样本,1为正样本:
如下:
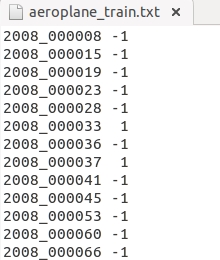
前面的表示图像的name,后面的1代表正样本,-1代表负样本。
ImageSets/Segmentation
存放的是用于 语义分割、实例分割 的数据
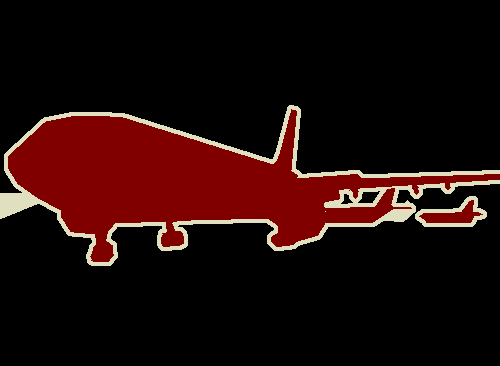
SegmentationClass
存放按照 class 分割的图片,同一类别的物体同一种颜色
一般用于 语义分割
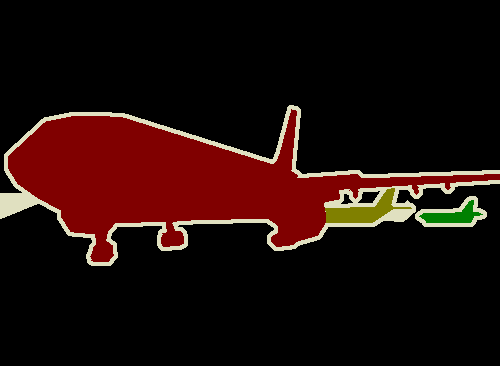
SegmentationObjec
存放按照 object 分割的图片,同一类别的物体,但不是同一个对象,颜色不相同
一般用于 实例分割
感谢:
https://blog.csdn.net/mzpmzk/article/details/88065416
csdn.net/akenseren/article/details/82696108