问题
使用 tensorflow 实现 图片分类、目标检测、语义分割 等功能时,需要读取 大量的 图片、xml(包含定位信息等)、png(包含分割信息)等文件,然后训练神经网络
| 原图 | xml部分截图 | png语义分割 |
|---|---|---|
 |
 |
 |
在VOC 2012 训练数据集中,有 2G 大小,1万多张图片
由于 图片、xml、png 文件有很多,而且有的文件比较小,只有几K,大量 零散 的小文件,占用硬盘空间比较大
在 频繁 读取 大量、小文件时,读取速度比较慢,占用内存空间比较大
类比
相当于拷贝几千个小文件,拷贝速度慢,而且占用硬盘空间比较大

解决方法
将几千个小文件打成zip包,拷贝这一个压缩包,速度会快很多,同时也节省硬盘空间

解决
在 tensorflow 中,就可以将大量的 图片、xml中有用的数据、png 整理成 二进制数据,写入到 一个 TFRecord 文件中
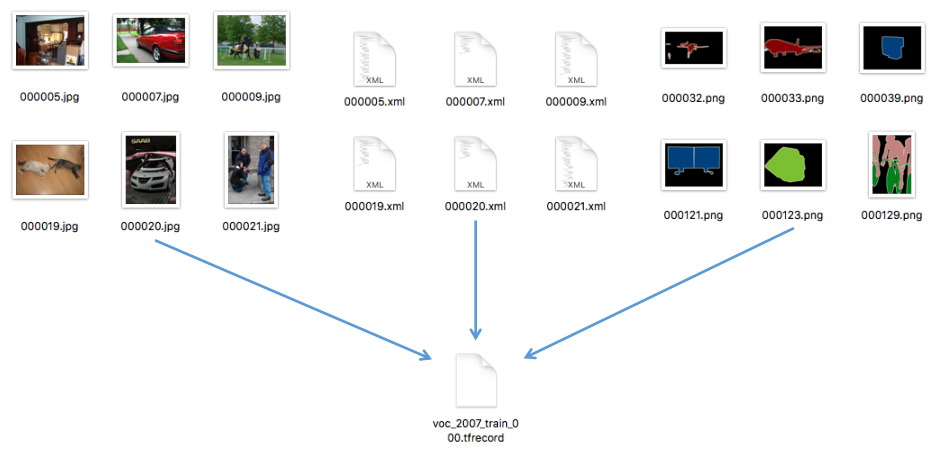
如果数据量大,或者文件体积大,就 分成 多个 TFRecord 文件,相当于打成多个压缩包
这样就会提高读取速度、节省内存
TFRecord
TFRecord 是一个二进制文件
TFRecord内部使用了 “Protocol Buffer” 方案,简单,快速
Protocol Buffers
详见:
https://www.malaoshi.top/show_1EF57W4E8bgu.html
TFRecord 生成
详见:https://www.malaoshi.top/show_1EF57aDz46fN.html
TFRecord 读取
详见:https://www.malaoshi.top/show_1EF57c9xJZe8.html