import requests

import json,time
from bs4 import BeautifulSoup

headers={
    'user-agent': 'Mozilla/5.0 (Windows NT 6.3; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/80.0.3987.87 Safari/537.36',

    }

url="https://cc.58.com/ershoufang/?PGTID=0d3090a7-0013-fdad-f22a-7a10b8b13199&ClickID=2"


def get(url):
    resp = requests.get(url,headers=headers)

    # print(resp.text)
    soup=BeautifulSoup(resp.text,'html.parser')

    datas=soup.select('li[class="sendsoj"]')

    for item in datas:
        # print(item)
        title=item.select("h2 a")[0].text.strip()
        geju=item.select('p[class="baseinfo"] span')[0].text.strip()
        m=item.select('p[class="baseinfo"] span')[1].text.strip()
        chaoxiang=item.select('p[class="baseinfo"] span')[2].text.strip()
        floor=item.select('p[class="baseinfo"] span')[3].text.strip()
        area=item.select('p[class="baseinfo"]')[1].select("span a")[1].text.strip()
        price=item.select('p[class="sum"]')[0].text.strip()
        line="{},{},{},{},{},{},{}\n".format(title,geju,m,chaoxiang,floor,area,price)
        f.write(line)
        f.flush()

    time.sleep(10)
    next_page=soup.select("a[class='next']")
    if next_page:
        next_page_url="https://cc.58.com"+next_page[0].get("href")
        print("下一页url:",next_page_url)
        get(next_page_url)

f=open(r"C:\Users\mym\Desktop\jz\58同城二手房数据.csv","w")
f.write("biaoti,geju,mianji,chaoxiang,louceng,quhua,jiage\n")
get(url)
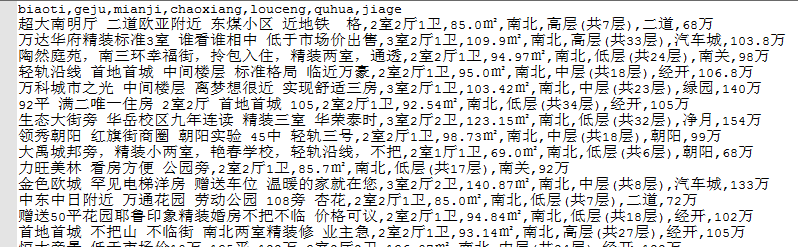
结果如下图: