GELU激活函数
详见 链接
实现
这里为了理解,用手动实现,实际 pytorch 内置了实现类
import torch
import torch.nn as nn
import matplotlib.pyplot as plt


class GELU(nn.Module):

    def __init__(self):
        super().__init__()

    def forward(self, x):
        return 0.5 * x * (1 + torch.tanh(
            torch.sqrt(torch.tensor(2.0 / torch.pi)) * (x + 0.044715 * torch.pow(x, 3))
        ))
绘制图像
为了直观地比较GELU函数与ReLU函数,将它们并排绘制出来
gelu = GELU()
relu = nn.ReLU()
x = torch.linspace(-3, 3, 100)
print("x.shape:", x.shape)
print("x:\n", x)
y_gelu = gelu(x)
y_relu = relu(x)
plt.figure(figsize=(8, 3))
for i, (y, label) in enumerate(zip([y_gelu, y_relu], ["GELU", "ReLU"]), 1):
    plt.subplot(1, 2,i)
    plt.plot(x, y)
    plt.title(f"{label} activation function")
    plt.xlabel("x")
    plt.ylabel(f"{label}(x)")
    plt.grid(True)
plt.tight_layout()
plt.show()
执行结果,x 轴表示函数输入值,y 轴表示函数输出值:

从上图可以看到:
ReLU(右)是一个分段线性函数,当输入为正数时直接输出输入值,否则输出0
GELU(左)则是一个平滑的非线性函数,它近似ReLU,但在几乎所有负值(除了在 x 约等于
-0.75的位置外)上都有非零梯度
GELU优点
GELU的平滑特性可以在训练过程中带来更好的优化效果,因为它允许模型参数进行 更细微的调整。
相比之下,ReLU在零点处有一个 尖锐的拐角(参见上图的右图),有时会使得优化过程更加困难,特别是在深度或复杂的网络结构中。
此外,ReLU对 负输入 的输出为 0 ,而GELU对 负输入 会输出一个 小的非零值。这意味着在训练过程中,接收到 负输入 的神经元仍然可以 参与学习,只是贡献程度不如正输入大。
前馈神经网络
详见 前馈神经网络(feedforward neural network,FNN)
实现小型神经网络
将使用GELU函数来实现小型神经网络模块 FeedForward,该模块将在大语言模型的Transformer块中使用
# 实现小型神经网络
print("\n实现小型神经网络------")
class FeedForward(nn.Module):
    def __init__(self, cfg):
        """
        由两个线性层和一个GELU激活函数组成
        :param cfg:
        """
        super().__init__()
        self.layers = nn.Sequential(
            nn.Linear(cfg["emb_dim"], 4 * cfg["emb_dim"]),
            GELU(),
            nn.Linear(4 * cfg["emb_dim"], cfg["emb_dim"]),
        )

    def forward(self, x):
        return self.layers(x)
解释
FeedForward 类是一个小型神经网络,由 两个线性层 和 一个GELU激活函数 组成。
在参数量为1.24亿的GPT模型中,该模块通过 GPT_CONFIG_124M 字典接收输入批次,其中每个词元的嵌入维度为 768,即 GPT_CONFIG_124M["emb_dim"] = 768。
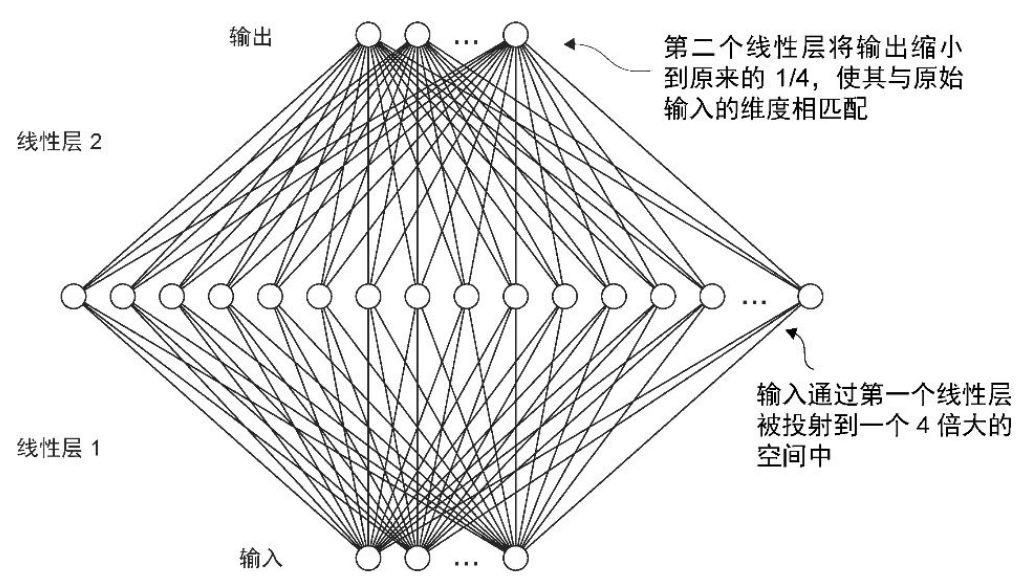
下图展示了当输入传递给这个小型前馈神经网络时,嵌入维度是如何被操作的:

执行
创建一个词元嵌入维度为 768 的 FeedForward 对象,然后将一个包含 2个样本 且 每个样本有3个词元 的批次输入提供给它:
GPT_CONFIG_124M = {
    "vocab_size": 50257,     # 词汇表大小
    "context_length": 1024,  # 上下文长度
    "emb_dim": 768,          # 嵌入维度
    "n_heads": 12,           # 注意力头的数量
    "n_layers": 12,          # 层数
    "drop_rate": 0.1,        # dropout率
    "qkv_bias": False        # 查询-键-值偏置
}

ffn = FeedForward(GPT_CONFIG_124M)
x = torch.rand(2, 3, 768)
out = ffn(x)
print("神经网络输出结果的shape:", out.shape)
print("神经网络输出结果:\n", out)
执行结果:
torch.Size([2, 3, 768])
说明
FeedForward 模块在提升模型学习和泛化能力方面非常关键。该模块的 输入和输出维度保持一致,执行过程:
通过第一个线性层将嵌入维度 扩展到更高的维度,从768维扩展到3072维
扩展之后,应用 非线性GELU激活函数
然后通过 第二个线性变换 将维度 缩回原始大小,即:将3072维压缩回768维
好处
- 这种设计允许模型探索更丰富的表示空间
- 输入维度和输出维度的一致性 简化了架构,在后续堆叠多个层时 无须调整维度,从而增强了模型的扩展能力
总结
已经实现了大部分大语言模型的构建块。接下来,将介绍插入在神经网络不同层之间的快捷连接的概念
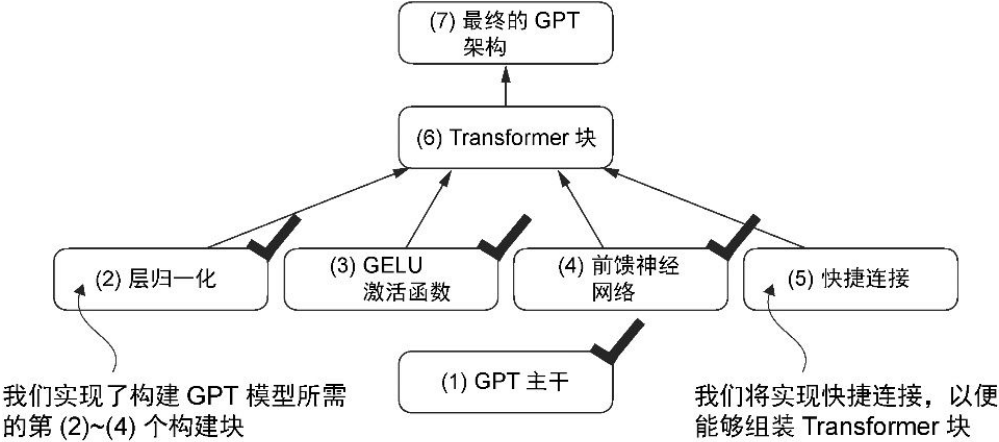
其中黑色勾选标记表示已经构建完成的部分