介绍
准备用于训练大语言模型的训练数据集和验证数据集。然后,如下图的突出显示部分所示,在完成了 第(1)步 和 第(2)步,包括 计算交叉熵损失 后,接下来将这个损失计算应用到 模型训练的整个文本数据集中

为了计算训练数据集和验证数据集上的损失,使用了一个 非常小的文本数据集,即Edith Wharton的短篇小说 《The Verdict》(在 大模型原理:文本分词(将输入文本分割为独立的词元) 使用过)。
好处:
- 通过选择来自公共领域的文本,规避了与使用权相关的任何问题。
- 使用如此小的数据集,即使没有高端的GPU,也可以在几分钟内在标准笔记本电脑上执行代码示例,这将有利于教学。
加载小说
file_path = "the-verdict.txt"
with open(file_path, "r", encoding="utf-8") as file:
    text_data = file.read()

print("小说:", text_data[0:100])
查看数据集中的字符数和词元数
import tiktoken
tokenizer = tiktoken.get_encoding("gpt2")
# 查看数据集中的字符数和词元数
print("小说:", text_data[0:100])
total_characters = len(text_data)
total_tokens = len(tokenizer.encode(text_data))
print("Characters:", total_characters)
print("Tokens:", total_tokens)
输出如下所示:
Characters: 20479
Tokens: 5145
虽然这个文本只有5145个词元,可能看起来太小,无法用来训练大语言模型,出于教学目的,以便可以在几分钟(而不是几周)内运行代码。
将数据集分成训练集和验证集
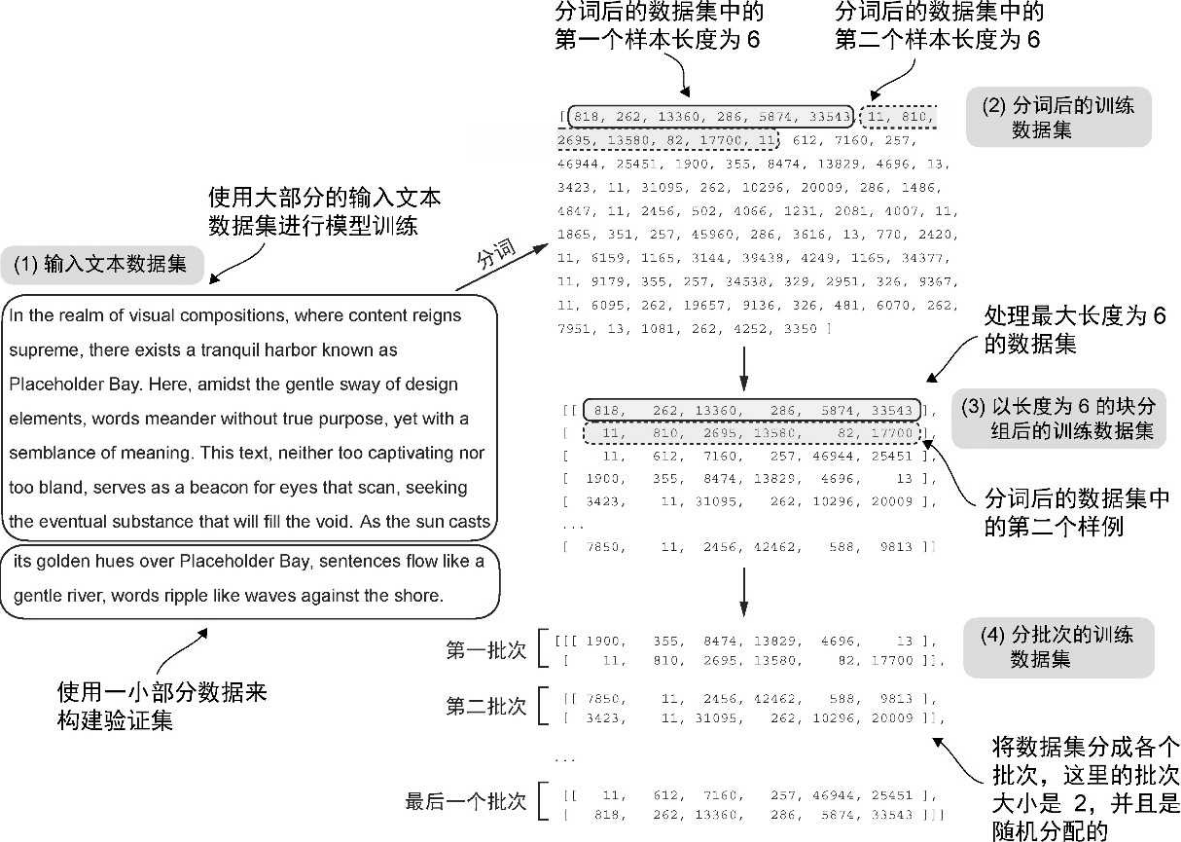
提示:上图由于空间限制,使用了
max_length=6。对于实际的数据加载器,可以将max_length设置为256个词元的上下文长度,以便训练期间大语言模型能够看到更长的文本。
注意:为了简化操作并提高效率,我们使用以大小相似的块呈现的训练数据来训练模型。然而,在实践中,使用不同长度的输入来训练大语言模型也是有益的,因为这有助于大语言模型在使用中更好地概括不同类型的输入
- 将输入文本分割为训练集和验证集。
- 然后,对文本进行分词(为了简化操作,这里仅显示了训练集),并将分词后的文本分成用户指定长度的块(这里是
6)。 - 最后,对行进行重排,并将分块后的文本组织成批次(这里批次大小为
2),这些批次可用于进行模型训练
准备代码
从 大模型原理:通用代码合集 复制下列部分:
- 导入模块
- GPTDatasetV1
- create_dataloader_v1()
- MultiHeadAttention
- GELU
- FeedForward
- LayerNorm
- TransformerBlock
- GPTModel
从 大模型原理:修改大模型配置 复制下列部分:
GPT_CONFIG_124M
分割训练集和验证集
为了实现数据拆分和加载,首先定义一个 train_ratio,使用 90% 的数据 进行训练,剩余的 10% 作为 验证 数据,以便在训练过程中对模型进行评估:
train_ratio = 0.90
split_idx = int(train_ratio * len(text_data))
train_data = text_data[:split_idx]
val_data = text_data[split_idx:]
创建加载器
torch.manual_seed(123)

train_loader = create_dataloader_v1(
    train_data,
    batch_size=2, // 批次为2
    max_length=GPT_CONFIG_124M["context_length"],
    stride=GPT_CONFIG_124M["context_length"],
    drop_last=True,
    shuffle=True,
    num_workers=0
)
val_loader = create_dataloader_v1(
    val_data,
    batch_size=2,
    max_length=GPT_CONFIG_124M["context_length"],
    stride=GPT_CONFIG_124M["context_length"],
    drop_last=False,
    shuffle=False,
    num_workers=0
)
因为处理的是一个 非常小 的数据集,所以使用了相对 较小的批次大小(batch_size=2) 来减少对计算资源的需求。在实践中,更常见的是使用 1024 或 更大的批次大小 来训练大语言模型。
遍历数据加载器,查看数据:
print("--------")
print("\n训练加载器:")
for x, y in train_loader:
    print(x.shape, y.shape)

print("\n验证加载器:")
for x, y in val_loader:
    print(x.shape, y.shape)
执行结果:
训练加载器:
torch.Size([2, 256]) torch.Size([2, 256])
torch.Size([2, 256]) torch.Size([2, 256])
torch.Size([2, 256]) torch.Size([2, 256])
torch.Size([2, 256]) torch.Size([2, 256])
torch.Size([2, 256]) torch.Size([2, 256])
torch.Size([2, 256]) torch.Size([2, 256])
torch.Size([2, 256]) torch.Size([2, 256])
torch.Size([2, 256]) torch.Size([2, 256])
torch.Size([2, 256]) torch.Size([2, 256])

验证加载器:
torch.Size([2, 256]) torch.Size([2, 256])
根据上面的代码输出,有 9个训练集批次,其中每个批次包含 2个样本,每个样本包含 256个词元。
由于仅将 10% 的数据用于 验证,因此 只有一个包含 2 输入示例的验证批次。
输入数据(x) 和 目标数据(y)具有 相同的形状(批次大小 × 每个批次中的词元数),因为 目标数据 是将 输入数据 向后移动一个位置得到的
定义计算交叉熵损失的函数
实现一个工具函数,用于计算通过训练集加载器和验证集加载器返回的 给定批次(单个批次的损失) 的交叉熵损失
def calc_loss_batch(input_batch, target_batch, model, device):
    """
    根据训练集加载器和验证集加载器返回的给定批次,进行计算交叉熵损失
    :param input_batch: 输入
    :param target_batch: 目标
    :param model: 模型
    :param device: 指定运行设备,CPU 或 GPU
    :return: 返回交叉熵损失值
    """
    input_batch, target_batch = input_batch.to(device), target_batch.to(device)
    logits = model(input_batch)
    loss = torch.nn.functional.cross_entropy(logits.flatten(0, 1), target_batch.flatten())
    return loss
计算训练集和验证集损失的函数
默认情况下,
calc_loss_loader()函数会遍历给定数据加载器中的所有批次,将损失累积在total_loss变量中,然后计算 所有批次的损失的平均值。通过
num_batches指定较小的批次数,以加快模型训练期间的评估速度。
def calc_loss_loader(data_loader, model, device, num_batches=None):
    total_loss = 0.
    if len(data_loader) == 0:
        return float("nan")
    elif num_batches is None:
        num_batches = len(data_loader)
    else:
        # Reduce the number of batches to match the total number of batches in the data loader
        # if num_batches exceeds the number of batches in the data loader
        num_batches = min(num_batches, len(data_loader))
    for i, (input_batch, target_batch) in enumerate(data_loader):
        if i < num_batches:
            loss = calc_loss_batch(input_batch, target_batch, model, device)
            total_loss += loss.item()
        else:
            break
    return total_loss / num_batches
执行
把 calc_loss_loader() 函数,应用到训练集和验证集的加载器上:
# 这里必须设置随机种子,否则结果与本例不同
torch.manual_seed(123)

model = GPTModel(GPT_CONFIG_124M)
model.eval()

# 判断是否支持GPU,如果支持GPU就自动在GPU训练,否则就用CPU
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model.to(device)

# 此处不能设置随机种子,否则结果与本例不同
# torch.manual_seed(123)

# 因为还没有开始训练,所以不使用梯度追踪,这样会更高效
with torch.no_grad():
    train_loss = calc_loss_loader(train_loader, model, device)
    val_loss = calc_loss_loader(val_loader, model, device)

print("Training loss:", train_loss)
print("Validation loss:", val_loss)
执行结果:
Training loss: 10.98758347829183
Validation loss: 10.98110580444336
由于模型 未经过训练,因此 损失值相对较高。如果模型学会按照训练集和验证集中词元的出现顺序生成下一个词元,那么损失将接近于0。
总结
实现衡量生成文本质量的方法,将训练大语言模型以减少这种损失,使其在生成文本方面变得更好,如图:

实现了基本的模型评估技术(第(2)步)以计算训练集和验证集的损失(第(3)步),