传统搜索的缺点
传统检索(比如百度搜索)靠 “关键词匹配”,会出现这种问题:
- 用户问:“苹果的充电速度快吗?”(指苹果手机);
- 检索到:“苹果的成熟度越高,甜度越快”(指水果苹果);
原因是只匹配了“苹果”“快”这两个关键词,没理解语义。
解决
RAG通过 余弦相似度 解决
余弦相似度是什么?
在RAG的向量检索环节,余弦相似度是用来 衡量两个向量“方向相似度” 的核心指标——你可以把它理解成:
把 用户问题向量 和 文档片段向量 想象成 两根箭头线段,余弦相似度就是这 两根箭头线段 之间的 夹角大小:
- 夹角越小(比如0°)→ 余弦相似度≈1 → 语义几乎完全一致;
- 夹角越大(比如90°)→ 余弦相似度=0 → 语义完全无关;
- 夹角180° → 余弦相似度=-1 → 语义完全相反。
注意:与长度无关
公式
\frac{\vec{A} \cdot \vec{B}}{||\vec{A}|| \times ||\vec{B}||}
余弦相似度:两个向量的点积 / 两个向量模长的乘积
结果:范围是 [-1, 1],越接近1,夹角越小,越相似
二维例子
向量 (0.5,0.5) 和 (0.7,0.5) 的夹角,如下:
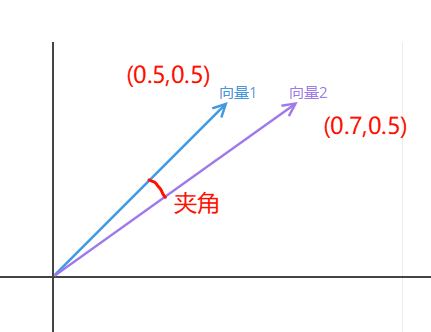
点积计算过程:0.5 * 0.7 + 0.5 * 0.5 = 0.6
第1个向量的模长:\sqrt{0.5^2 + 0.5^2} = 0.71
第2个向量的模长:\sqrt{0.7^2 + 0.5^2} = 0.86
最终:0.6 / (0.71 * 0.86) = 0.98
非常接近1,说明这两个向量很相似
高维度例子
3维、256维等计算方式同上
余弦相似度在RAG中的作用
在RAG的“语义检索”环节,余弦相似度是唯一核心的匹配标准,替代了传统的“关键词匹配”,这也是RAG能解决大模型“答非所问”的关键,核心作用有3点:
1. 突破“关键词匹配”的局限(解决“字面相似但语义不同”)
当用户问:“苹果的充电速度快吗?”(指苹果手机)
余弦相似度基于 向量方向(语义)匹配:
手机相关的“苹果” 向量方向,和水果相关的“苹果” 向量方向 完全不同;
即使没有完全相同的关键词,只要语义相似也能精准匹配,比如:
RAG怎么做和搭建RAG的步骤,关键词不同但语义一致,余弦相似度接近1
✅ 对RAG的影响:这是RAG能实现“语义检索”的核心,也是它比传统关键词检索更智能的根本原因。
2. 不受向量长度影响(适配不同维度的向量)
在RAG中,不同嵌入模型生成的向量“长度”(模长)可能不同(比如768维向量的模长是10,1024维是12),但余弦相似度只关注“方向”,不关注“长度”:
- 比如“RAG流程”的768维向量和1024维向量,只要语义一致,余弦相似度依然接近1;
- 避免了“向量长度不同导致匹配不准”的问题,适配你之前关注的“不同维度向量”场景。
✅ 对RAG的影响:不管选768维还是1024维向量,余弦相似度都能稳定衡量语义相似度,不用额外调整向量长度。
3. 计算高效(适配RAG的快速检索需求)
相比其他相似度计算方式(如欧氏距离),余弦相似度的计算逻辑更简单:
- 中小规模RAG(10万条以内):单次计算耗时<1ms,能实现“用户提问→毫秒级检索→快速回答”;
- 即使是百万级向量库,通过向量索引(如IVF、HNSW)优化后,余弦相似度计算依然能保持高效。
✅ 对RAG的影响:保证RAG的检索速度,避免用户等待太久,提升使用体验。
RAG中使用余弦相似度的避坑提醒
- 不要只看相似度数值:不是相似度=1才是匹配,通用场景下
≥0.7就说明语义高度相似,可纳入检索结果;专业场景(法律/医疗)建议≥0.8; - 结合元数据过滤:比如“相似度
≥0.7+ 文档类型=PDF”,避免检索到相似但无关类型的文档; - 异常值处理:如果所有文档的相似度都
<0.3,说明知识库中无相关内容,RAG应直接提示“暂无相关信息”,而非强行生成回答(避免幻觉)。
例子
import math


def dot(vec1, vec2):
    """
    计算两个向量的点积(逐元素相乘后求和)

    参数:
        vec1: 第一个向量(列表/元组形式)
        vec2: 第二个向量(列表/元组形式)

    返回:
        两个向量的点积(float)
    """
    # 先检查向量维度是否一致
    if len(vec1) != len(vec2):
        raise ValueError("计算点积时,两个向量的维度必须相同!")

    res = 0.0
    for i in range(len(vec1)):
        e1 = vec1[i]
        e2 = vec2[i]
        res += e1 * e2
    return res


def norm(vec):
    """
    计算单个向量的模长(长度)

    参数:
        vec: 待计算模长的向量(列表/元组形式)

    返回:
        向量的模长(float)
    """
    norm_sum = 0.0
    for e in vec:
        norm_sum += e ** 2
    # 开平方根得到最终模长
    res = math.sqrt(norm_sum)
    return res


def cos_sim(vec1, vec2):
    """
    计算两个向量的余弦相似度、

    参数:
        vec1: 第一个向量(列表/元组形式)
        vec2: 第二个向量(列表/元组形式)

    返回:
        余弦相似度值(float)
    """
    # 调用独立函数计算点积
    dot_res = dot(vec1, vec2)

    # 调用独立函数计算两个向量的模长
    norm1 = norm(vec1)
    norm2 = norm(vec2)

    # 避免除以零的情况
    if norm1 == 0 or norm2 == 0:
        return 0.0

    # 计算余弦相似度
    res = dot_res / (norm1 * norm2)
    return res


# 定义示例向量
vector1 = (0.5, 0.5)
vector2 = (0.7, 0.5)

# 计算并输出结果
res = cos_sim(vector1, vector2)
print(f"向量 {vector1} 和 {vector2} 的余弦相似度为: {res:.4f}")
总结
- 核心定义:余弦相似度是衡量两个向量“方向相似度”的指标,结果越接近1,语义越相似,范围是[-1,1];
- RAG核心作用:实现精准的语义检索(突破关键词局限)、适配不同维度向量、保证检索效率;
- 选择逻辑:相比欧氏距离,余弦相似度更关注“语义”而非“数值”,是RAG检索的最优选择;
- 使用技巧:通用场景相似度≥0.7即可纳入结果,结合元数据过滤提升精准度。