介绍
二分查找(也叫折半查找),这是一种高效的查找算法,只能 用于 有序的线性集合,通过不断缩小查找范围实现快速查找,比逐个遍历的顺序查找效率高得多。
前提
必须 先排序,如果是乱序的,那么就没法用 二分查找算法了。
查找思想
二分查找通过比较数组 中间的数据 与 目标数据 的大小,可以得知目标数据是在 数组的左边还是右边。因此,比较一次就可以把 查找范围缩小一半。重复执行该操作就可以找到目标数据,或得出目标数据不存在的结论。
步骤
排序:先对数组进行排序:升序或降序,因为折半查找依赖于数据的有序性
初始化:确定数组的起始点
start(通常为索引0)和结束点end(数组长度减1)查找过程:
计算中间位置
mid,公式一般为mid = (start + end) // 2(使用整除以确保mid为整数)。比较 目标值 与中间位置的值:
如果目标值等于中间位置的值,则查找成功,返回该位置。
如果目标值小于中间位置的值,在数组的左半部分继续查找,即:更新结束位置为
end = mid - 1如果目标值大于中间位置的值,在数组的右半部分继续查找,即:更新起始位置为
start = mid + 1
重复
步骤3,直到找到目标,或左边界 > 右边界(说明集合中无目标值)。
例子
假设待查找数列为 1、3、5、7、9、11、19,我们要找的元素为 19,下面进行二分查找。
首先待查数列如下图,找到中间的元素 7( 索引:(0+6)/2=3,即:第 4 个位置上的元素)
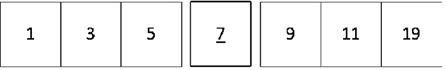
中间元素为 7,要找的元素 19 比 7 大,于是在后半部分查找,现在后半部分数列为 9、11、19,找到中间元素,如下图:
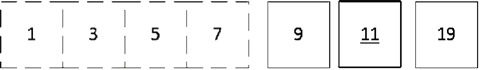
中间元素为 11,要找的元素 19 比 11 大,则继续在后半部分查找,后半部分只有一个元素 19 了,这时直接与 19 比较,相等,结束查找。
查找次数
最好情况
1次比较 ,目标在中间位置
最坏情况
总共有 n 个元素,要查找的元素在最后,操作如下:
初始时,数组长度为 n
第1次比较后,搜索范围缩小一半,因此剩下的元素数量 \frac{n}{2}
第2次比较后,剩下的元素数量 \frac{n}{4}
第k次比较后,剩下的元素数量 \frac{n}{2^k}
当剩下的元素数量为 1 时,表示找到了,所以:
\frac{n}{2^k}=1
可得 k = \log_2n,(是以 2 为底,n 的对数)
最多查找次数:\log_2n
例子
长度是16的数组,要查找的元素在最后一位,需要查找 5 次,即:log_216 = 4
时间复杂度
根据查找次数可知,最好、最坏、平均情况都是:O(\log_2n)
空间复杂度
迭代版 O(1)
优缺点
优点
- 由时间复杂度可知,查找效率极高,而且数据量越大越明显
- 空间复杂度低
缺点
必须有序,如果序列无序,需要先排序(排序时间至少 O (n \log_2n)),若仅做一次查找,排序的成本远高于直接顺序查找,得不偿失;
必须顺序存储(数组 / 有序表):无法用于链表(单向 / 双向),因为链表 不支持下标随机访问,每次找中间元素都需要从头遍历,会让二分查找退化为
O (n),失去优势。数据量过小时,优势不明显甚至更慢。当
n很小(比如 n≤10),二分查找的 \log_2n 次比较,和顺序查找的平均 n_2 次比较,实际耗时几乎无差异;甚至因为二分查找需要计算中间下标、判断边界,实际运行速度可能略慢于顺序查找。
应用场景
有序、可随机访问(数组,可通过下标访问)、查找多、改动少(每次改动,都要重新排序,排序也耗时,至少是 O (n \log_2n))
题
对某有序表进行折半查找(二分查找)时,进行比较的关键字序列不可能是()
A、42,61,90,85,77
B、42,90,85,61,77
C、90,85,61,77,42
D、90,85,77,61,42
分析
技巧:不可能出现一次最大值,然后又出现一次更大的值;同理,不可能出现一次最小值,然后又出现一次更小的值
选项A如下图,是有可能的:

选项B如下图,是有可能的:

选项C如下图,第4步 往左折返后 出现 42 ,比 第3步 往右折返后 出现 61 还要小,是不合理的:

选项D如下图,是有可能的:

做题技巧
有上图可知:比较的中间值会越来越趋于中间
上一次 往左 ,本次 往右折返,那上一次的最大值一定比本次的值 大。
上一次 往右 ,本次 往左折返,那上一次的最小值一定比本次的值 小。如下图的第4步是不合理的:
详见下面例子
判定树和平衡二叉树
对序列进行折半查找(即二分查找)的过程可用一棵 判定树 表示,该判定树的形态符合 平衡二叉树 的特点
题
在线性表L中进行二分查找,要求L()
A、顺序存储,元素随机排列
B、双向链表存储,元素随机排列
C、顺序存储,元素有序排列
D、双向链表存储,元素有序排列
答案
C
题
折半查找在有序数组A中查找特定的记录K:通过比较K和数组中的中间元素A[mid]进行,如果相等,则算法结束;如果K小于A[mid],则对数组的前半部分进行折半查找;否则对数组的后半部分进行折半查找。根据上述描述,折半查找算法采用了()算法设计策略。对有序数组(3,14,27,39,42,55,70,85,93,98),成功查找和失败查找所需要的平均比较次数分别是((假设查找每个元素的概率是相同的)
问题1
A.分治
B.动态规划
C.贪心
D.回溯
问题2
A.29/10和29/11
B.30/10和30/11
C.29/10和39/11
D.30/10和40/11
分析
构造对应的折半查找判定树如下:

根为42,即:第5个元素,算法:
(1 + 10) / 2 = 5第二层结点:
- 第2个元素14,算法:
(1+4)/2 = 2 - 第8个元素85,算法:
(6+10)/2 = 8
- 第2个元素14,算法:
第三层结点:
- 第1个元素3
- 第3个元素27,算法:
(3+4)/2 = 3 - 第6个元素55,算法:
(6+7)/2 = 6 - 第9个元素93,算法:
(9+10)/2 = 9
第四层结点:
- 39
- 70
- 98
成功查找次数
- 41:在第一层,所以比较1次就能找到
- 14、85:在第二层,所以比较2次能找到
- 3、27、55、98:在第三层,所以比较3次能找到
- 39、70、98:在第四层,所以比较4次能找到
总共查找次数:1+2*2+3*4+4*3 = 29
平均查找次数:29次/10个
失败查找次数
折半查找失败的过程,可以理解为对处于这10个元素之前的间隔位置的数进行了查找,对各个元素间隔进行编号依次为1、2、3、.….、11,此时:
- 1号间隔位于3的左侧(要查找的数字比3还小),此时需要分别与元素42、14、3比较后才会查找失败,比较次数为3;
- 2号位置位于3和14之间(要查找的数字在3-14之间),此时需要分别与元素42、14、3比较后才会查找失败,比较次数为3;
- 3号位置位于14和27之间,此时需要分别与元素42、14、27比较后才会查找失败,比较次数为3;
- 4号位置位于27和39之间,此时需要分别与元素42、14、27、39比较后才会查找失败,比较次数为4;
- 5号位置位于39和42之间,此时需要分别与元素42、14、27、39比较后才会查找失败,比较次数为4;
- 6号位置位于42和55之间,此时需要分别与元素42、85、55比较后才会查找失败,比较次数为3;
- 7号位置位于55和77之间,此时需要分别与元素42、85、55、77比较后才会查找失败,比较次数为4;
- 8号位置位于77和85之间,此时需要分别与元素42、85、55、77比较后才会查找失败,比较次数为4;
- 9号位置位于85和93之间,此时需要分别与元素42、85、93比较后才会查找失败,比较次数为3;
- 10号位置位于93和98之间,此时需要分别与元素42、85、93、98比较后才会查找失败,比较次数为4;
- 11号位置位于98右侧(要查找的数字比98还大),此时需要分别与元素42、85、93、98比较后才会查找失败,比较次数为4;
此时平均查找次数为 (3*5+4*6)/11=39/11
因此第二问选择C选项。