说明
当 hbase 中的数据量很大时,使用 hbase 提供的 MapReduce 程序进行计数统计
准备
启动 yarn
需要 MapReduce 计算,需要启动 yarn,登录 hadoop2,执行下面命令:
start-yarn.sh
启动history server
登录 hadoop1 执行下面命令
mapred --daemon start historyserver
启动 MapReduce
hbase 向 yarn集群提交一个MapReduce作业
语法
在 linux 环境下 执行下面命令:
hbase org.apache.hadoop.hbase.mapreduce.RowCounter '表名'
例子
$HBASE_HOME/bin/hbase org.apache.hadoop.hbase.mapreduce.RowCounter 'student'
显示结果如下:
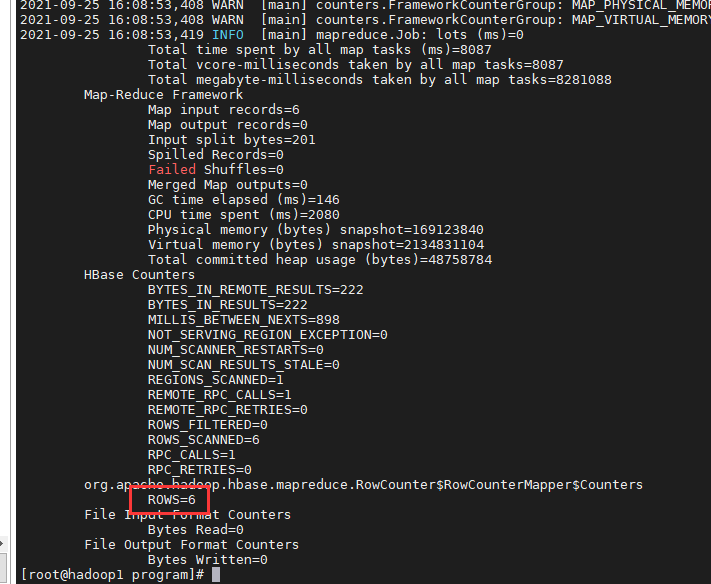
如上图,共有6行记录:
ROWS=6
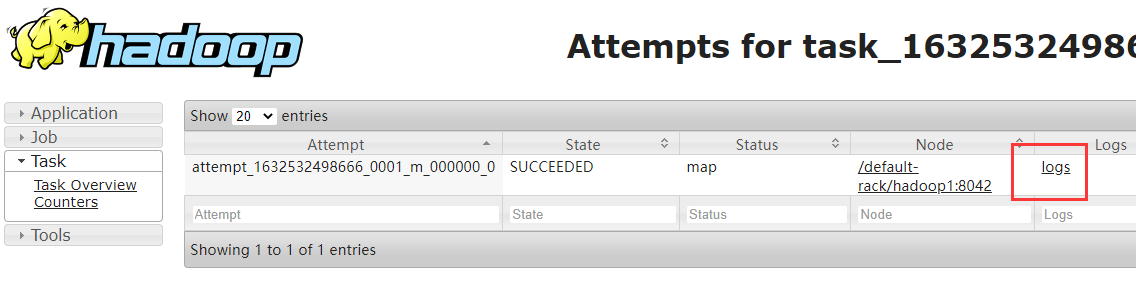
historyserver web页面 查看结果
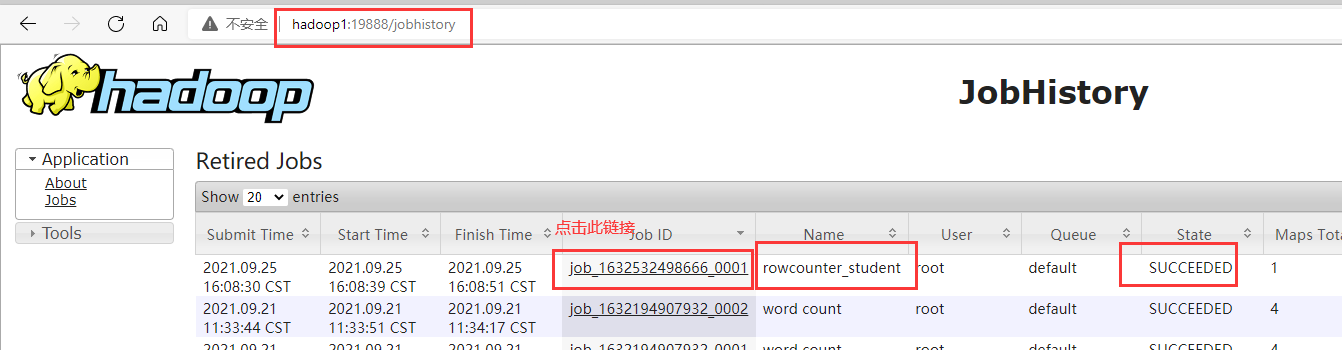
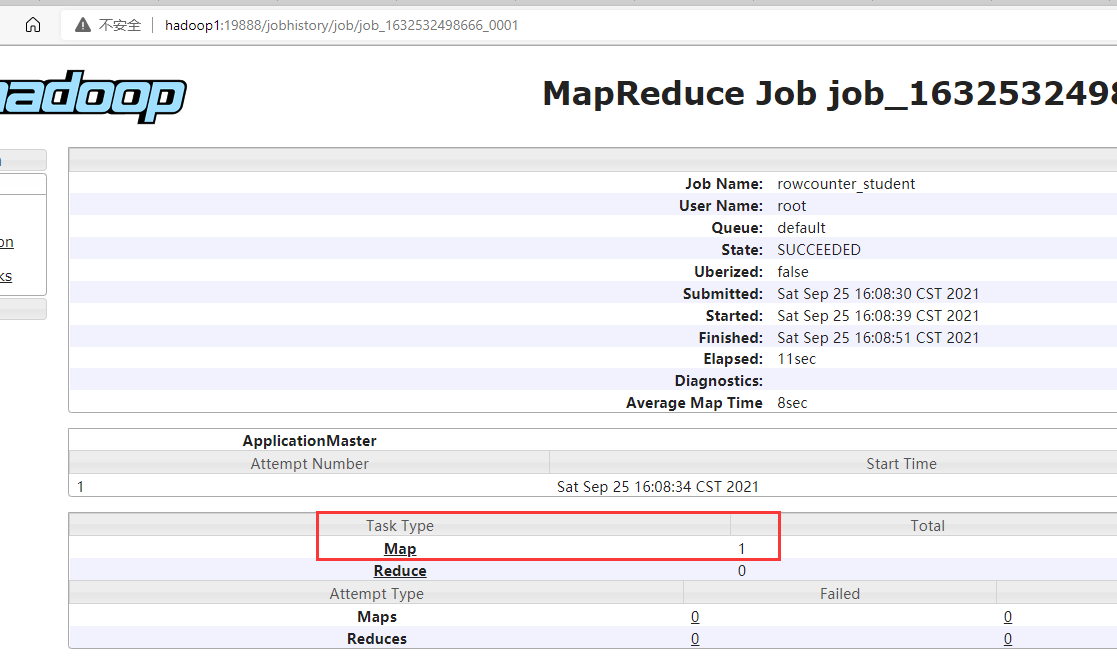
从下图可知:只有一个 map 任务:
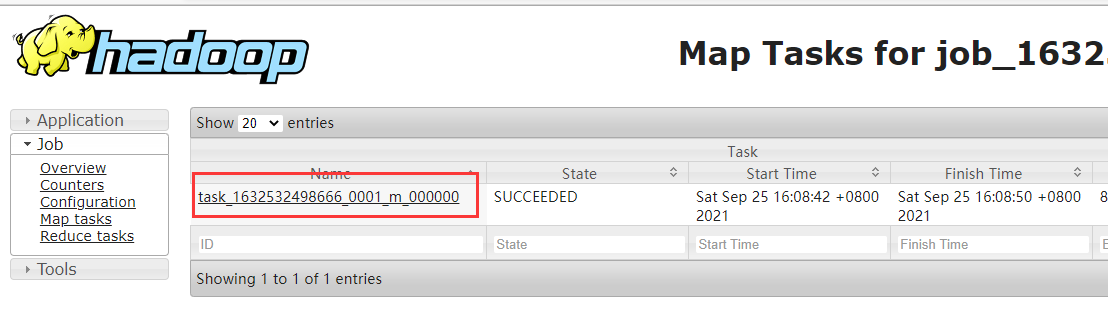
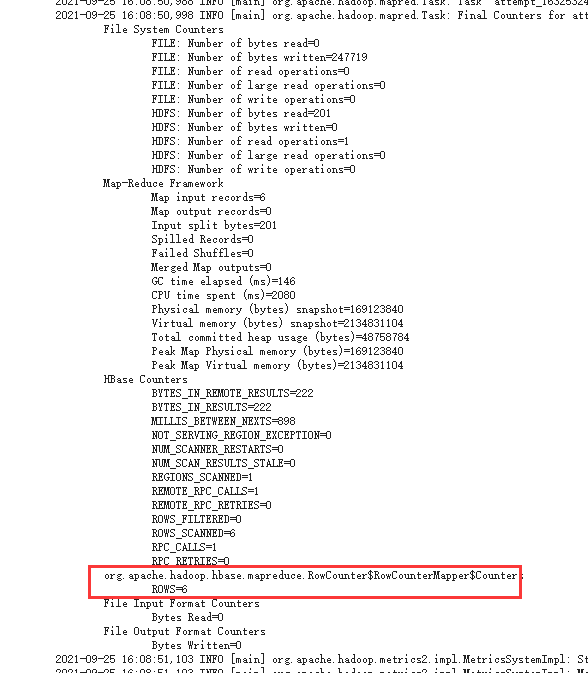
如上图,共有6行记录:
ROWS=6