需要掌握:flink1.12.x Table API 和 SQL:sink将查询结果写入到文件(非聚合查询)
说明
- 从
HDFS读取文件 - 执行查询
- 将查询结果 写入到
HDFS - 打成
jar包 - 上传到flink集群,通过
flink run执行jar
代码
package test;

import org.apache.flink.api.common.RuntimeExecutionMode;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.table.api.EnvironmentSettings;
import org.apache.flink.table.api.Table;
import org.apache.flink.table.api.TableResult;
import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;
import org.apache.flink.types.Row;


public class TestFlinkTable {
    //读取文件(目录也可以)
    static String srcPath="hdfs://hadoop1:8020/test/flink.csv";
    //写入目录
    static String savePath="hdfs://hadoop1:8020/result4";

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        env.setRuntimeMode(RuntimeExecutionMode.AUTOMATIC);//自动模式,根据数据源自行判断

        //构建Table环境
        EnvironmentSettings bsSettings = EnvironmentSettings.newInstance().useBlinkPlanner().inStreamingMode().build();
        StreamTableEnvironment stEnv = StreamTableEnvironment.create(env, bsSettings);

        /*
        注意不要出现关键字,如:order等
        需要依赖flink-csv
         */
        TableResult table=stEnv.executeSql("CREATE TABLE t_order (" +
                "  name STRING," +
                "  price double," +
                "  username STRING" +
                ") WITH ( " +
                "  'connector' = 'filesystem'," +
                "  'path' = '"+srcPath+"'," +
                "  'format' = 'csv'," +
                "  'csv.field-delimiter' = ','" +
                ")");
        /*
        创建结果表

         */
        TableResult sinkTable=stEnv.executeSql("CREATE TABLE sink_order (" +
                "  username STRING," +
                "  price double" +
                ") WITH ( " +
                "  'connector' = 'filesystem'," +
                "  'path' = '"+savePath+"'," +
                "  'csv.disable-quote-character' ='true'," +
                "  'format' = 'csv'," +
                "  'csv.field-delimiter'=','" +
                ")");

        //执行查询
        Table res=stEnv.sqlQuery("select username,price from t_order where price>60");
        System.out.println("Schema信息:");
        //打印Schema
        res.printSchema();

        /*
        不写报错
         No operators defined in streaming topology. Cannot execute.
         */
        DataStream<Tuple2<Boolean, Row>> dsRes = stEnv.toRetractStream(res, Row.class);
        dsRes.print();

        stEnv.executeSql("insert into sink_order select * from "+res);
//        res.executeInsert("sink_order");

        env.execute();
    }

}
idea 打包
执行 maven 的 package 命令
在 target 目录下找到 jar 包
包名改为:test_flink_sql.jar
启动环境
启动zookeeper
cd /program/bin/
./zk.sh start
启动hadoop
cd /program/bin/
./hadoop.sh start
上传
将 test_flink_sql.jar 包上传到 hadoop1 的 /program 目录下
执行
默认执行:
/program/flink-1.12.5/bin/flink run -c test.TestFlinkTable /program/test_flink_sql.jar
查看
查看 8081 服务
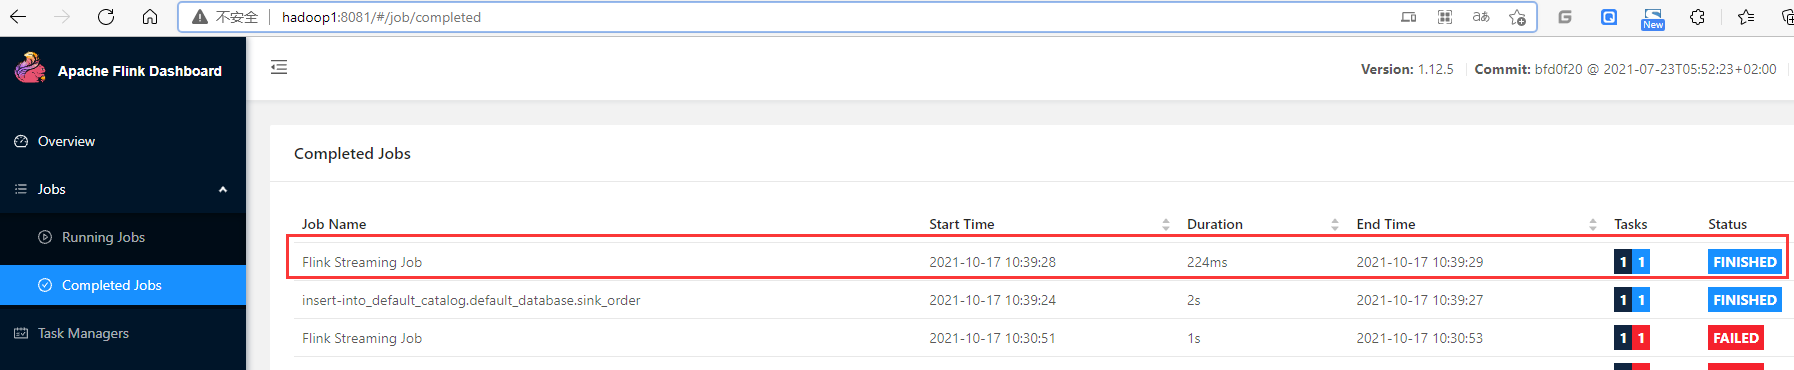
查看 8082 服务
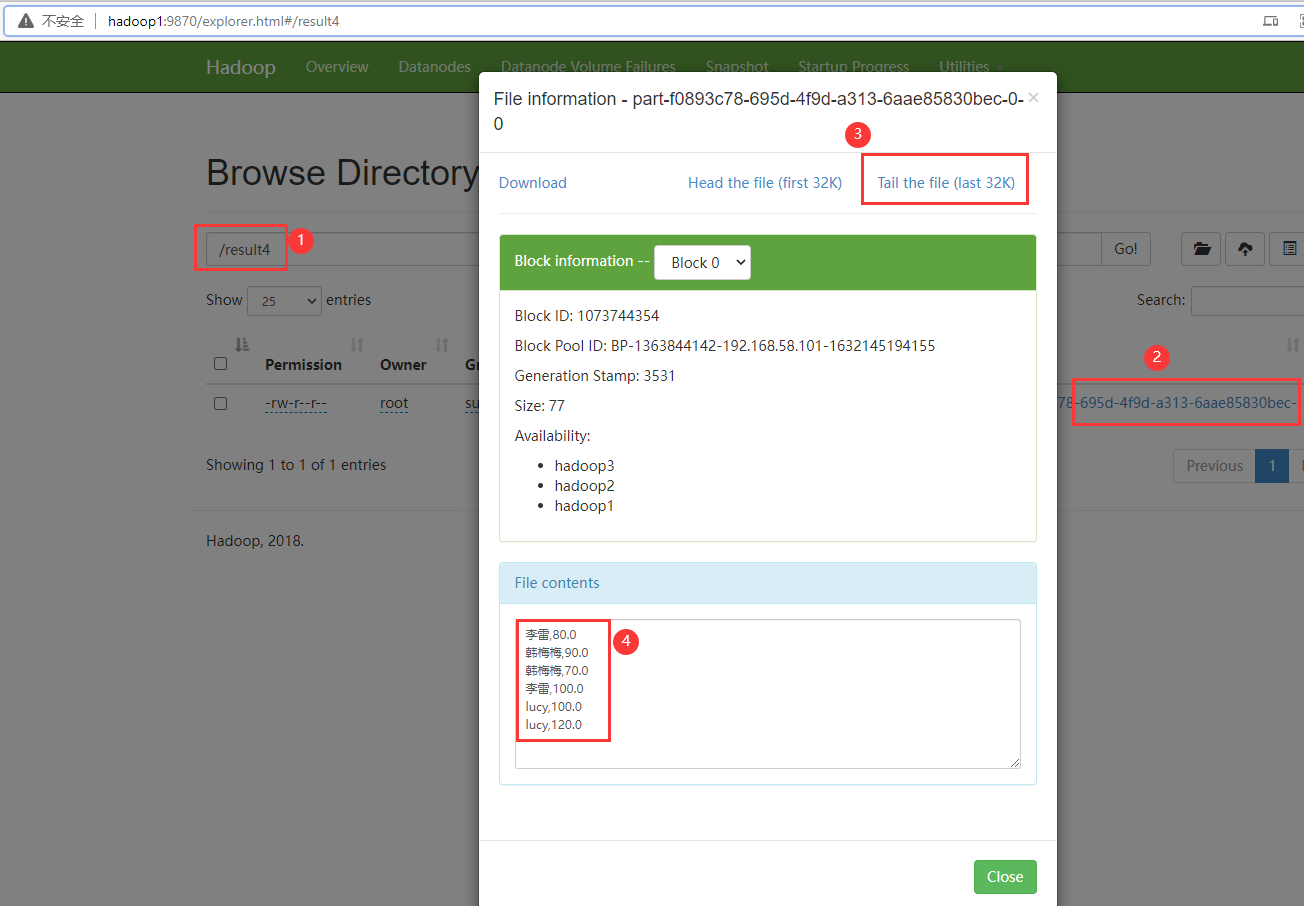
查看 hdfs 结果文件
http://hadoop1:9870/explorer.html#/