介绍
读取文件,将查询结果写入到 elasticsearch,可支持 upsert 模式,在聚合查询时,来一条数据,计算一条,并将上一次聚合结果更新
注意:必须指定 主键,否则不支持 upsert 模式
pom.xml
添加依赖
<dependency>
    <groupId>org.apache.flink</groupId>
    <artifactId>flink-csv</artifactId>
<version>${flink.version}</version>
</dependency>
<dependency>
    <groupId>org.apache.flink</groupId>
    <artifactId>flink-connector-elasticsearch7_2.12</artifactId>
    <version>${flink.version}</version>
</dependency>
<dependency>
    <groupId>org.apache.flink</groupId>
    <artifactId>flink-json</artifactId>
    <version>${flink.version}</version>
</dependency>
完整依赖
<properties>
    <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
    <maven.compiler.source>1.8</maven.compiler.source>
    <maven.compiler.target>1.8</maven.compiler.target>
    <flink.version>1.12.0</flink.version>

</properties>

<dependencies>
<dependency>
    <groupId>org.apache.flink</groupId>
    <artifactId>flink-table-planner-blink_2.12</artifactId>
    <version>${flink.version}</version>
</dependency>

    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-clients_2.12</artifactId>
        <version>${flink.version}</version>
    </dependency>
    <dependency>
        <groupId>org.slf4j</groupId>
        <artifactId>slf4j-api</artifactId>
        <version>1.7.30</version>
    </dependency>
    <dependency>
        <groupId>org.slf4j</groupId>
        <artifactId>slf4j-log4j12</artifactId>
        <version>1.7.30</version>
    </dependency>
    <dependency>
        <groupId>log4j</groupId>
        <artifactId>log4j</artifactId>
        <version>1.2.17</version>
    </dependency>
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-csv</artifactId>
        <version>${flink.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-connector-kafka_2.12</artifactId>
        <version>${flink.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-json</artifactId>
        <version>${flink.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-connector-elasticsearch7_2.12</artifactId>
        <version>${flink.version}</version>
    </dependency>
</dependencies>
准备数据
在 工程目录下创建 data 文件夹,在该文件夹下创建 flink.csv 文件,内容如下:
java从入门到精通,50,李雷
java从入门到精通,80,李雷
hadoop从入门到精通,90,韩梅梅
flink从入门到精通,70,韩梅梅
mysql从入门到精通,100,李雷
hive从入门到精通,100,lucy
html从入门到精通,120,lucy
ES 准备
启动 ES
登录 hadoop1 ,
切换 es 用户
su es
启动:
/program/elasticsearch-7.9.3/bin/elasticsearch -d
启动 kibana
详见 链接
使用 root 用户执行下面命令:
nohup /program/kibana-7.9.3/bin/kibana --allow-root &
查看是否启动:
netstat -npl | grep 5601
结果如下:
tcp 0 0 192.168.58.102:5601 0.0.0.0:* LISTEN 3064/./../node/bin/
进程id是 3064
停止服务
kill -9 上面查看的进程id
创建索引 且 指定映射
put /user_order
{
  "mappings": {
    "properties": {
      "name": {
        "type": "text"
      },
      "price": {
        "type": "double"
      }
    }
  }
}
返回结果:
{
    "acknowledged": true,
    "shards_acknowledged": true,
    "index": "user_order"
}
表示成功
java
连接es
TableResult sinkTable=stEnv.executeSql("CREATE TABLE t_order_output ( \n" +
            "  name STRING, \n" +
            "  price double, \n" +
            "  PRIMARY KEY (name) NOT ENFORCED \n" + //必须指定主键,才能以 upsert 模式运行,即:更新、删除
            ") WITH (  \n" +
            "'connector' = 'elasticsearch-7', \n"+//表示连接ES
            "'hosts' = 'http://hadoop1:9200', \n"+//服务器
            "'index' = 'user_order' \n"+
            ")");
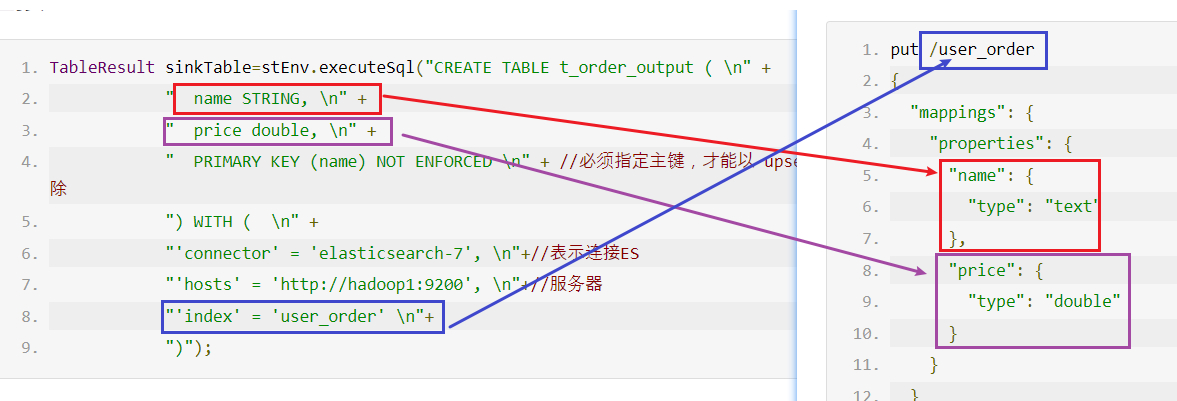
注意: 必须要指定 主键,才能以 upsert 模式运行,即:更新、删除
否则只能以 append 模式运行
官网:
https://ci.apache.org/projects/flink/flink-docs-release-1.12/dev/table/connectors/elasticsearch.html
The connector can operate in upsert mode for exchanging UPDATE/DELETE messages with the external system using the primary key defined on the DDL.

If no primary key is defined on the DDL, the connector can only operate in append mode for exchanging INSERT only messages with external system.
完整代码
package test;

import org.apache.flink.api.common.RuntimeExecutionMode;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.table.api.EnvironmentSettings;
import org.apache.flink.table.api.Table;
import org.apache.flink.table.api.TableResult;
import org.apache.flink.table.api.bridge.java.StreamTableEnvironment;
import org.apache.flink.types.Row;

public class TestES {

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        env.setRuntimeMode(RuntimeExecutionMode.AUTOMATIC);//自动模式,根据数据源自行判断

        //构建Table环境
        EnvironmentSettings bsSettings = EnvironmentSettings.newInstance().useBlinkPlanner().inStreamingMode().build();
        StreamTableEnvironment stEnv = StreamTableEnvironment.create(env, bsSettings);

        /*
        注意不要出现关键字,如:order等
        需要依赖flink-csv
         */
        TableResult table=stEnv.executeSql("CREATE TABLE t_order (" +
                "  name STRING," +
                "  price double," +
                "  username STRING" +
                ") WITH ( " +
                "  'connector' = 'filesystem'," +
                "  'path' = './data/flink.csv'," +
                "  'format' = 'csv'," +
                "  'csv.field-delimiter' = ','" +
                ")");
        //执行查询
        Table res=stEnv.sqlQuery("select username,avg(price) from t_order where price>60 group by username");
        System.out.println("Schema信息:");
        //打印Schema
        res.printSchema();

        /*
        需要将结果转换成DataStream,才能打印结果,需要指定 封装的泛型
        将计算后的数据,在ds原数据基础上更新
        true:表示更新
        false:表示删除
         */
        DataStream<Tuple2<Boolean, Row>> dsRes = stEnv.toRetractStream(res, Row.class);
        dsRes.print("===");

        /*
        创建结果表

         */
        TableResult sinkTable=stEnv.executeSql("CREATE TABLE t_order_output ( \n" +
                "  name STRING, \n" +
                "  price double, \n" +
                "  PRIMARY KEY (name) NOT ENFORCED \n" + //必须指定主键,才能以 upsert 模式运行,即:更新、删除
                ") WITH (  \n" +
                "'connector' = 'elasticsearch-7', \n"+//表示连接ES
                "'hosts' = 'http://hadoop1:9200', \n"+//服务器
                "'index' = 'user_order' \n"+
                ")");


        stEnv.executeSql("insert into t_order_output select * from "+res);

        env.execute("test_sink_es");
    }
}