自定义序列化类
当 hadoop序列化类型不能满足需求时,比如在Hadoop中传递一个 Book 对象,可以自定义实现
如下:
- 必须实现
Writable接口 反序列化时,需要反射调用 无参构造方法,所以必须有无参构造方法
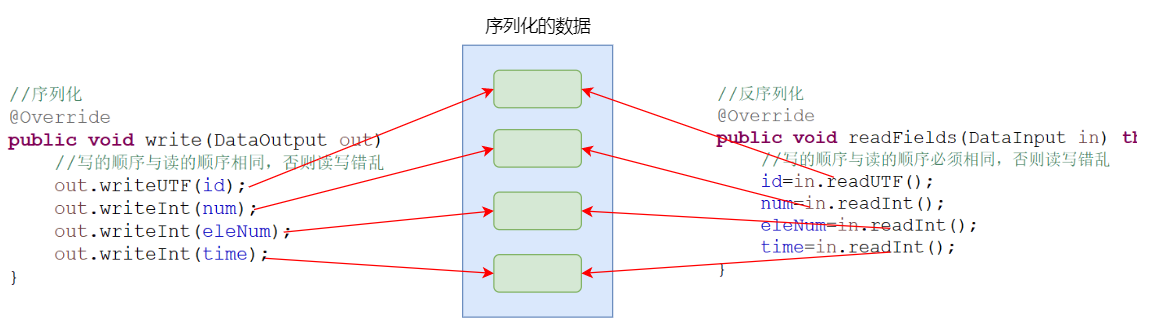
重写序列化方法
write(DataOutput out)重写反序列化方法
readFields(DataInput in)
注意:
序列化方法中的 写数据 顺序 和 反序列化方法中的 读数据 顺序,必须一致,否则读写的数据就会错乱
写入文件
如果要写入文件,需要重写 toString(),需要定义分隔符分割字段
如:
分隔符
,:java从入门到放弃,马老师,58分隔符
|:java从入门到放弃|马老师|58
作为key使用
因为 MapReduce 中的 Shuffle 过程要求 key 必须能排序
所以将 Book对象 作为key,需要实现 WritableComparable 接口