MapTask并行度
指同时有 几个 Map Task在执行
在之前的例子中,发现以下规律:
MapReduce程序读取一个目录的文件时,
如果该目录有 1个小文件,那么就只有 1个 map task执行
如果该目录有 2个小文件,那么就只有 2个 map task 执行
那么,是什么原因决定 MapTask并行度?
MapTask并行度 决定机制
客户端提交 job前,会 对数据进行 逻辑切片,也就是 数据切片
数据切片相当于 城区,为了便于管理,逻辑上将一个城市划分几个城区,而不会像 国界 那样物理上分开
只是在 逻辑 上对文件进行分片,而不会在磁盘上将文件拆分。
数据切片是 MapReduce 程序计算输入数据的单位,一个切片会对应启动一个MapTask
切片大小
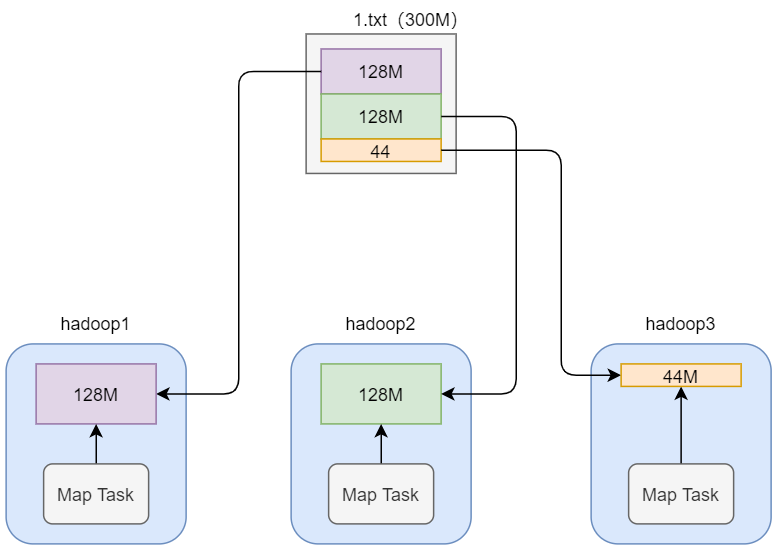
数据切片有大小,即:切片大小
默认 切片大小=block size(hdfs中的block,默认大小128M)
所以,文件在 HDFS 中分几个block,就分几个切片,也就有 几个 Map Task
如果 切片大小 不等于 block size
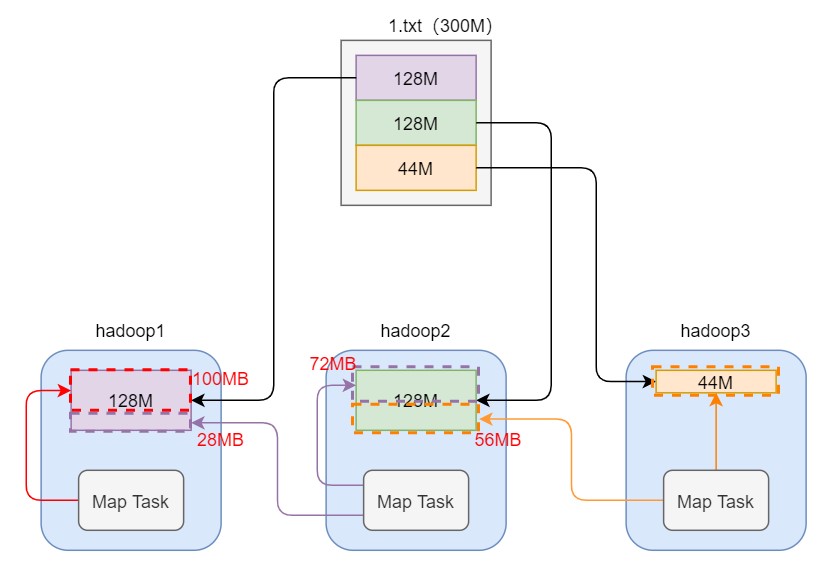
map task需要跨服务器读取数据,效率低下
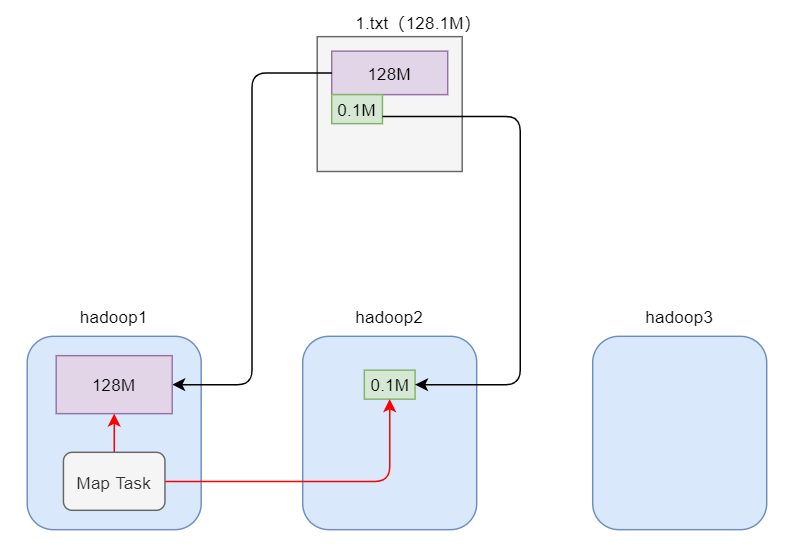
大于 切片的 10%(1.1倍) 才切分
当 文件大小,大于切片大小的 10%(1.1倍) 时,才进行拆分,否则作为整体处理
防止一个 128.1 M 的文件,也被切分成2块,由 2 个 Map Task运行
多个文件互不影响
当一个文件切片完成后,下一个文件重新开始切片,文件之间的切片互不影响
切片规划文件
将切片信息写到 切片规划文件
提交到yarn
将 切片规划文件 提交到 yarn,MrAppMaster 根据该文件的切片数量,开启相应 Map Task 个数
切片源码
FileInputFormat
在 org.apache.hadoop.mapreduce.lib.input.FileInputFormat 的 getSplits() 方法中
定义切片的最小值
long minSize = Math.max(getFormatMinSplitSize(), getMinSplitSize(job));
定义切片的最大值:
long maxSize = getMaxSplitSize(job);
395行遍历文件:
for (FileStatus file: files) {
开始切片
//判断文件是否可以切片
if (isSplitable(job, path)) {
  //获取 block大小,本地运行是 是32m,yarn运行时 128m
  long blockSize = file.getBlockSize();
  //将 block 和 最小、最大进行比对,返回切片大小
  long splitSize = computeSplitSize(blockSize, minSize, maxSize);

  long bytesRemaining = length;
  //当文件大小,大于切片大小的1.1倍时,才进行拆分,否则作为整体处理
  while (((double) bytesRemaining)/splitSize > SPLIT_SLOP) {
    int blkIndex = getBlockIndex(blkLocations, length-bytesRemaining);
    splits.add(makeSplit(path, length-bytesRemaining, splitSize,
                blkLocations[blkIndex].getHosts(),
                blkLocations[blkIndex].getCachedHosts()));
    bytesRemaining -= splitSize;
  }

  if (bytesRemaining != 0) {
    int blkIndex = getBlockIndex(blkLocations, length-bytesRemaining);
    splits.add(makeSplit(path, length-bytesRemaining, bytesRemaining,
               blkLocations[blkIndex].getHosts(),
               blkLocations[blkIndex].getCachedHosts()));
  }
}
切片方式如下:
1.log 300m
2.log 10m
切片为:
1.log 第1片: 0-128m
1.log 第2片: 128m-256m
1.log 第3片: 256m-300m
2.log 第1片: 0-10m
JobSubmitter
321行
    Arrays.sort(array, new SplitComparator());
    JobSplitWriter.createSplitFiles(jobSubmitDir, conf,
        jobSubmitDir.getFileSystem(conf), array);
    return array.length;
将切片信息写入到文件中