reduce流程
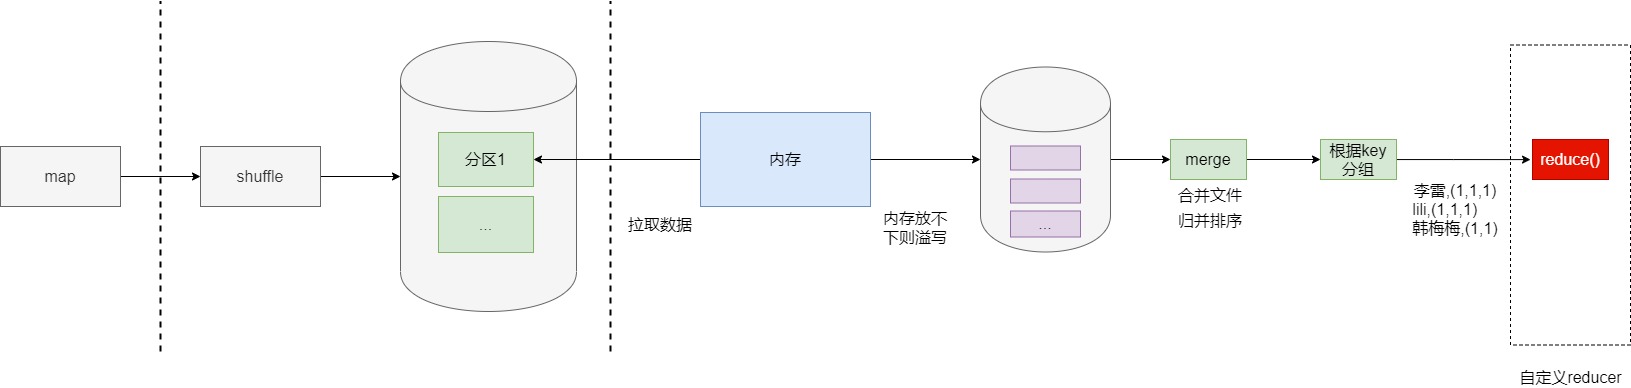
拉取数据
reduce 从磁盘中拉取 map的结果,放到内存中(内存效率高)
注意: map 不会将结果发送给 reduce
溢写
当内存写不下时,就会溢写到磁盘上
每次溢写都会生成一个新的文件
merge
将 溢写的多个文件,合并(merge)成一个文件
sort
根据 key 进行排序,默认按照 字典序 排序
作用:为了实现分组
reduce
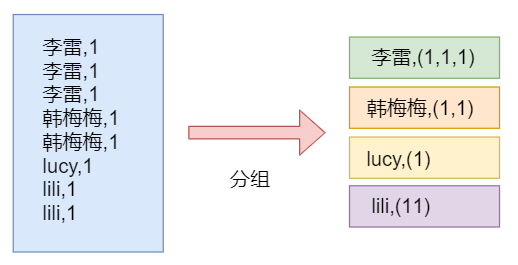
分组
对 key 进行排序后,就可以根据 key 进行分组
调用 reduce() 方法
每一组数据,调用一次 自定义类的 reduce() 方法
输出结果
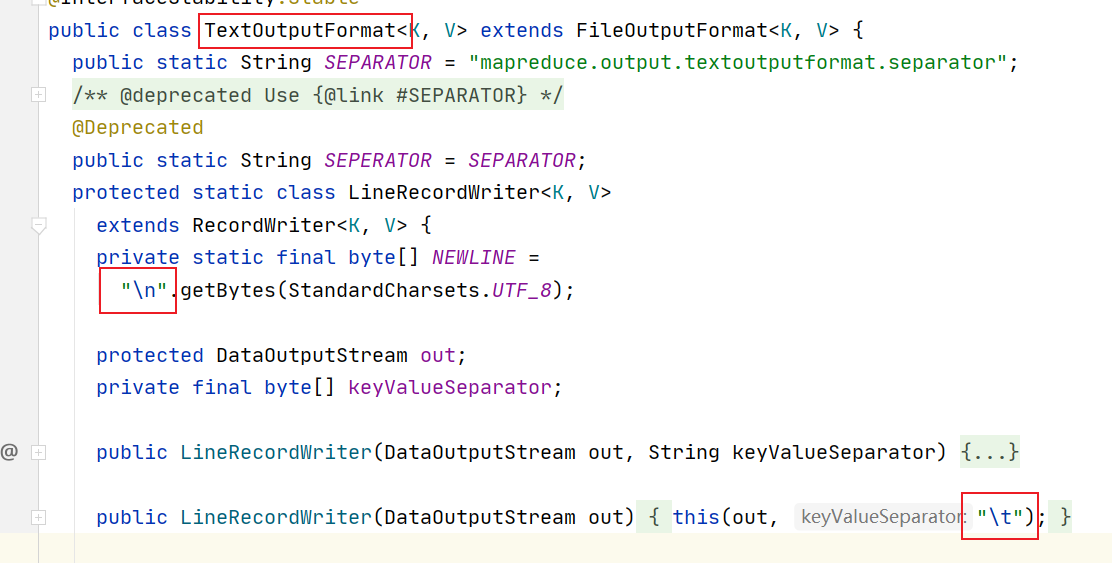
调用 TextOutputFormat 组件,将数据写入到目录中
TextOutputFormat 默认是一次写一行数据,key 和 value 之间由 \t 分割