shuffle
本意是 洗牌,在很多编程框架中都有类似概念,但具体含义有些差别
在 MapReduce 中,shuffle 处于 map 和 reduce 的中间阶段
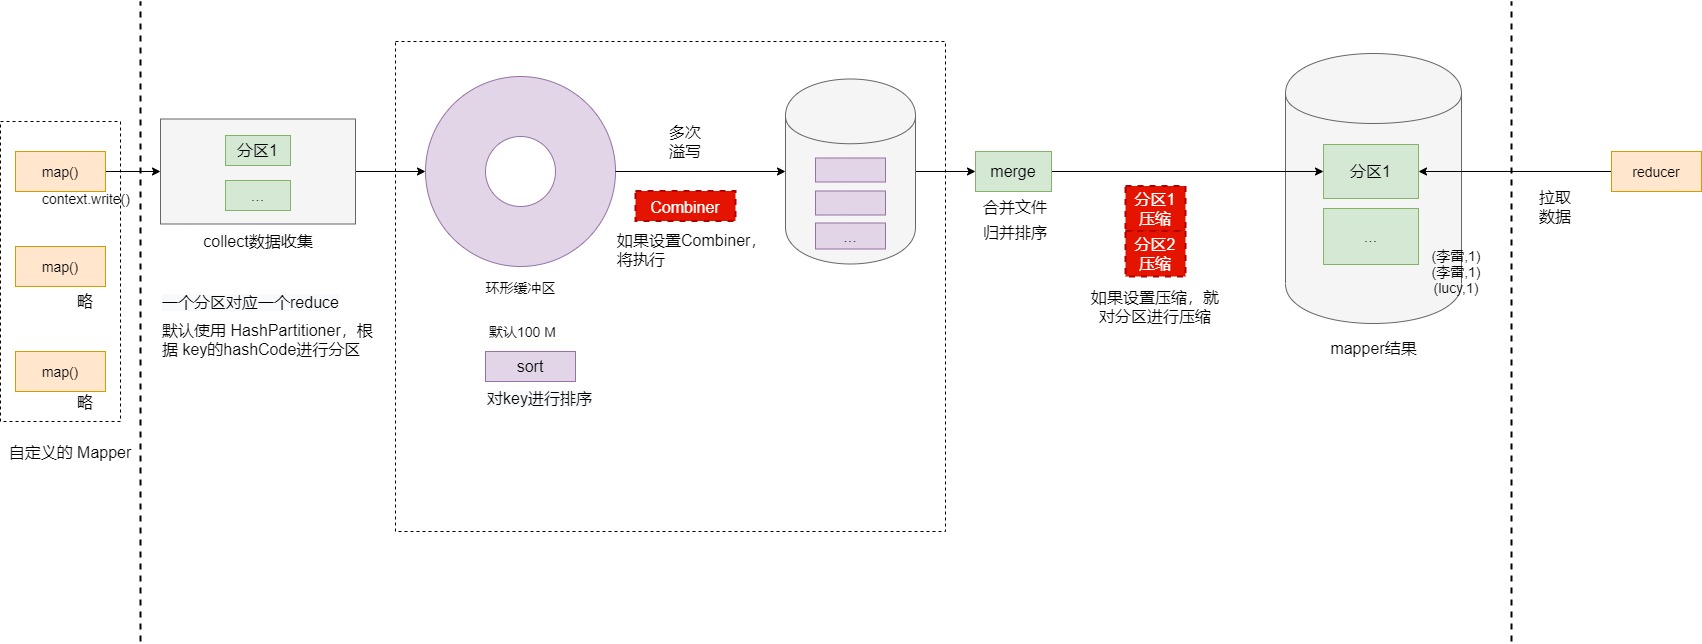
collect阶段
map调用 context.write() 后,由 collect 收集数据。
在 collect中,会根据 key 进行 分区处理
分区
分区数量,与 reduce task 的数量相关。一般,几个reduce task,就有几个 分区
默认使用
HashPartitioner,根据 key的hasoCode进行分区可以自定义分区
环形缓冲区
collect 分区后,将数据(即:key/value),序列化 成字节数组,放入 环形缓冲区
当结果很多时,缓冲区就会不够用,将内存中的数据写入磁盘,然后 重新利用这块缓冲区
写入磁盘,就叫 溢写
本质
就是 内存,默认 100 M
作用
收集 map 结果,减少磁盘 IO 次数
溢写阶段 (spill)
将环形缓冲区中的数据写入磁盘,就是 溢写, spill
触发溢写条件
当缓冲区的数据达到 缓冲区的 80% 时(100M * 80% =80M),就启动 溢写线程;
溢写特点
溢写 由 单独线程 来完成,不影响往 缓冲区 写map结果的线程,即:还可以同时往剩下的
20%内存 写数据每次溢写,会在磁盘上生成一个临时文件
排序
启动 溢写线程后,对这 80M 内存中 key做排序(sort)
combiner
如果设置了 combiner,就执行,优化 map task结果,减少溢写数据量
合并阶段 (merge)
由于 每次溢写,会在磁盘上生成一个临时文件,所以该阶段,对磁盘上临时文件做合并(merge),最终的文件只有一个,写入磁盘
压缩
如果设置压缩,就会对数据压缩后,在写入磁盘