为什么要分区
当数据特别多时,要根据业务情况拆分数据,便于做后期处理
如:
电商平台、电信公司:要根据月份、省份拆分订单数据,便于后面做 每月各省 统计分析
气象部门:将气象数据按照省份、城市拆分,做气象预测
说明
Partition分区所在的位置,在 shuffle 阶段
将 MapReduce 结果,按照一定规则进行分区,最后,有几个分区,就生成几个文件
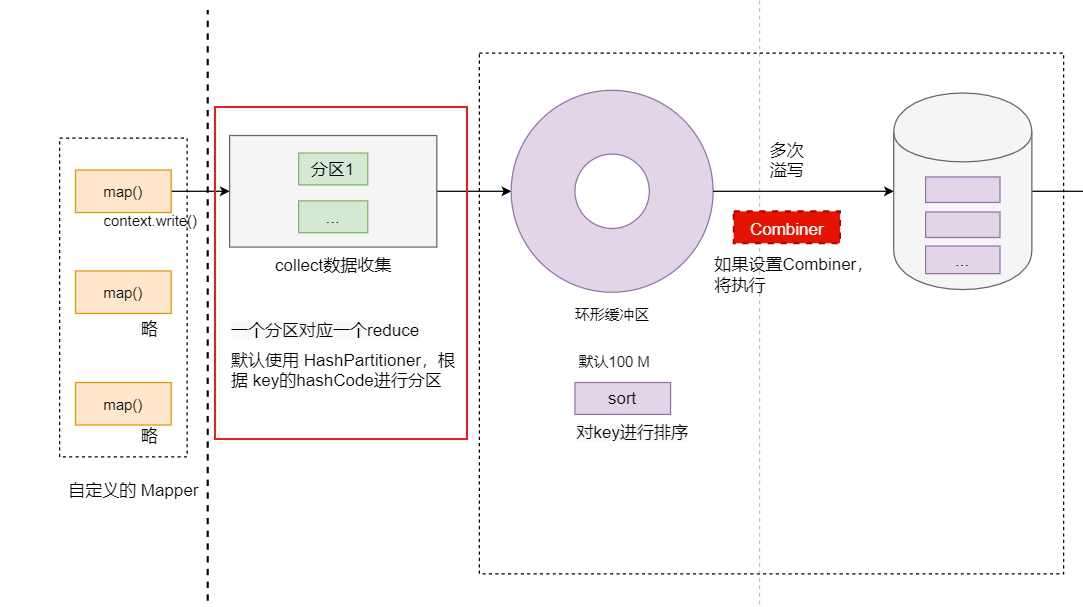
Partition 实现
org.apache.hadoop.mapreduce.Partitioner 是抽象类,默认使用 org.apache.hadoop.mapreduce.lib.partition.HashPartitioner
源码如下:
public class HashPartitioner<K, V> extends Partitioner<K, V> {

  public int getPartition(K key, V value,
                          int numReduceTasks) {
    return (key.hashCode() & Integer.MAX_VALUE) % numReduceTasks;
  }

}
解释
key.hashCode() & Integer.MAX_VALUE 的作用
Integer.MAX_VALUE 在计算中表示为:符号位(第一位)为 0, 代表正数;数值(后面)全为1,如下:
01111111 11111111 11111111 11111111
4个字节,一个字节8位
& 与运算的规则是:
0&0=0; 0&1=0; 1&0=0; 1&1=1;
所以任意的 int 数值对 Integer.MAX_VALUE 进行 &(与运算时),会得到其 绝对值
% numReduceTasks 的作用
对 numReduceTasks 取余,如果 numReduceTasks=2,那么 getPartition() 方法返回 0 或 1
总结
默认分区是根据 key 的 hashCode 值,对 numReduceTasks 取余,具体 key 存到哪个配置文件无法控制