说明
读取HDFS上的文件,统计词频
准备文件
vim data.txt
内容:
李雷  lucy
韩梅梅 李雷
lucy  韩梅梅
lili 李雷
张三  lucy
李四  韩梅梅
王五  韩梅梅
李雷  lucy
韩梅梅
lucy 李雷
李雷 李雷
韩梅梅  lucy
李雷 韩梅梅
上传到 HDFS 的 /data 目录下
代码
# 初始化spark环境
import findspark
findspark.init()
# 导包
from pyspark import  SparkConf, SparkContext

# 创建 SparkContext 对象
# 方式一
# sc = SparkContext( 'local[*]', 'pyspark')
# 方式二
conf = SparkConf().setMaster("local[*]").setAppName("wordcount")
sc = SparkContext(conf = conf)

textFile = sc.textFile("hdfs:///data/data2.txt") # 读取hdfs文件
# textFile = sc.textFile("file:///program/data4.txt") # 读取本地文件
rdd = textFile.flatMap(lambda line:line.split(" "))
rdd2 = rdd.map(lambda e:(e,1))
rdd3 = rdd2.reduceByKey(lambda a, b: a + b)
rdd3.foreach(print)
上传到linux
运行
打开 SSH控制台
点击下图红框处:

弹出界面如下:

输入密码,敲回车,就能登录成功
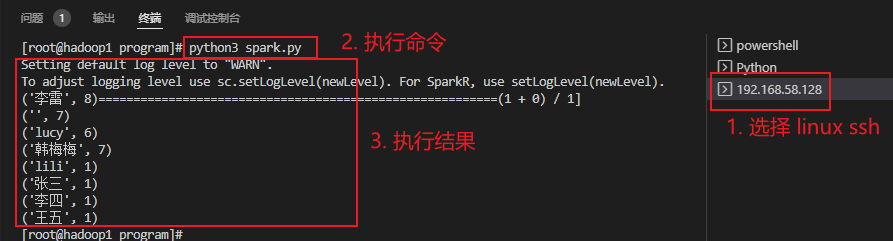
按照下图,执行下面命令:
python3 spark.py