说明
flink 提供 JDBC Connector ,用于 JDBC 连接数据库,并把数据保存到数据库中
官网:
https://nightlies.apache.org/flink/flink-docs-release-1.13/zh/docs/connectors/datastream/jdbc/
方法声明一
public static <T> SinkFunction<T> sink(String sql, JdbcStatementBuilder<T> statementBuilder, JdbcConnectionOptions connectionOptions)
形参:
- sql:sql语句
- statementBuilder:传入
PreparedStatement - JdbcConnectionOptions:封装 url、驱动类、用户名、密码
方法声明二
public static <T> SinkFunction<T> sink(String sql, JdbcStatementBuilder<T> statementBuilder, JdbcExecutionOptions executionOptions, JdbcConnectionOptions connectionOptions)
形参:
- sql:sql语句
- statementBuilder:传入
PreparedStatement - JdbcExecutionOptions:设置 jdbc 选项,如:每n条记录执行一次插入
- JdbcConnectionOptions:封装 url、驱动类、用户名、密码
JdbcExecutionOptions
创建 JDBC 执行配置
JdbcExecutionOptions.builder()
        .withBatchSize(2000) // 每5000个数据,执行一次插入。默认是5000
        .withBatchIntervalMs(1000) // 每次批量写入最小间隔时间,默认值0
        .withMaxRetries(3) // 重试次数,默认值 3。插入发生异常重试次数 注意:只支持SQL Exception 异常及其子类异常重试
JdbcConnectionOptions
创建 JDBC 连接配置
String url = "jdbc:mysql://hadoop1:3306/flink?useSSL=false&useUnicode=true&characterEncoding=utf-8";
String driver = "com.mysql.jdbc.Driver";
String username = "root";
String password = "root";

new JdbcConnectionOptions.JdbcConnectionOptionsBuilder()
        .withUrl(url)
        .withDriverName(driver)
        .withUsername(username)
        .withPassword(password)
        .build()
简单案例
pom.xml
增加依赖:
<dependency>
    <groupId>org.apache.flink</groupId>
    <artifactId>flink-connector-jdbc_2.12</artifactId>
    <version>${flink.version}</version>
</dependency>
<dependency>
    <groupId>mysql</groupId>
    <artifactId>mysql-connector-java</artifactId>
    <version>5.1.47</version>
</dependency>
完整依赖见 链接
java
package sink;

import org.apache.flink.api.common.typeinfo.Types;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.connector.jdbc.JdbcConnectionOptions;
import org.apache.flink.connector.jdbc.JdbcSink;
import org.apache.flink.streaming.api.datastream.DataStreamSource;
import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.functions.sink.SinkFunction;

public class ToMySQL {
    public static void main(String[] args) throws Exception {

        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(2);

        DataStreamSource<String> dss = env.fromElements("lilei", "lili", "lilei", "lucy", "lili");

        SingleOutputStreamOperator<Tuple2<String, Integer>> mapSOSO = dss.map(item -> Tuple2.of(item, 1))
                .returns(Types.TUPLE(Types.STRING,Types.INT));

        SingleOutputStreamOperator<Tuple2<String, Integer>> sumSOSO = mapSOSO.keyBy(item -> item.f0).sum(1);

        String sql = "insert into test_result (keyword,count) values (?,?)";

        String url = "jdbc:mysql://hadoop1:3306/flink?useSSL=false&useUnicode=true&characterEncoding=utf-8";
        String driver = "com.mysql.jdbc.Driver";
        String username = "root";
        String password = "root";
        // 创建 JDBC 连接配置
        JdbcConnectionOptions jdbcConnectionOptions = new JdbcConnectionOptions.JdbcConnectionOptionsBuilder()
                        .withUrl(url)
                        .withDriverName(driver)
                        .withUsername(username)
                        .withPassword(password)
                        .build()
        // 连接 mysql5.7
        SinkFunction<Tuple2<String, Integer>> mysqlSink = JdbcSink.<Tuple2<String, Integer>>sink(sql
                , (ps, data) -> { // 每一条数据,都会执行该方法
                    ps.setString(1, data.f0); //PreparedStatement 给?绑定参数
                    ps.setInt(2, data.f1);
                }
                , jdbcConnectionOptions
        );

        sumSOSO.addSink(mysqlSink);

        env.execute();
    }
}
mysql数据库
启动mysql
详见 链接
建库
CREATE DATABASE `flink` CHARACTER SET 'utf8mb4' COLLATE 'utf8mb4_unicode_ci';
建表
CREATE TABLE `test_result` (
  `id` int(11) NOT NULL AUTO_INCREMENT,
  `keyword` varchar(255) COLLATE utf8mb4_unicode_ci DEFAULT NULL,
  `count` int(11) DEFAULT NULL,
  PRIMARY KEY (`id`)
) ENGINE=InnoDB  DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_unicode_ci;
测试
运行代码
结果
mysql表中的数据如下:
1    lilei    1
2    lilei    2
3    lili    1
4    lili    2
5    lucy    1
由于是流式数据,数据来一个,flink运行一次,保存数据库一次,所以 keyword 会重复出现多次
kafka 案例
flink
import org.apache.flink.api.common.functions.FlatMapFunction;
import org.apache.flink.api.common.serialization.SimpleStringSchema;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.connector.jdbc.JdbcConnectionOptions;
import org.apache.flink.connector.jdbc.JdbcExecutionOptions;
import org.apache.flink.connector.jdbc.JdbcSink;
import org.apache.flink.streaming.api.datastream.DataStreamSource;
import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.functions.sink.SinkFunction;
import org.apache.flink.streaming.connectors.kafka.FlinkKafkaConsumer;
import org.apache.flink.util.Collector;
import org.apache.kafka.clients.consumer.ConsumerConfig;

import java.util.Properties;

public class StdWordcountJdbc {

    public static void main(String[] args) throws Exception {
        final StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

        env.setParallelism(2);

        // 定义kafka相关配置项
        Properties pro = new Properties();
        pro.setProperty(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG,"hadoop1:9092,hadoop2:9092,hadoop3:9092");
        pro.setProperty(ConsumerConfig.GROUP_ID_CONFIG,"consumer-group");
        pro.setProperty(ConsumerConfig.AUTO_OFFSET_RESET_CONFIG,"latest");
        // 内置连接器,创建FlinkKafka消费者,需要指定主题、反序列化、kafka配置
        FlinkKafkaConsumer<String> fkc = new FlinkKafkaConsumer<>("wordcount", new SimpleStringSchema(), pro);
        DataStreamSource<String> dss = env.addSource(fkc);

        SingleOutputStreamOperator<Tuple2<String,Integer>> sso = dss.flatMap(new FlatMapFunctionImpl())
                .keyBy(value -> value.f0)
                .sum(1);

        String sql = "insert into test_result (keyword,count) values (?,?)";
        String url = "jdbc:mysql://hadoop1:3306/flink?useSSL=false&useUnicode=true&characterEncoding=utf-8";
        String driver = "com.mysql.jdbc.Driver";
        String username = "root";
        String password = "root";
        // 连接 mysql5.7
        SinkFunction<Tuple2<String,Integer>> mysqlSink = JdbcSink.<Tuple2<String,Integer>>sink(sql
                , (ps, data) -> { // 每一条数据,都会执行该方法
                    ps.setString(1, data.f0); //PreparedStatement 给?绑定参数
                    ps.setInt(2, data.f1);
                },
                JdbcExecutionOptions.builder()
                        .withBatchSize(20) // 每20个数据,执行一次插入。默认是5000
                        .build()
                , new JdbcConnectionOptions.JdbcConnectionOptionsBuilder()
                        .withUrl(url)
                        .withDriverName(driver)
                        .withUsername(username)
                        .withPassword(password)
                        .build()
        );
        sso.addSink(mysqlSink);
        sso.print();
        env.execute();
    }


    static class FlatMapFunctionImpl implements FlatMapFunction<String, Tuple2<String,Integer>> {


        @Override
        public void flatMap(String value, Collector<Tuple2<String, Integer>> out) throws Exception {
            String[] arr = value.split(" ");
            for (String item : arr) {
                out.collect(Tuple2.of(item, 1));
            }
        }
    }
}
测试类
import com.fasterxml.jackson.core.JsonProcessingException;
import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.clients.producer.ProducerConfig;
import org.apache.kafka.clients.producer.ProducerRecord;

import java.util.Properties;

public class Producer_wordcount {
    final static String TOPIC = "wordcount";
    public static void main(String[] args) throws InterruptedException, JsonProcessingException {
        // 1. 创建 kafka 生产者的配置对象
        Properties properties = new Properties();
        // 2. 给 kafka 配置对象添加配置信息:bootstrap.servers
        properties.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG,"hadoop1:9092,hadoop2:9092,hadoop3:9092");
        // key,value 序列化(必须):key.serializer,value.serializer
        properties.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG,
                "org.apache.kafka.common.serialization.StringSerializer");
        // StringSerializer.class.getName() 等于 org.apache.kafka.common.serialization.StringSerializer
        properties.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG,
                "org.apache.kafka.common.serialization.StringSerializer") ;
        // 3. 创建 kafka 生产者对象
        KafkaProducer<String, String> kafkaProducer = new KafkaProducer(properties);

        // 4. 调用 send 方法,发送消息

        for (int i=0;i<10;i++) {
            kafkaProducer.send(new ProducerRecord(TOPIC, "李雷"));
        }
        // 5. 关闭资源
        kafkaProducer.close();
    }
}
测试
运行代码
结果
mysql表中的数据如下:
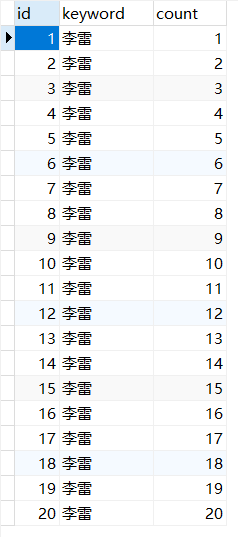
由于是流式数据,数据来一个,flink运行一次,所以 李雷 会重复出现多次