说明
根据 key 分组后,相同 key 的数据,攒够一定数量时,就会触发计算,计算时,会算上 历史数据
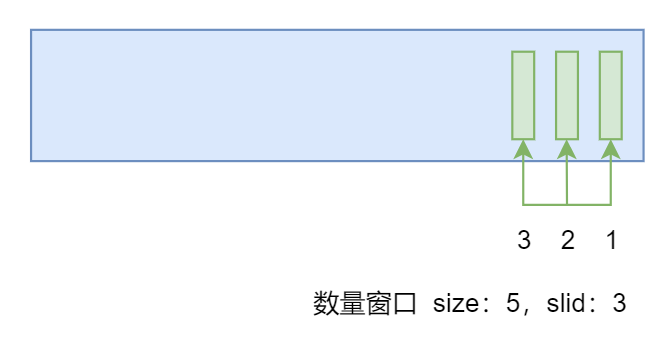
最开始计算方式
key 分组后,相同 key 的数据,攒够 3 条,触发计算,如下图:
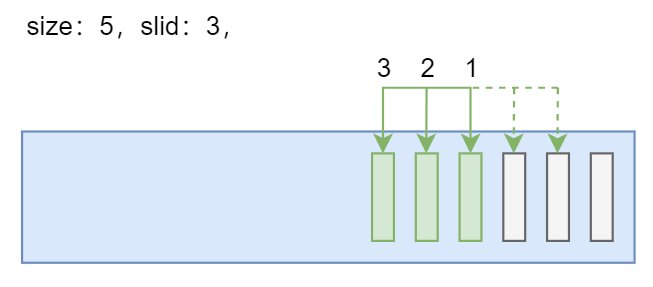
之后计算方式
key 分组后,相同 key 的数据,攒够3条,触发计算,并且 加上历史的 2 条,如下图:
案例
温度传感器发来 温度数据,由于发送数据太频繁,所以采用以下统计:
根据 传感器(id) 分组,相同传感器(id)的数据,每出现 3 次,统计该 传感器(id)的最大温度,并且算上历史的 2 条记录
发送数据格式:
{"id":"1","temp":35.3,"time":"2020-01-01 10:10:00"}
java
package countwindow;

import org.apache.flink.api.common.functions.MapFunction;
import org.apache.flink.api.common.serialization.SimpleStringSchema;
import org.apache.flink.api.java.functions.KeySelector;
import org.apache.flink.api.java.tuple.Tuple3;
import org.apache.flink.shaded.jackson2.com.fasterxml.jackson.databind.JsonNode;
import org.apache.flink.shaded.jackson2.com.fasterxml.jackson.databind.ObjectMapper;
import org.apache.flink.streaming.api.datastream.DataStreamSource;
import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.connectors.kafka.FlinkKafkaConsumer;
import org.apache.kafka.clients.consumer.ConsumerConfig;

import java.text.SimpleDateFormat;
import java.util.Date;
import java.util.Properties;

public class SlidingWindow {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(2);

        // 定义kafka相关配置项
        Properties pro = new Properties();
        pro.setProperty(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG,"hadoop1:9092,hadoop2:9092,hadoop3:9092");
        pro.setProperty(ConsumerConfig.GROUP_ID_CONFIG,"consumer-group");
        pro.setProperty(ConsumerConfig.AUTO_OFFSET_RESET_CONFIG,"latest");
        // 内置连接器,创建FlinkKafka消费者,需要指定主题、反序列化、kafka配置
        FlinkKafkaConsumer<String> fkc = new FlinkKafkaConsumer("kafka2flink", new SimpleStringSchema(), pro);
        DataStreamSource<String> dss = env.addSource(fkc);

        SingleOutputStreamOperator<Tuple3<String, Double, Date>> max = dss
                .map(new MyMap())
                .keyBy(new KeySelector<Tuple3<String, Double, Date>, String>() {

                    @Override
                    public String getKey(Tuple3<String, Double, Date> value) throws Exception {
                        return value.f0;
                    }
                })
                .countWindow(5,3)
                .max(1);// 根据索引是1的字段,取出最大值

        max.print();

        env.execute();
    }


    public static class MyMap implements MapFunction<String, Tuple3<String,Double,Date>>{
        @Override
        public Tuple3<String,Double,Date> map(String data) throws Exception {
            ObjectMapper om = new ObjectMapper();
            JsonNode jsonNode = om.readTree(data);
            JsonNode idJN = jsonNode.get("id");
            JsonNode tempJN = jsonNode.get("temp");
            JsonNode timeJN = jsonNode.get("time");

            String id = null;
            Double temp = null;
            Date time = null;

            if(idJN!=null){
                id = idJN.asText();
            }
            if(tempJN!=null){
                temp = tempJN.asDouble();
            }
            if(timeJN!=null){
                String timeStr = timeJN.asText();
                SimpleDateFormat sdf = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss");
                time = sdf.parse(timeStr);
            }
            return Tuple3.of(id,temp,time);
        }
    }
}
启动zk
登录 hadoop1,执行下面命令:
/program/bin/zk.sh start
启动kafka
登录 hadoop1,执行下面命令:
/program/bin/kafka.sh start
启动 flink
在 idea 中运行 flink 程序
创建生产者、指定主题
登录 hadoop1,执行下面命令:
/program/kafka_2.12-2.4.1/bin/kafka-console-producer.sh --broker-list hadoop1:9092,hadoop2:9092,hadoop3:9092 --topic kafka2flink
发送数据
{"id":"1","temp":35.3,"time":"2020-01-01 10:10:00"}
{"id":"1","temp":33.1,"time":"2020-01-01 10:12:00"}
{"id":"1","temp":22.5,"time":"2020-01-01 10:14:00"}
由于 id 是 1 的数据 攒够 3 条,所以 触发统计,执行结果:
1> (1,35.3,Wed Jan 01 10:10:00 CST 2020)
继续发送数据
{"id":"1","temp":22.5,"time":"2020-01-01 10:14:00"}
{"id":"1","temp":22.5,"time":"2020-01-01 10:14:00"}
{"id":"1","temp":22.5,"time":"2020-01-01 10:14:00"}
由于 id 是 1 的数据 攒够 3 条,所以 触发统计,但会 算上 历史的 2 条数据,即:总共 5 条数据,执行结果:
1> (1,33.1,Wed Jan 01 10:12:00 CST 2020)