介绍
Thrift JDBC Server 的作用是取代 HiveServer2,接口和协议都和 HiveServer2 完全一致,可以和 Hive Metastore进行交互,获取到hive的元数据
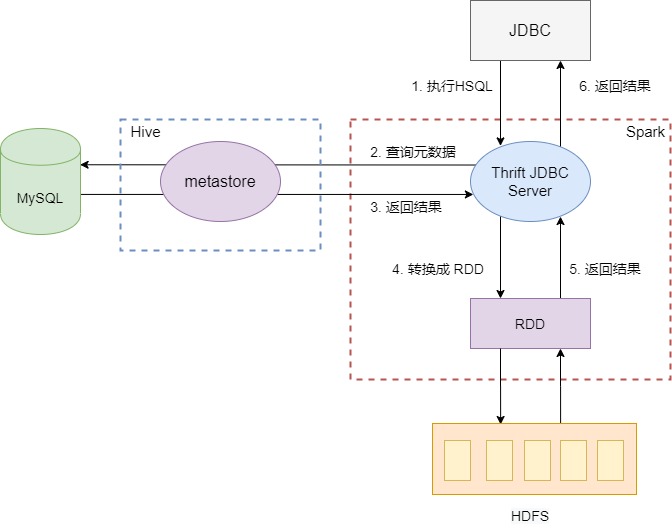
Thrift JDBC Server默认监听端口是10000,与 HiveServer2 相同
一句话理解
JAVA程序可以通过 JDBC 连接 Thrift JDBC Server,以 Spark on Hive 的方式 查询 Hive 中的表
使用 spark 执行 SQL,提高执行效率
提示:比 hive 执行 SQL快很多(底层转换成 MapReduce)
应用场景
springboot工程,通过 JDBC 调用 spark,执行 sql,显示查询结果,或者显示图表
dbeaver 通过 JDBC 调用 spark,执行 sql,方便、快速调试 SQL
部署关键
尽量使用 spark with hadoop 版本,因为用 spark without hadoop,需要复制很多jar包
不要启动 hive 的 hiveserver2 服务,Spark Thrift JDBC Server 就是替代 hiveserver2 的,所以这两个服务不能同时启动
配置
将 hive-site.xml 复制到 /program/spark-3.0.0/conf 目录下
cp /program/hive-3.1.2/conf/hive-site.xml /program/spark-3.0.0/conf/
启动
启动 hive metastore 服务
前台方式启动:
hive --service metastore
后台方式启动:
nohup hive --service metastore 2>&1 &
详见:https://www.malaoshi.top/show_1IXjyrb5E3w.html
不要启动 hiveserver2
Spark Thrift JDBC Server 服务 代替 hiveserver2,所以不要启动 hiveserver2
关闭 hiveserver2
根据 10000 端口号查找进程
netstat -nltp | grep 10000
执行结果如下:
tcp6 0 0 :::10000 :::* LISTEN 2505/java
结束进程:
kill -9 2505
启动 spark thriftserver服务
单机启动
执行下面命令(启动较慢):
/program/spark-3.0.0/sbin/start-thriftserver.sh
执行 jps 命令,查看进程,显示如下:
2598 SparkSubmit
yarn 启动
/program/spark-3.0.0/sbin/start-thriftserver.sh --master yarn
通过 http://hadoop2:8088 可查看进程
测试
通过 jdbc 可直接连接,查询速度非常快,
用 dbeaver 连接,连接方式如下:
url:jdbc //hadoop1:10000
用户名:root
密码:无
执行下面sql:
select id as a, sum(ele_num) as sum
from t_cdz
where ele_num > 100
group by id
查询速度非常快
关闭服务
/program/spark-3.0.0/sbin/stop-thriftserver.sh
参考:
https://www.jianshu.com/p/36b71cdc1453