提出缺点
ProcessWindowFunction 缺点
窗口先 缓存所有元素,等到触发时,对窗口内的所有元素执行计算,这种方式效率低。
AggregateFunction 缺点
来一条数据,就处理一条数据,效率更高,但无法 获取 window信息(窗口开始时间、结束时间),无法计算平均值、中位数
解决
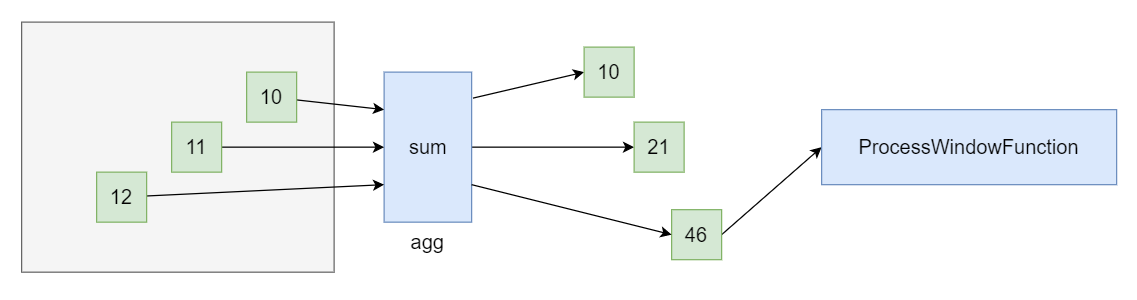
Flink 提供一个方法,可以把增量函数 AggregateFunction 和全量函数 ProcessWindowFunction 结合 使用
对于一个窗口来说,Flink 先增量计算,窗口关闭前,将增量计算结果(一般只有一个)发送给 ProcessWindowFunction 作为输入再进行处理。
案例
城市的气温数据,每隔30秒,获得该城市的这30秒内的温度最大值、最小值、平均值
准备数据
在工程目录下创建 data/qiwen.txt,内容如下:
江苏,苏州,20.5,2021-01-29 16:00:00
江苏,盐城,24.5,2021-01-29 16:00:20
江苏,盐城,28.5,2021-01-29 16:00:30
江苏,盐城,23.5,2021-01-29 16:00:40
江苏,苏州,21.5,2021-01-29 16:00:10
江苏,苏州,22.5,2021-01-29 16:00:20
江苏,苏州,24.5,2021-01-29 16:00:30
江苏,苏州,23.5,2021-01-29 16:00:40
江苏,苏州,22.5,2021-01-29 16:00:50
java
package std2;

import org.apache.flink.api.common.RuntimeExecutionMode;
import org.apache.flink.api.common.functions.AggregateFunction;
import org.apache.flink.api.common.functions.FlatMapFunction;
import org.apache.flink.api.common.serialization.SimpleStringSchema;
import org.apache.flink.streaming.api.datastream.DataStreamSource;
import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.functions.windowing.ProcessWindowFunction;
import org.apache.flink.streaming.api.windowing.assigners.TumblingProcessingTimeWindows;
import org.apache.flink.streaming.api.windowing.time.Time;
import org.apache.flink.streaming.api.windowing.windows.TimeWindow;
import org.apache.flink.streaming.connectors.kafka.FlinkKafkaConsumer;
import org.apache.flink.util.Collector;
import org.apache.kafka.clients.consumer.ConsumerConfig;

import java.util.Properties;

public class Agg_Process_Fun_kafka {

    static class TempRecord {
        private String province;
        private String city;
        private Double temp;
        private String time;

        public TempRecord(String province, String city, Double temp, String time) {
            this.province = province;
            this.city = city;
            this.temp = temp;
            this.time = time;
        }

        public String getProvince() {
            return province;
        }

        public void setProvince(String province) {
            this.province = province;
        }

        public String getCity() {
            return city;
        }

        public void setCity(String city) {
            this.city = city;
        }

        public Double getTemp() {
            return temp;
        }

        public void setTemp(Double temp) {
            this.temp = temp;
        }

        public String getTime() {
            return time;
        }

        public void setTime(String time) {
            this.time = time;
        }
    }

    static class Result {
        private String key;
        // flink运算时,要将较大的值赋给该属性,所以要初始化最小值
        private Double max = Double.MIN_VALUE;

        // flink运算时,要将较小的值赋给该属性,所以要初始化最大值
        private Double min = Double.MAX_VALUE;

        private Double sum = 0.0;

        private Double avg = 0.0;

        private Integer count = 0;

        public Result() {
        }

        @Override
        public String toString() {
            return "TempRecordAggsResult{" +
                    "key='" + key + '\'' +
                    ", max=" + max +
                    ", min=" + min +
                    ", sum=" + sum +
                    ", avg=" + avg +
                    ", count=" + count +
                    '}';
        }

        public String getKey() {
            return key;
        }

        public void setKey(String key) {
            this.key = key;
        }

        public Double getMax() {
            return max;
        }

        public void setMax(Double max) {
            this.max = max;
        }

        public Double getMin() {
            return min;
        }

        public void setMin(Double min) {
            this.min = min;
        }

        public Double getSum() {
            return sum;
        }

        public void setSum(Double sum) {
            this.sum = sum;
        }

        public Double getAvg() {
            return avg;
        }

        public void setAvg(Double avg) {
            this.avg = avg;
        }

        public Integer getCount() {
            return count;
        }

        public void setCount(Integer count) {
            this.count = count;
        }
    }

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        env.setRuntimeMode(RuntimeExecutionMode.STREAMING);
        env.setParallelism(2);

        Properties pro = new Properties();
        pro.setProperty(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG,"hadoop1:9092,hadoop2:9092,hadoop3:9092");
        pro.setProperty(ConsumerConfig.GROUP_ID_CONFIG,"consumer-group");
        pro.setProperty(ConsumerConfig.AUTO_OFFSET_RESET_CONFIG,"latest");

        // 内置连接器,创建FlinkKafka消费者,需要指定主题、反序列化、kafka配置
        FlinkKafkaConsumer<String> fkc = new FlinkKafkaConsumer<>("qiwen", new SimpleStringSchema(), pro);

        DataStreamSource<String> source = env.addSource(fkc);

        SingleOutputStreamOperator<Result> result = source
                .flatMap(new FlatMapFunction<String, TempRecord>() {
                    @Override
                    public void flatMap(String value, Collector<TempRecord> out) throws Exception {
                        String[] arr = value.split(",");
                        Double temp = 0.0;
                        if (arr[2] != null) {
                            temp = Double.parseDouble(arr[2]);
                        }
                        TempRecord tempRecord = new TempRecord(arr[0], arr[1], temp, arr[3]);
                        out.collect(tempRecord);
                    }
                })
                .keyBy(TempRecord::getCity)
                .window(TumblingProcessingTimeWindows.of(Time.seconds(5)))
                .aggregate(
                        //增量计算
                        new AggFunImpl(),
                        //全量计算
                        new ProWinFunImpl());
        result.print();

        env.execute();
    }

    static class AggFunImpl implements AggregateFunction<TempRecord, Result, Result> {
        @Override
        public Result createAccumulator() {
            return new Result();
        }

        @Override
        public Result add(TempRecord value, Result accumulator) {
            Double maxTemp = value.getTemp() > accumulator.getMax() ? value.getTemp() : accumulator.getMax();
            Double minTemp = value.getTemp() < accumulator.getMin() ? value.getTemp() : accumulator.getMin();
            accumulator.setKey(value.getProvince() + "," + value.getCity());
            accumulator.setMax(maxTemp);
            accumulator.setMin(minTemp);
            accumulator.setSum(value.getTemp() + accumulator.getSum());
            accumulator.setCount(accumulator.getCount() + 1);
            return accumulator;
        }

        @Override
        public Result getResult(Result accumulator) {
            return accumulator;
        }

        @Override
        public Result merge(Result a, Result b) {
            return null;
        }
    }

    static class ProWinFunImpl extends ProcessWindowFunction<Result, Result, String, TimeWindow> {
        @Override
        public void process(String s, ProcessWindowFunction<Result, Result, String, TimeWindow>.Context context, Iterable<Result> elements, Collector<Result> out) {
            if (elements.iterator().hasNext()) {
                Result result = elements.iterator().next();
//                                    System.out.println("result:" + result.toString());
                result.setAvg(result.getSum() / result.getCount());
                out.collect(result);
            }
        }
    }
}
启动zk
登录 hadoop1,执行下面命令:
/program/bin/zk.sh start
启动kafka
登录 hadoop1,执行下面命令:
/program/bin/kafka.sh start
启动 flink
在 idea 中运行 flink 程序
启动生产者、指定主题
登录 hadoop1,执行下面命令:
kafka-console-producer.sh --broker-list hadoop1:9092,hadoop2:9092,hadoop3:9092 --topic qiwen
然后输入:
江苏,苏州,20.5,2021-01-29 16:00:00
江苏,盐城,24.5,2021-01-29 16:00:20
江苏,盐城,28.5,2021-01-29 16:00:30
江苏,盐城,23.5,2021-01-29 16:00:40
江苏,苏州,21.5,2021-01-29 16:00:10
江苏,苏州,22.5,2021-01-29 16:00:20
江苏,苏州,24.5,2021-01-29 16:00:30
江苏,苏州,23.5,2021-01-29 16:00:40
江苏,苏州,22.5,2021-01-29 16:00:50
执行结果
在 idea 控制台中打印结果如下:
1> TempRecordAggsResult{key='江苏,苏州', max=24.5, min=20.5, sum=135.0, avg=22.5, count=6}
2> TempRecordAggsResult{key='江苏,盐城', max=28.5, min=23.5, sum=76.5, avg=25.5, count=3}