介绍
Kafka是一种 高吞吐量 的 分布式 发布订阅 消息队列系统(Message Queue)
- scala开发
- 主要应用于 大数据实时处理领域
- 最初由Linkedin公司开发,于2010年贡献给了Apache基金会并成为顶级开源项目
- 依赖 zookeeper
名字由来
kafka的架构师jay kreps 非常喜欢 franz kafka
优势:
高吞吐量、低延迟:kafka每秒可以处理几十万条消息,它的延迟最低只有几毫秒
可扩展性:kafka集群支持热扩展
持久性、可靠性:消息被持久化到本地磁盘,并且支持数据备份防止数据丢失
容错性:允许集群中节点故障(若副本数量为n,则允许n-1个节点故障)
高并发:支持数千个客户端同时读写
应用场景
日志收集:一个公司可以用Kafka可以收集各种服务的log,通过kafka以统一接口服务的方式开放给各种consumer
用户活动跟踪:kafka经常被用来记录web用户或者app用户的各种活动,如浏览网页、搜索、点击等活动,这些活动信息被各个服务器发布到kafka的topic中,然后消费者通过订阅这些topic来做实时的监控分析,亦可保存到数据库
运营指标:kafka也经常用来记录运营监控数据。包括收集各种分布式应用的数据,生产各种操作的集中反馈,比如报警和报告
流式处理:比如:flink、spark streaming
消息系统:解耦生产者和消费者、缓存消息等
术语
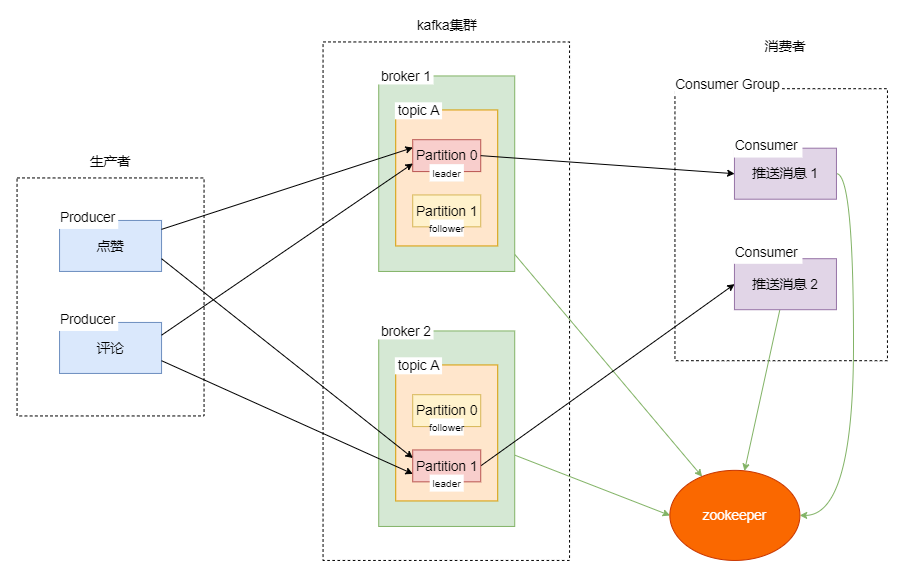
broker
节点
Kafka 集群包含一个或多个服务器,一台 kafka 服务器就是一个 broker。
一个 broker可以容纳多个 topic。
Topic
主题
发布到Kafka集群的消息都有一个 类别,这个类别被称为Topic。
例子:外卖app中,下订单是一个类别、评价是一个类别、骑手接单是一个类别,这些类别也就是topic。不同类别的消息,发送到对应的topic中。如果不同类别的消息,发送到一个topic中,就混乱了,不方便处理数据
topic可以理解为一个队列,接收到消息后放入topic中,生产者和消费者要操作的是 topic。(相当于mysql中的表,用于存储数据)
一个Topic的消息可以保存在一个或多个broker上,但用户只需指定消息的Topic即可生产或消费数据而不必关心数据存于何处)
类似于数据库的表名
Partition
分区
topic中的数据可能会非常多,分割为一个或多个partition。每个topic至少有一个partition。
集群: 如果集群有N个broker,某topic有N个partition,那么每个broker存储该topic的一个partition。
partition中的数据是有序的,不同partition间的数据丢失了数据的顺序。
扩展:
每个partition中的数据使用多个segment文件存储。
partition中的数据是有序的,不同partition间的数据丢失了数据的顺序。如果topic有多个partition,消费数据时就不能保证数据的顺序。在需要严格保证消息的消费顺序的场景下,需要将partition数目设为1。
如果某topic有N个partition,集群有(N+M)个broker,那么其中有N个broker存储该topic的一个partition,剩下的M个broker不存储该topic的partition数据。
如果某topic有N个partition,集群中broker数目少于N个,那么一个broker存储该topic的一个或多个partition。在实际生产环境中,尽量避免这种情况的发生,这种情况容易导致Kafka集群数据不均衡。
Replica
副本以分区为单位。每个分区都有各自的 主副本 和 从副本
主副本叫做Leader,从副本叫做Follower
目的:为保证集群中的某个broker发生故障时,该broker上的 partition 数据不丢失
Leader
每个partition有多个副本,其中有且仅有一个作为Leader,Leader是当前负责数据的读写的partition。
消费者和生产者都是从Leader中读写数据,不与Follower交互
Follower
Follower跟随Leader,Follower与Leader保持数据同步。
如果Leader失效,则从Follower中选举出一个新的Leader。
当Follower挂掉、卡住或者同步太慢,leader会把这个follower从“in sync replicas”(ISR)列表中删除,重新创建一个Follower。
Producer
生产者,将消息(数据)发送给Kafka。
Consumer
消费者,从broker中读取数据。
消费者可以消费多个topic中的数据。
Consumer Group
消费者组
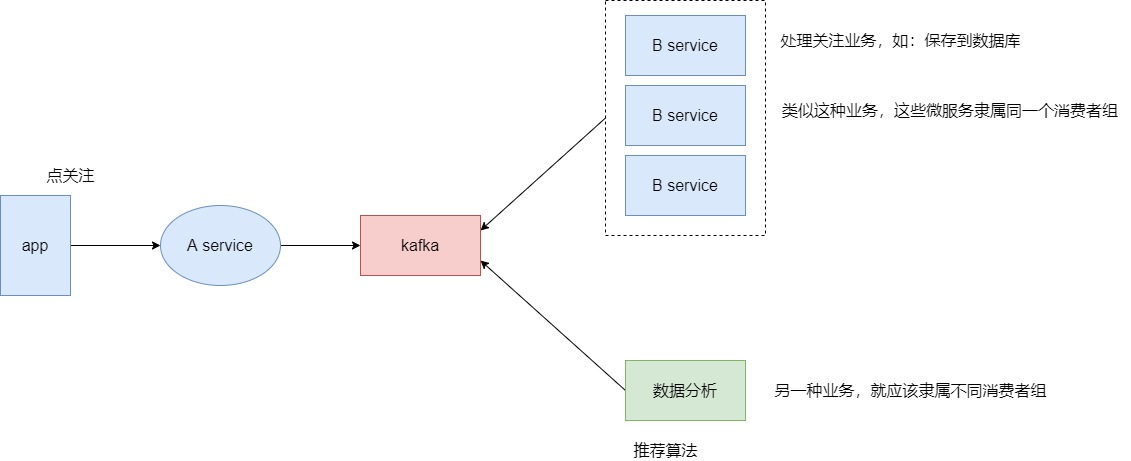
每个 消费者 属于 某一个 消费者组,消费者组是逻辑上的订阅者(相当于操作系统的用户和用户组)
可为每个Consumer指定group name,若不指定group name则属于默认的group
消费者组内,消费者是竞争关系,即:只能有一个消费者,从同一个主题中,获取到消息
消费者组内,每个消费者负责消费不同分区的数据,一个分区只能由一个组内消费者消费,消费者组之间互不影响。