topic 和 partition
Kafka 中消息是以 topic 进行分类的,生产者生产消息,消费者消费消息,都是面向 topic
的。
topic 是逻辑上的概念,而 partition 是物理上的概念。
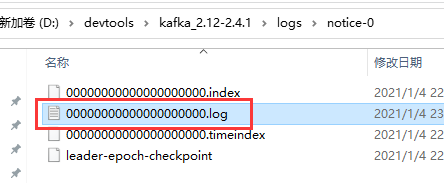
在硬盘上,以 topic名-partition序号 作为文件夹的名字
partition
每个 partition 对应于一个 log 文件,该 log 文件 中存储的就是 producer 的数据,如下图:
offset偏移量
Producer 生产的数据会被不断追加到该 log 文件 尾部,且每条数据都有自己的 offset。
每个分区有独立的偏移量,只能保证分区内有顺序
如下图:
3个分区,每个分区有独立的偏移量,每个分区的偏移量可能相同
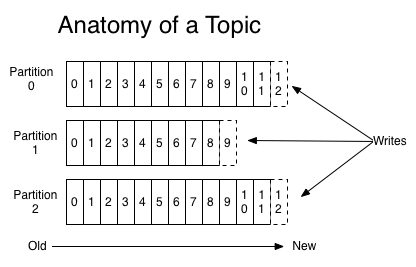
图片来源:http://kafka.apache.org/24/documentation.html
消费者 与 offset
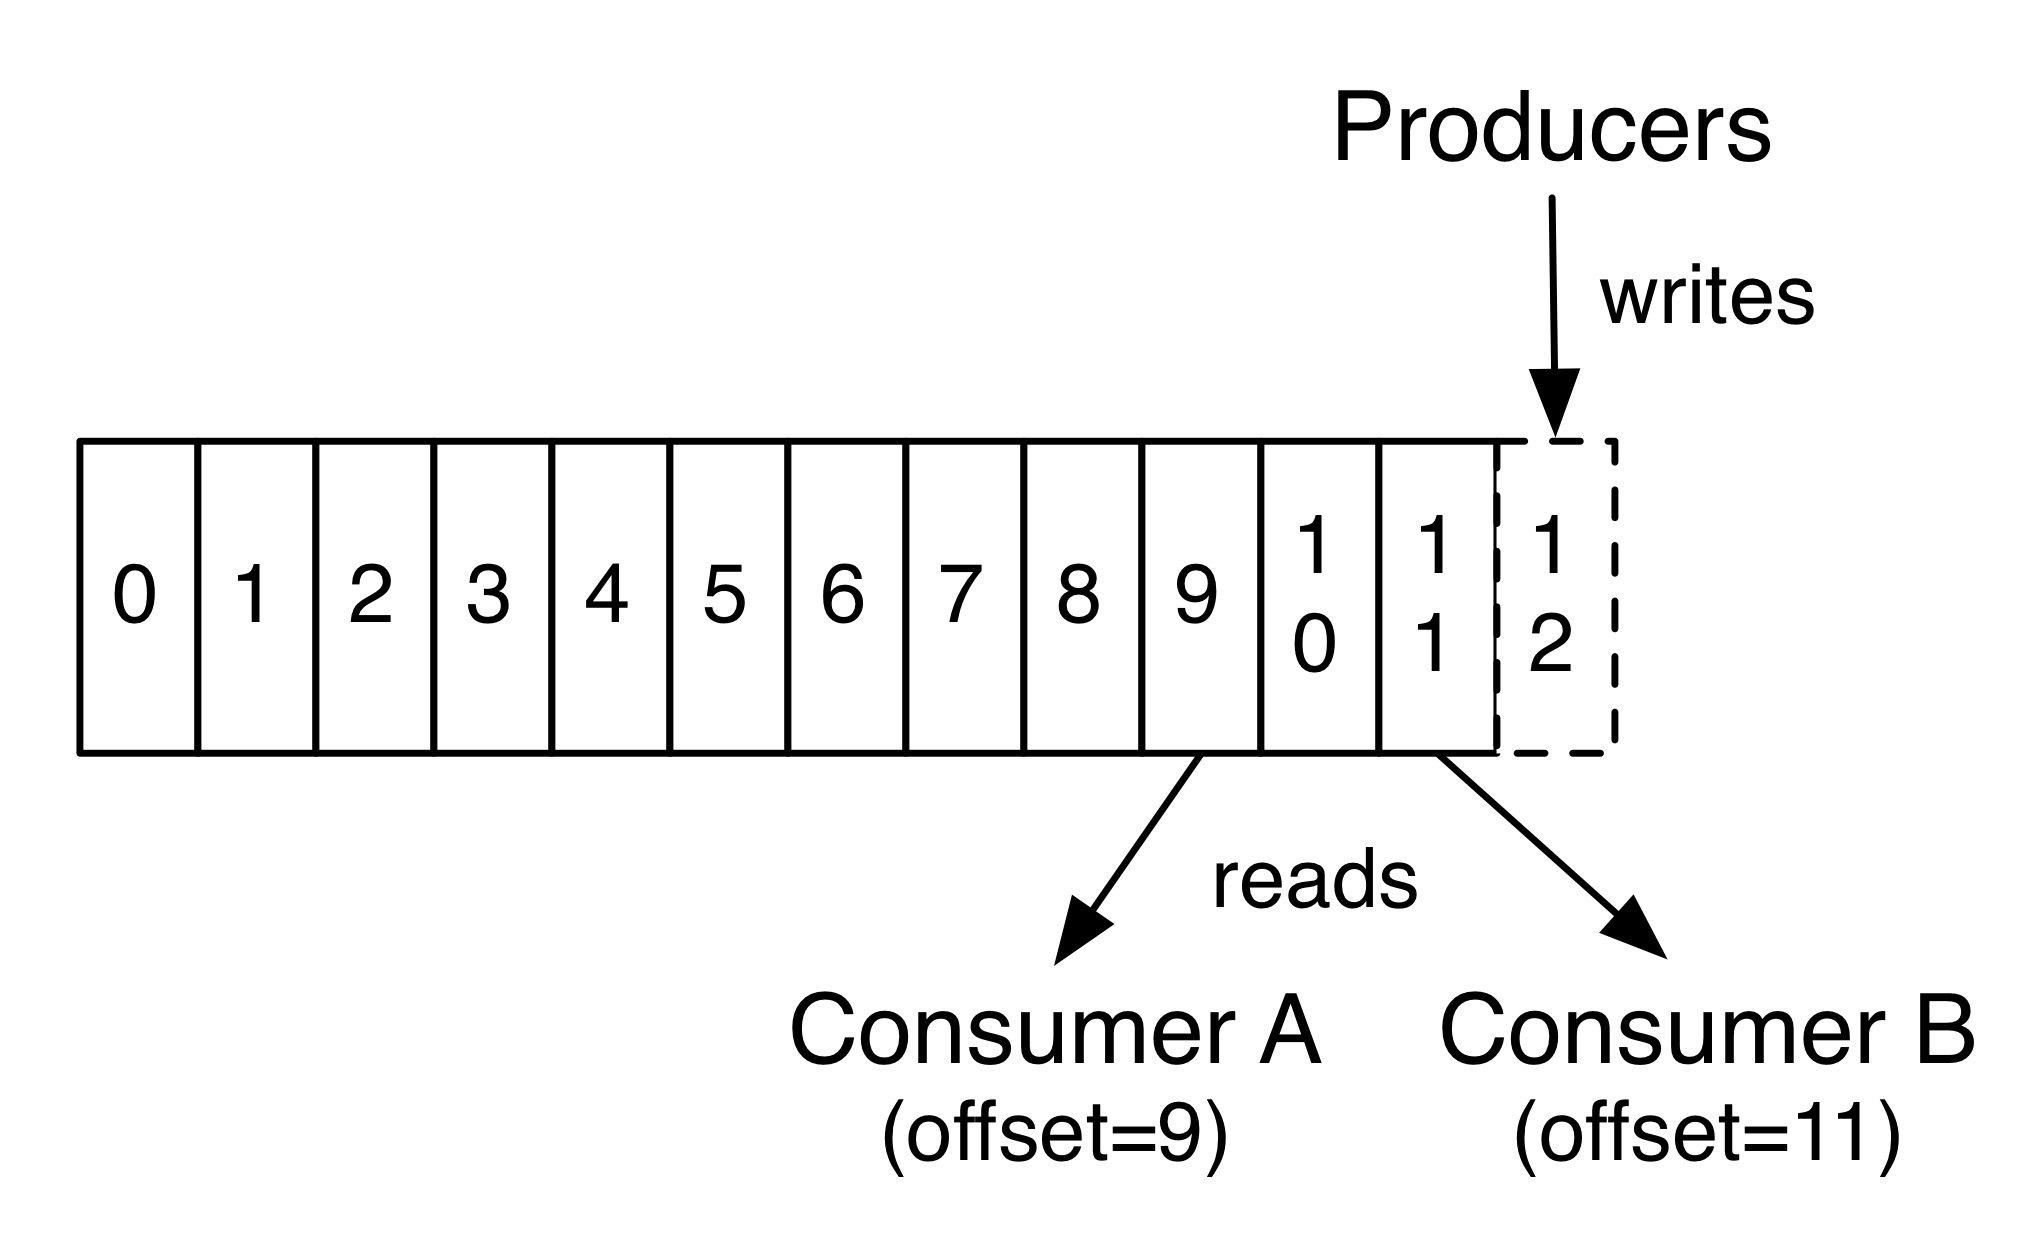
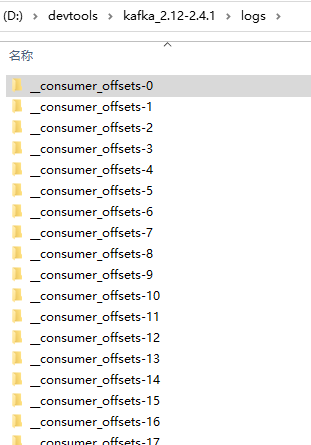
消费者组中的每个消费者,都会实时记录自己消费到了哪个 offset,以便出错恢复时,从上次的位置继续消费。
保存位置:
segment
由于生产者生产的消息会不断追加到 log 文件末尾,为防止 log 文件过大导致数据定位效率低下,Kafka 采取了分片和索引机制,将每个 partition 分为多个 segment。
每个 segment 对应两个文件:
.log文件保存的是数据.index文件保存的是索引,通过索引去.log文件找数据
这些文件保存在 topic名-partition序号 文件夹下