介绍
统计下图文件中,各个词(人名)出现的次数:

创建maven工程
略
修改pom.xml
添加依赖,由于本文使用 hadoop 3.0.3,所以依赖包版本也是 3.0.3
<properties>
    <hadoop-version>3.0.3</hadoop-version>
</properties>
<dependencies>
    <dependency>
        <groupId>org.apache.hadoop</groupId>
        <artifactId>hadoop-common</artifactId>
        <version>${hadoop-version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.hadoop</groupId>
        <artifactId>hadoop-client</artifactId>
        <version>${hadoop-version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.hadoop</groupId>
        <artifactId>hadoop-hdfs</artifactId>
        <version>${hadoop-version}</version>
    </dependency>
</dependencies>
log4j.properties
打印 hadoop debug 信息
在 resources 文件夹下创建 log4j.properties 文件,内容如下:
log4j.rootLogger=DEBUG, stdout
log4j.appender.stdout=org.apache.log4j.ConsoleAppender
log4j.appender.stdout.layout=org.apache.log4j.PatternLayout
log4j.appender.stdout.layout.ConversionPattern=%d %p [%c] - %m%n
java
mapper类
import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.LongWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Mapper;

import java.io.IOException;

/**
 * 继承自 Mapper 类
 * 泛型解释:
 * LongWritable:每一行开始位置的偏移量,对应 map() 方法第1个形成类型
 * Text:输入数据的值,通常是一行文本数据,对应 map() 方法第2个形成类型
 * Text:context写入的key的数据类型
 * IntWritable:context写入的value的数据类型
 */
public class WordcountMapper extends Mapper<LongWritable, Text, Text, IntWritable> {
    //可以复用,所以定义为成员变量,例子就是这么写的
    private Text k = new Text();
    private final static IntWritable v = new IntWritable(1);

    /**
     *
     * @param key
     * @param value MapReduce有默认的读取数据组件(TextInputFormat),一行一行的读取数据。key是每一行开始位置的偏移量,value是该行的内容
     * @param context 通过context写入数据
     * @throws IOException
     * @throws InterruptedException
     */
    @Override
    protected void map(LongWritable key, Text value, Context context)    throws IOException, InterruptedException {

        //获取一行
        String line = new String(value.toString().getBytes(),"UTF-8");

        //根据空格拆分字符串
        String[] words = line.split(" ");

        //遍历数组,输出新的key、value
        for (String word : words) {

            k.set(word);
            context.write(k, v);
        }
    }
}
reducer类
import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Reducer;

import java.io.IOException;

public class WordcountReducer extends Reducer<Text, IntWritable, Text, IntWritable> {

    IntWritable v = new IntWritable();

    /**
     * reduce默认行为:
     *    1. 根据 map输出结果的 key 进行字典排序
     *    2. 然后根据 key 进行分组
     *    3. 分组后,同一组数据组成一个新的 key/value,key还是原来的key;value是由原value组成的Iterable迭代器
     * @param key 单词
     * @param values 单词出现的次数,迭代器。如果出现2次,那么迭代器有2个1
     * @param context 通过context写入数据
     * @throws IOException
     * @throws InterruptedException
     */
    @Override
    protected void reduce(Text key, Iterable<IntWritable> values,Context context) throws IOException, InterruptedException {

        //累加求和
        int count = 0;
        for (IntWritable item : values) {
            count += item.get();
        }

        //输出
        v.set(count);
        context.write(key,v);
    }
}
主启动类-driver
import org.apache.hadoop.conf.Configuration;
import org.apache.hadoop.fs.Path;
import org.apache.hadoop.io.IntWritable;
import org.apache.hadoop.io.Text;
import org.apache.hadoop.mapreduce.Job;
import org.apache.hadoop.mapreduce.lib.input.FileInputFormat;
import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat;

import java.io.IOException;

public class Main {
    public static void main(String[] args) throws IOException, ClassNotFoundException, InterruptedException {
        // 检查命令行参数,确保提供了输入和输出路径
        if (args.length != 2 || args == null){ // 检查命令行参数是否正确(需要两个参数)
            System.err.println("please input current Path"); // 提示用户输入路径
            System.exit(1); // 参数不正确时退出程序
        }
        //创建 config 对象
        Configuration config = new Configuration();
        //构建 Job 实例,设置job名字,在yarn 8088可看到
        Job job = Job.getInstance(config,"mywordcount");

        //设置jar加载路径,不加此代码有时可能会报错
        job.setJarByClass(Main.class);

        //设置map和reduce类
        job.setMapperClass(WordcountMapper.class);
        job.setReducerClass(WordcountReducer.class);

        // 设置 Mapper 输出key-value对的数据类型,必须与 Mapper 泛型一致
        // 与 job.setOutputKeyClass()、job.setOutputValueClass() 一致时可略
        job.setMapOutputKeyClass(Text.class);
        job.setMapOutputValueClass(IntWritable.class);

        //设置最终输出 key/value 类型(关键:必须与 reducer 输出的泛型一致)
        job.setOutputKeyClass(Text.class);
        job.setOutputValueClass(IntWritable.class);

        //根据输入参数 设置输入和输出路径
        FileInputFormat.setInputPaths(job, new Path(args[0]));
        FileOutputFormat.setOutputPath(job, new Path(args[1]));

        //job.submit();//这种提交较少用,原因在下面
        //一般采用这种方式提交,等待结束,客户端可实时看到进度
        boolean result = job.waitForCompletion(true);
        System.exit(result ? 0 : 1);
    }
}
如果调用 job.submit() 提交,在 yarn 上运行时,只能看到提交信息,看不到执行进度,如下图:

本地调试
- 在开发机器上运行,如:windows
- 读取的数据 和 输出结果 在 本地 上
注意:需要搭建开发环境 hadoop3.x HDFS JAVA开发介绍
本地调试 - idea 操作
准备数据
在 D:\hadoop_std\data 目录下创建文件 1.txt,内容如下:
李雷 韩梅梅
韩梅梅 lucy
lili 李雷 李四
杜子腾 李雷 张三
李雷 lucy lili
设置启动参数
在主启动类点右键,如下操作:

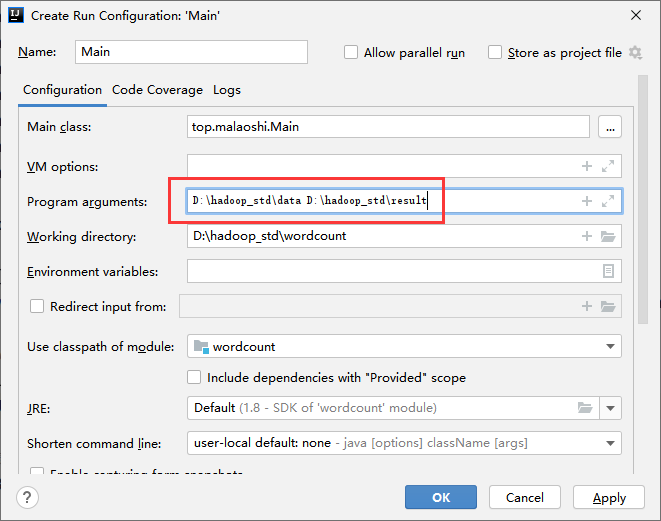
红框处是:D:\hadoop_std\data D:\hadoop_std\result
解释: 中间有空格,这是2个参数
D:\hadoop_std\data:读取数据所在的目录D:\hadoop_std\result:生成结果的目录,执行前,result目录必须删除,否则报错
运行
然后 run 或 debug 运行
执行结果

内容如下,每个词(人名)出现的次数:

本地调试 - eclipse 操作
在主启动类点右键,如下操作:
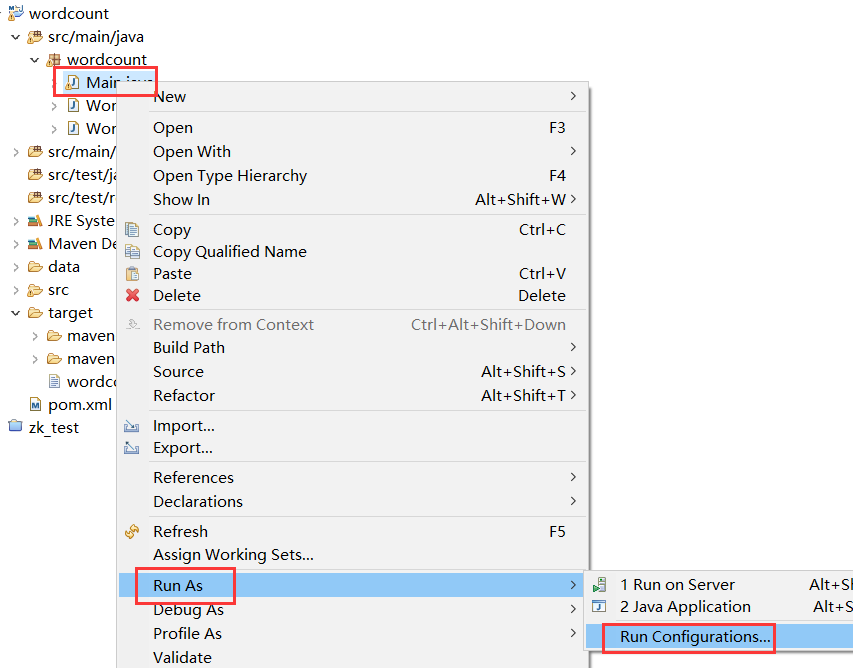
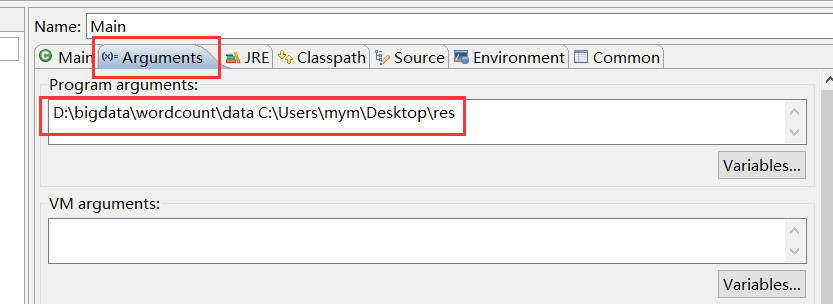
传入参数:D:\bigdata\wordcount\data C:\Users\mym\Desktop\res
解释: 中间有空格,这是2个参数
D:\bigdata\wordcount\data:读取数据所在的目录C:\Users\mym\Desktop\res:生成结果的目录,执行前,result目录必须删除,否则报错
准备数据
在 D:\bigdata\wordcount\data 目录下创建文件 1.txt,内容如下:
李雷 韩梅梅
韩梅梅 lucy
lili 李雷 李四
杜子腾 李雷 张三
李雷 lucy lili
运行
然后 run 或 debug 运行
执行时可能提示下面错误
不影响运行
NativeIO.createDirectoryWithMode error, path = \tmp\hadoop-mym\mapred\local\localRunner\mym\jobcache\job_local582540742_0001\attempt_local582540742_0001_m_000000_0\output, mode = 755
183: 当文件已存在时,无法创建该文件。

    at org.apache.hadoop.io.nativeio.NativeIO$Windows.createDirectoryWithMode0(Native Method)
    at org.apache.hadoop.io.nativeio.NativeIO$Windows.createDirectoryWithMode(NativeIO.java:521)
    at org.apache.hadoop.fs.RawLocalFileSystem.mkOneDirWithMode(RawLocalFileSystem.java:509)
    at org.apache.hadoop.fs.RawLocalFileSystem.mkdirsWithOptionalPermission(RawLocalFileSystem.java:562)
    at org.apache.hadoop.fs.RawLocalFileSystem.mkdirs(RawLocalFileSystem.java:534)
    at org.apache.hadoop.fs.RawLocalFileSystem.create(RawLocalFileSystem.java:303)
    at org.apache.hadoop.fs.RawLocalFileSystem.create(RawLocalFileSystem.java:292)
    at org.apache.hadoop.fs.FileSystem.create(FileSystem.java:1083)
    at org.apache.hadoop.fs.FileSystem.create(FileSystem.java:972)
    at org.apache.hadoop.fs.FileSystem.create(FileSystem.java:960)
    at org.apache.hadoop.mapred.MapTask$MapOutputBuffer.sortAndSpill(MapTask.java:1617)
    at org.apache.hadoop.mapred.MapTask$MapOutputBuffer.flush(MapTask.java:1505)
    at org.apache.hadoop.mapred.MapTask$NewOutputCollector.close(MapTask.java:735)
    at org.apache.hadoop.mapred.MapTask.runNewMapper(MapTask.java:805)
    at org.apache.hadoop.mapred.MapTask.run(MapTask.java:347)
    at org.apache.hadoop.mapred.LocalJobRunner$Job$MapTaskRunnable.run(LocalJobRunner.java:271)
    at java.util.concurrent.Executors$RunnableAdapter.call(Executors.java:511)
    at java.util.concurrent.FutureTask.run(FutureTask.java:266)
    at java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:1149)
    at java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:624)
    at java.lang.Thread.run(Thread.java:748)