介绍
MapReduce是 软件框架,方便编写应用程序,能够运行在由 上千台 服务器组成的大型集群上,以 可靠容错 的方式 并行 处理 TB级 的数据
将一个大任务,拆分成多个小任务,并行运算(相当于修铁路,工人越多,修铁路越快)
MapReduce 和 HDFS
MapReduce 和 HDFS 是运行在 相同节点 上的,即:计算节点和存储节点通常在一起。
MapReduce 在 已经存好数据的节点上高效地调度任务,可以使整个集群的网络带宽非常高效地使用
优点
易于编程。
简单的实现一些接口,就可以完成一个分布式程序,这个分布式程序可以分布到大量廉价的PC机器上运行。也就是说你写一个分布式程序,跟写一个简单的串行程序是一模一样的。支持扩展。
增加机器扩展计算能力。计算资源不能得到满足的时候,可以通过 简单的增加机器 来扩展它的计算能力高容错性
MapReduce设计的初衷就是使程序能够部署在廉价的PC机器上,这就要求它具有很高的容错性。比如 其中一台机器挂了,它可以把上面的计算任务转移到另外一个节点上运行,不至于这个任务运行失败,而且这个过程不需要人工参与,而完全是由Hadoop内部完成的支持 TB 以上的海量数据,可以实现上千台服务器集群并发工作
缺点
不支持实时计算。不像MySQL、oracle,在 毫秒 或者 秒级 内返回结果
不擅长流式计算。流式计算的输入数据是动态的,而MapReduce的 输入数据集是静态的,不能动态变化。
不擅长复杂计算。mapreduce只支持 一个map阶段、一个reduce阶段,前一个的输出,是后一个应用程序的输入。
也可以做复杂运算,但每个MapReduce阶段的输出结果都会写入到磁盘,会造成大量的磁盘IO,导致性能非常的低下
Map 和 Reduce
Map和 Reduce,是主要编程思想,出自函数式编程语言,详见:hadoop:map、reduce 运算简单图解
MapReduce 程序 一般分成 2个阶段:
map阶段的并发
map task,完全并发运行,互不相干reduce阶段的并发
reduce task,依赖上一个map task的运行结果
执行流程
统计一个大文件(260m),每个单词出现的次数
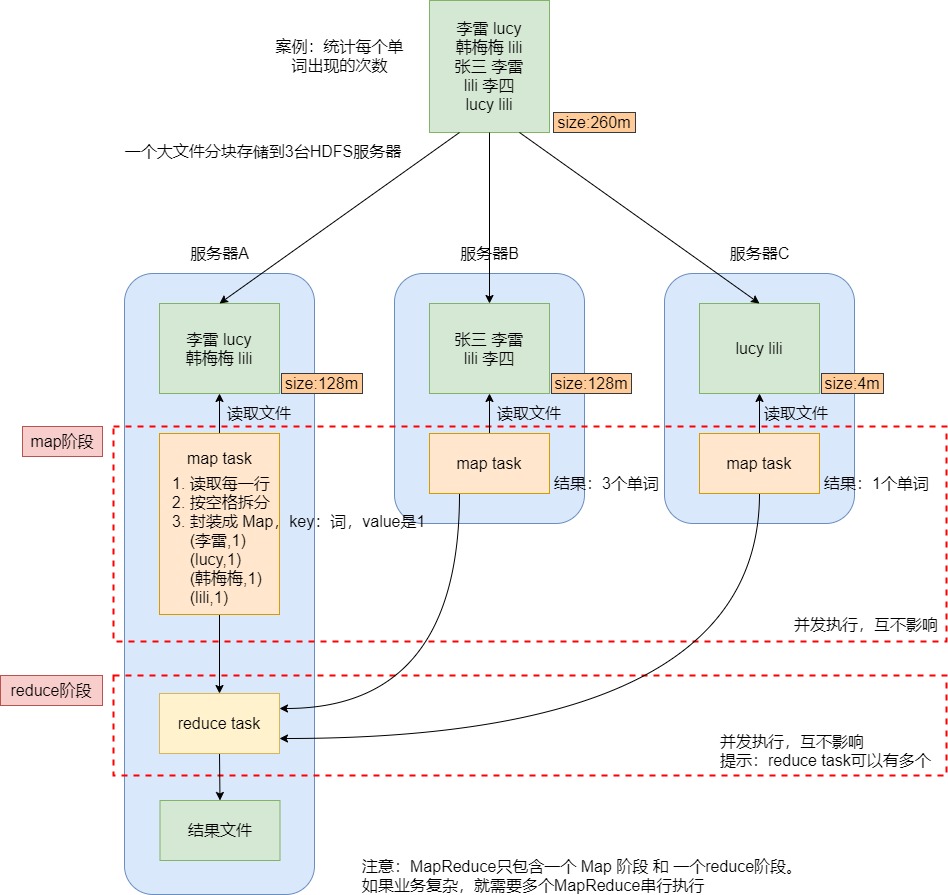
说明:
- 该文件分为 3 份,分别存在
3台 HDFS 服务器上 - 每台服务器运行
Map Task,统计所在服务器文件的单词数量。完全并行运行,互不影响 Map Task将结果,发送给Reduce Task,Reduce Task统计结果。如果有多个Reduce Task,那么完全并行运行,互不影响Reduce Task将结果写入到文件中
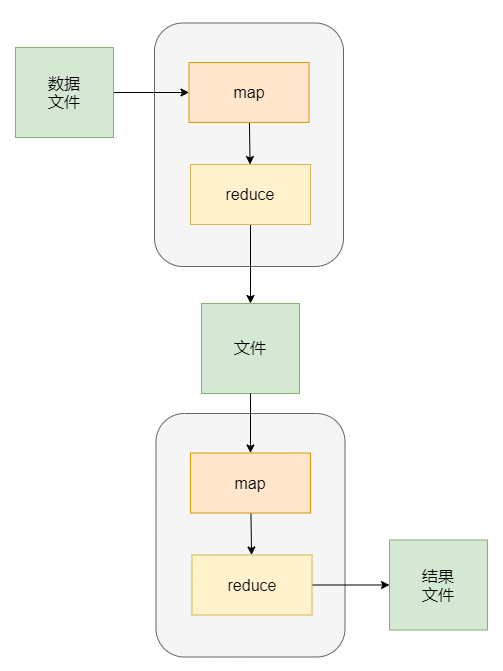
注意: MapReduce只能有一个 Map 和一个Reduce,如果业务逻辑非常复杂,就需要多个MapReduce程序,串行运行。
不推荐执行复杂业务
MapReduce 只能包含 一个map阶段 和 一个reduce阶段。如果业务复杂,需要串行执行多个 MapReduce程序,每个MapReduce作业的 输出结果 都会 写入到磁盘,会造成大量的磁盘IO,导致性能非常的低下。
运行时三类进程
MapReduce程序在分布式运行时有三类实例进程:
- MrAppMaster:负责整个程序的过程调度及状态协调
- MapTask:负责 map阶段 的整个数据处理流程。
- ReduceTask:负责 reduce阶段 的整个数据处理流程。
依赖服务
需要启动 hdfs 和 yarn 服务,将 程序 提交到 yarn,才能运行