介绍
snowflake是Twitter开源的分布式ID生成算法,结果是一个long型的ID
Twitter Snowflake 由scala开发,本文是Java实现
Twitter Snowflake:
原项目已经废弃,正在开发新版本
废弃说明:https://github.com/twitter/snowflake
原项目地址:https://github.com/twitter-archive/snowflake/tree/snowflake-2010
核心思想
使用41bit作为毫秒数,10bit作为机器的ID(5个bit是数据中心,5个bit的机器ID),12bit作为毫秒内的流水号(意味着每个节点在每毫秒可以产生 4096 个 ID),最后还有一个符号位,永远是0。
mysql
是64位二进制位的大整数。 mysql用bigint类型存储。 bigint类型有64位,取值范围-2的63次方到正2的63次方减1。
SnowFlake的结构
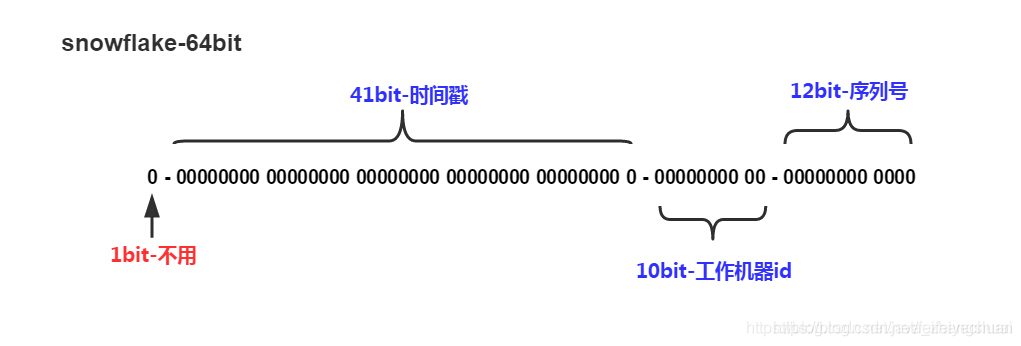
1位标识,由于long基本类型在Java中是带符号的,最高位是符号位,正数是0,负数是1,所以id一般是正数,最高位是0
41位时间截(毫秒级),注意,41位时间截不是存储当前时间的时间截,而是存储时间截的差值(当前时间截 - 开始时间截)得到的值)
这里的的开始时间截,一般是我们的id生成器开始使用的时间,由我们程序来指定的(如下下面程序IdWorker类的startTime属性)。41位的时间截,可以使用69年,年T = (1L << 41) / (1000L * 60 * 60 * 24 * 365) = 6910位的数据机器位,可以部署在1024个节点,包括5位datacenterId 和 5位workerId
12位序列,毫秒内的计数,12位的计数顺序号支持每个节点每毫秒(同一机器,同一时间截)产生4096个ID序号
加起来刚好64位,为一个Long型。
优点
整体上按照 时间自增排序
整个 分布式系统 内 不会产生ID碰撞 (由数据中心ID和机器ID作区分)
效率较高,经测试,SnowFlake每秒能够产生26万ID左右
参考:
https://blog.csdn.net/u014186972/article/details/97799211
https://www.cnblogs.com/relucent/p/4955340.html
https://blog.csdn.net/feifeiyechuan/article/details/108236261