百度百科
Apache Spark 是专为 大规模数据处理 而设计的快速通用的 计算引擎。
Spark是UC Berkeley AMP lab (加州大学伯克利分校的AMP实验室)所开源的 类Hadoop MapReduce的通用并行框架
Spark,拥有Hadoop MapReduce所具有的优点
不同于MapReduce的是:Job中间输出结果可以 保存在内存中,从而 不再需要读写HDFS,因此Spark能更好地适用于 数据挖掘 与 机器学习 等需要迭代的MapReduce的算法。
一句话理解
spark 替代 mapreduce (但不是完全替代)
官网首页
特点
摘自 官网首页
速度快。比 hadoop 快100倍。
使用方便。使用Java,Scala,Python,R和SQL快速编写应用程序。
使用SQL进行分析
多种方式部署运行。yarn、k8s、 standalone(独立集群)
核心模块
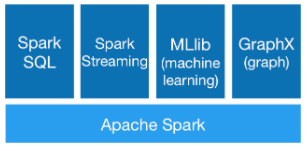
Spark Core
Spark Core 中提供了 Spark 最基础与最核心的功能,Spark 其他的功能如:Spark SQL,Spark Streaming,GraphX, MLlib 都是在 Spark Core 的基础上进行扩展的Spark SQL
Spark SQL 是 Spark 用来操作结构化数据的组件。通过 Spark SQL,用户可以使用 SQL 或者 Apache Hive 版本的 SQL 方言(HQL)来查询数据。Spark Streaming
Spark Streaming 是 Spark 平台上针对实时数据进行流式计算的组件,提供了丰富的处理数据流的 API。Spark MLlib
MLlib 是 Spark 提供的一个机器学习算法库。MLlib 不仅提供了模型评估、数据导入等额外的功能,还提供了一些更底层的机器学习原语。Spark GraphX
GraphX 是 Spark 面向图计算提供的框架与算法库。
历史
- 2009 年,Spark 诞生于伯克利大学的 AMPLab 实验室
- 2010 年,伯克利大学正式开源了 Spark 项目
- 2013 年 6 月,Spark 成为了 Apache 基金会下的项目
- 2014 年 2 月,Spark 以飞快的速度成为了 Apache 的顶级项目
- 2015 年至今,Spark 变得愈发火爆,大量的国内公司开始重点部署或者使用 Spark
Spark VS MapReduce
本质区别是 多个作业之间的 数据通信 :
- Spark 多个作业之间数据通信是基于内存
- MapReduce 是基于 HDFS(磁盘)
多线程 和 多进程
spark采用多线程方式,启动快
mapreduce采用多进程方式,启动慢
多线程是优点,同时也是缺点:多线程会出现资源争用,难以细粒度控制每个任务占用资源
spark提供多种算法库
提供 机器学习、图计算等算法库,方便使用
不完全替代 MapReduce
Spark 是基于内存的,有些计算可能需要大量占用内存,会由于内存不够导致 Job 执行失败
此时,使用 MapReduce 是更好的选择
所以 Spark 并不能完全替代 MR