说明
详细参见:https://www.runoob.com/python/python-strings.html
查找
string.find(str, beg=0, end=len(string))
参数:
- str — 指定检索的字符串
- beg — 开始索引,默认为0。
- end — 结束索引,默认为字符串的长度。
返回值:
如果包含子字符串返回开始的索引值,否则返回-1。
例子
找到这句话的书名:李雷喜欢《水浒传》里面的武松
text='李雷喜欢《水浒传》里面的武松'
startPos=text.find("《")
endPos=text.find("》")

print(text[startPos+1:endPos])
替换
string.replace(str1, str2, num=string.count(str1))
参数:
- old — 将被替换的子字符串。
- new — 新字符串,用于替换old子字符串。
- max — 可选字符串, 替换不超过 max 次
返回值
返回字符串中的 old(旧字符串) 替换成 new(新字符串)后生成的新字符串,如果指定第三个参数max,则替换不超过 max 次。
例子
在 文本编辑器中,几乎都有替换的功能,python实现如下:
text="李雷喜欢干游戏、干饭"

text=text.replace("李雷","韩梅梅")

print(text)
拆分
string.split(str="", num=string.count(str))
参数
- str — 分隔符,默认为所有的空字符,包括空格、换行(\n)、制表符(\t)等。
- num — 分割次数。默认为 -1, 即分隔所有。
返回值
返回分割后的字符串列表。
例子
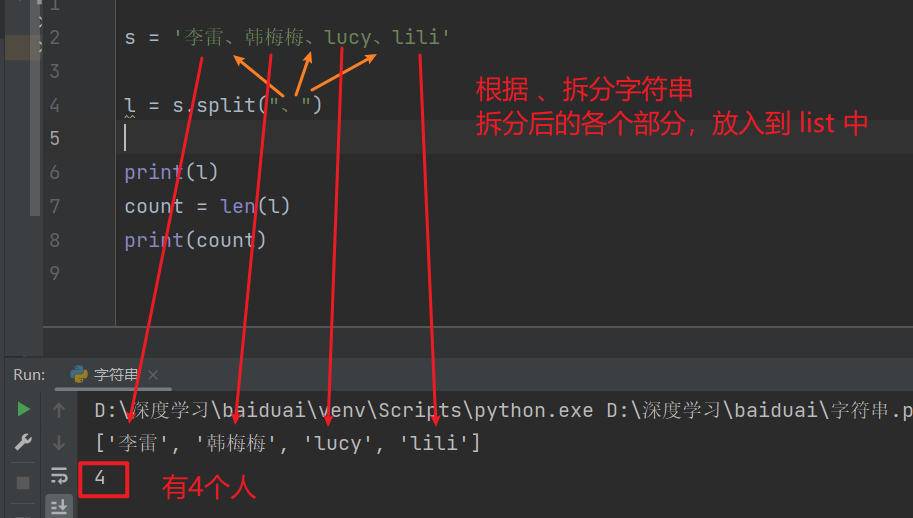
有下面字符串:
'李雷、韩梅梅、lucy、lili'
实现下面功能:
- 分别打印出人名
- 通过编程算出有几个人?
分析:人名是根据 、 间隔的,可以使用 split() 方法拆分字符串
s = '李雷、韩梅梅、lucy、lili'

l = s.split("、")

for item in l:
    print(item)

print(l)
count = len(l)
print(count)
移除字符串前后的空格、tab符号
string.strip([obj])
参数
- chars — 移除字符串头尾指定的字符序列。
返回值
返回移除字符串头尾指定的字符生成的新字符串。
例子
print(" abc ".strip())
不足位数前面填充0
string.zfill(width)
参数
- width — 指定字符串的长度。原字符串右对齐,前面填充0。
返回值
返回指定长度的字符串。
例子
生成流水号、显示金额时,不足位数,前面要补0
for num in range(15):
    print(str(num).zfill(2))
判断以某字符串开头
str.startswith(str, beg=0,end=len(string));
参数:
- str — 检测的字符串。
- strbeg — 可选参数用于设置字符串检测的起始位置。
- strend — 可选参数用于设置字符串检测的结束位置。
返回值:
- 如果检测到字符串则返回True,否则返回False。
例子
判断是否姓李
name="李雷"
print(name.startswith("李"))
判断以某字符串结尾
string.endswith(obj, beg=0, end=len(string))
参数
- suffix — 该参数可以是一个字符串或者是一个元素。
- start — 字符串中的开始位置。
- end — 字符中结束位置。
返回值
如果字符串含有指定的后缀返回True,否则返回False。
例子
判断文件名后缀
name="1.jpg"
print(name.endswith(".jpg"))