概述
numpy的索引和切片,与list相似,但功能更为强大
索引
支持数组的索引方式 arr[i][j]
例子
import numpy as np

arr=np.arange(0,10)
arr2=arr[2]
print('arr:',arr)
print('arr2:',arr2)
一维数组 切片
使用方式同list 切片
语法
ndarray[start:stop:step]
参数说明:
- start:开始的索引位置,包含
- stop:结束的索引位置,不包含
- step:步长,默认为1,当为负数时表示 翻转
返回:
- ndarray
范围
import numpy as np

arr=np.arange(0,10)
arr2=arr[2:]
print('arr:',arr)
print('arr2',arr2)
翻转
step 当为负数时表示 翻转
import numpy as np

arr=np.arange(0,10)
arr2=arr[::-1]
print('arr:',arr)
print('arr2',arr2)
翻转截取
import numpy as np

arr=np.arange(0,10)
arr2=arr[8:4:-1]
print('arr:',arr)
print('arr2',arr2)
执行结果:
arr: [0 1 2 3 4 5 6 7 8 9]
arr2 [8 7 6 5]
理解方法:
- 先翻转,
array([9, 8, 7, 6, 5, 4, 3, 2, 1, 0]) - start 从后往前数,
arr[8::-1]执行结果:array([8, 7, 6, 5, 4, 3, 2, 1, 0]) - stop 从后往前数,
arr2=arr[8 : 4 : -1]执行结果:array([8, 7, 6, 5])
二(多)维数组 切片
格式:
ndarray[row_start:row_stop,column_start:column_stop]
参数说明:
- row_start:行 开始的索引位置,包含,不写表示第一行
- row_stop:行 结束的索引位置,不包含,不写表示最后一行
- column_start:列 开始的索引位置,包含,不写表示第一行
- column_stop:列 结束的索引位置,不包含,不写表示最后一行
返回:
- ndarray
例子
下面的例子都以该数组为例:
import numpy as np

np.random.seed(9)
arr=np.random.randint(0,10,(4,5))
print(arr)
执行结果如下:
 [[5 6 8 6 1]
 [6 4 8 1 8]
 [5 1 0 8 8]
 [8 2 6 8 1]]
1. 获取连续行
import numpy as np

np.random.seed(9)
arr=np.random.randint(0,10,(4,5))
# 取第1行到第2行的所有数据
arr2=arr[1:3]
print('arr:\n',arr)
print('arr2:\n',arr2)
执行结果:
arr:
 [[5 6 8 6 1]
 [6 4 8 1 8]
 [5 1 0 8 8]
 [8 2 6 8 1]]
arr2:
 [[6 4 8 1 8]
 [5 1 0 8 8]]
3. 获取所有行、某一列,生成新的一维数组
import numpy as np

np.random.seed(9)
arr=np.random.randint(0,10,(4,5))
print('arr:\n',arr)
# 将所有行中,列索引是2的元素取出,组成一维数组
arr2=arr[:,2]
print('arr2:\n',arr2)
执行结果:
arr:
 [[5 6 8 6 1]
 [6 4 8 1 8]
 [5 1 0 8 8]
 [8 2 6 8 1]]
arr2:
 [8 8 0 6]
将所有行中,列索引是2的元素取出,生成新的 一维数组
4. 获取所有行、连续列,生成新的二维数组
import numpy as np

np.random.seed(9)
arr=np.random.randint(0,10,(4,5))
print('arr:\n',arr)
# 获取所有行中,列索引1-4的元素,生成新的二维数组
arr2=arr[:,1:4]
print('arr2:\n',arr2)
执行结果:
arr:
 [[5 6 8 6 1]
 [6 4 8 1 8]
 [5 1 0 8 8]
 [8 2 6 8 1]]
arr2:
 [[6 8 6]
 [4 8 1]
 [1 0 8]
 [2 6 8]]
获取所有行中,列索引1-4的元素,生成新的 二维数组
6. 通过行索引、列索引,生成新的一维数组
import numpy as np

np.random.seed(9)
arr=np.random.randint(0,10,(4,5))
# 取行索引是1到3,列索引是1的数据,并组合成新数组,新数组是一维数组
arr2=arr[1:3,1]
print('arr:\n',arr)
print('arr2:\n',arr2)
执行结果:
arr:
 [[5 6 8 6 1]
 [6 4 8 1 8]
 [5 1 0 8 8]
 [8 2 6 8 1]]
arr2:
 [4 1]
取行索引是1到2,列索引是1的数据,并组合成新数组,新数组是一维数组
7. 通过行索引、列索引,生成新的二维数组
import numpy as np

np.random.seed(9)
arr=np.random.randint(0,10,(4,5))
# 取行索引是1到3,列索引是1到2的数据,并组合成新数组,新数组是二维数组
arr2=arr[1:3,1:2]
print('arr:\n',arr)
print('arr2:\n',arr2)
执行结果:
arr:
 [[5 6 8 6 1]
 [6 4 8 1 8]
 [5 1 0 8 8]
 [8 2 6 8 1]]
arr2:
 [[4]
 [1]]
取行索引是1到2,列索引是1到2的数据,并组合成新数组,新数组是二维数组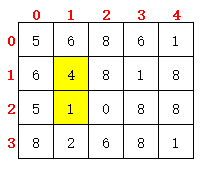
8. 通过行索引、列索引,生成新的二维数组
import numpy as np

np.random.seed(9)
arr=np.random.randint(0,10,(4,5))
# 取行索引是1到3,列索引是1到4的数据,并组合成新数组,新数组是二维数组
arr2=arr[1:3,1:4]
print('arr:\n',arr)
print('arr2:\n',arr2)
执行结果:
arr:
 [[5 6 8 6 1]
 [6 4 8 1 8]
 [5 1 0 8 8]
 [8 2 6 8 1]]
arr2:
 [[4 8 1]
 [1 0 8]]
取行索引是1到3,列索引是1到4的数据,并组合成新数组,新数组是二维数组
如下图:
问题

索引出上图数字,如下:
[[6 8 8]
 [8 6 1]]
写出返回该数组的代码
答案:
# 先不要看
# 先不要看
# 先不要看
arr[[1,3]][:,[0,2,4]]
二维数组其他索引方式
2. 获取指定的行
import numpy as np

np.random.seed(9)
arr=np.random.randint(0,10,(4,5))
print('arr:\n',arr)
arr2=arr[[3,1,2]]
print('arr2:\n',arr2)
执行结果:
arr:
 [[5 6 8 6 1]
 [6 4 8 1 8]
 [5 1 0 8 8]
 [8 2 6 8 1]]
arr2:
 [[8 2 6 8 1]
 [6 4 8 1 8]
 [5 1 0 8 8]]
将第3行、第1行、第2行组成新的二维数组
5. 获取所有行、指定列,生成新的二维数组
import numpy as np

np.random.seed(9)
arr=np.random.randint(0,10,(4,5))
print('arr:\n',arr)
# 获取所有行中,列索引是3、1、2的元素,生成新的二维数组
arr2=arr[:,[3,1,2]]
print('arr2:\n',arr2)
执行结果:
arr:
 [[5 6 8 6 1]
 [6 4 8 1 8]
 [5 1 0 8 8]
 [8 2 6 8 1]]
arr2:
 [[6 6 8]
 [1 4 8]
 [8 1 0]
 [8 2 6]]
获取所有行中,列索引是3、1、2的元素,生成新的二维数组
获取多个不相邻的点
import numpy as np

np.random.seed(9)
arr=np.random.randint(0,10,(4,5))
print('arr:\n',arr)
# 取行列索引是(1,3)、(3,2)、(2,4)的点
arr2=arr[[1,3,2],[3,2,4]]
print('arr2:\n',arr2)
执行结果:
arr:
 [[5 6 8 6 1]
 [6 4 8 1 8]
 [5 1 0 8 8]
 [8 2 6 8 1]]
arr2:
 [1 6 8]
如下图:
取行列索引是(1,3)、(3,2)、(2,4)的点
问题
索引出上图数字,如下:
[[6 8 8]
 [8 6 1]]
写出返回该数组的代码
答案:
# 先不要看
# 先不要看
# 先不要看
arr[ [ [1,1,1],[  3,3,3   ] ]  , [ [0,2,4] ,  [0,2,4]  ] ]
…符号
应用场景:一般应用在,从高维数组中,取第n维的某列数据
例子1
在形状是(3,2,2,3)的数组中,取最后1个维度的第2列数据
a = np.arange(36).reshape(3,2,2,3)
print(a)

print("----------")
# 取数组最后一个维度的第2列数据
d = a[:,:,:,1]
print(d.shape)
print(d)
执行结果:
[[[[ 0  1  2]
   [ 3  4  5]]

  [[ 6  7  8]
   [ 9 10 11]]]


 [[[12 13 14]
   [15 16 17]]

  [[18 19 20]
   [21 22 23]]]


 [[[24 25 26]
   [27 28 29]]

  [[30 31 32]
   [33 34 35]]]]

----------

(3, 2, 2)
[[[ 1  4]
  [ 7 10]]

 [[13 16]
  [19 22]]

 [[25 28]
  [31 34]]]
为了避免 a[:,:,:,1]这样出现过多冒号的情况,就可以使用...符号
d = a[...,1]
print(d.shape)
print(d)
例子2
在形状是(2,13,13,3)的数组中,取最后1个维度的第1和2列数据
a = np.arange(1014).reshape(2,13,13,3)
print(a)

# 取数组最后一个维度的第2列数据
d = a[...,1:3]
print(d.shape)
print(d)