说明
有时,在 做全文检索时,需要对 es 的评分进行二次评分
应用场景
如:对标题进行查询时,除了本身的得分,对于平台来说,还有个性化需求:文章点赞数量越多,得分就越高,类似抖音平台,点赞量越高,就越给流量。类似百度,竞价越高,排名越靠前。对于 ES 来说,就是 二次评分
原分值:
GET /toutiao_v1/_search
{
  "query": {
    "match": {
      "title": "java"
    }
  },
  "_source": [
    "title",
    "like"
  ]
}
function_score()
可进行二次评分
- field_value_factor : 将某个字段的值乘上 score
field_value_factor
例子
计算方式:new_score=old_score * 字段值
GET /toutiao_v1/_search
{
  "query": {
    "function_score": {
      "query": {
        "match": {
          "title": "java"
        }
      },
      "field_value_factor": {
        "field": "like"        //评分 乘以 like字段的值
      }
    }
  },
  "_source": [
    "title",
    "like"
  ]
}
执行结果:
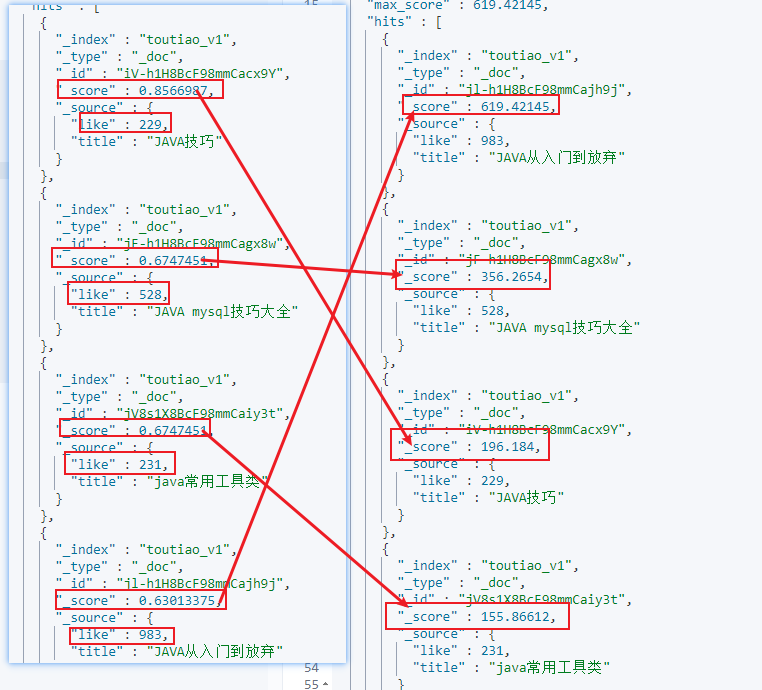
缺点
如果 like 特别大,那么分值就特别大,反之亦然。like 的大小,完全影响 分值,match 匹配查询的影响过低。
这是不合理的,因为,完全受 like 点赞量影响,查询条件影响过低,导致查询结果并不是用户想要的内容
解决方式:log1p
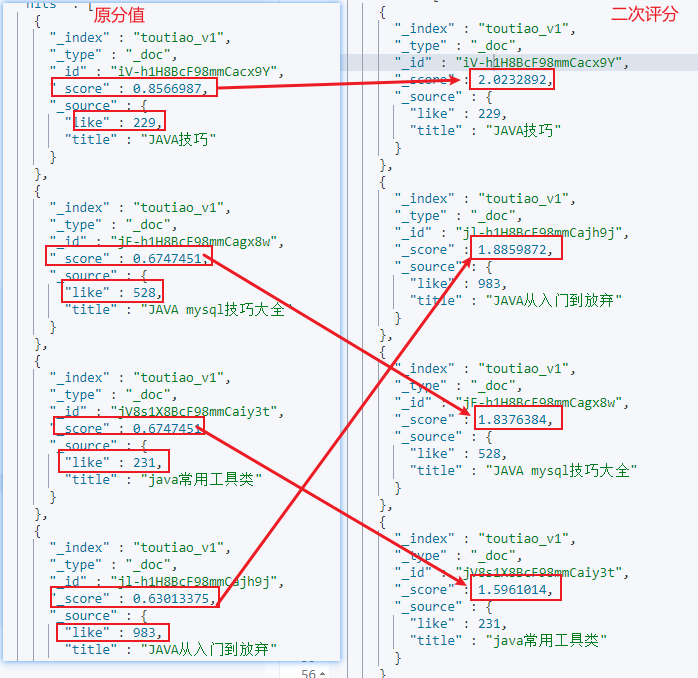
为了解决 分值过大、过小,使用 log1p,即:new_score=old_score * log(1 + 字段值)
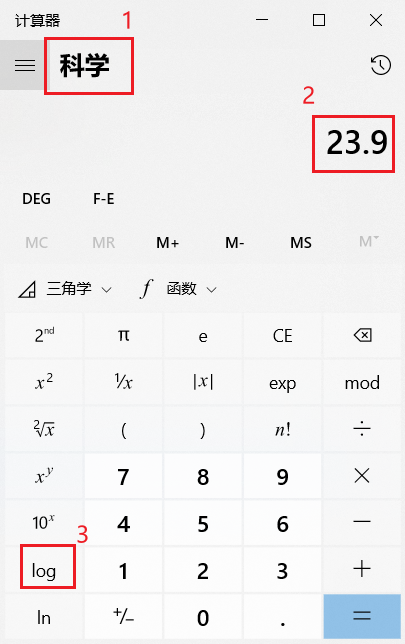
注意: 以 10 为底
这样不会过大过小
GET /toutiao_v1/_search
{
  "query": {
    "function_score": {
      "query": {
        "match": {
          "title": "java"
        }
      },
      "field_value_factor": {
        "field": "like",
        "modifier": "log1p"
      }
    }
  }
}
执行结果:
like 会影响二次评分,但不会起决定性的作用
解决方式:factor
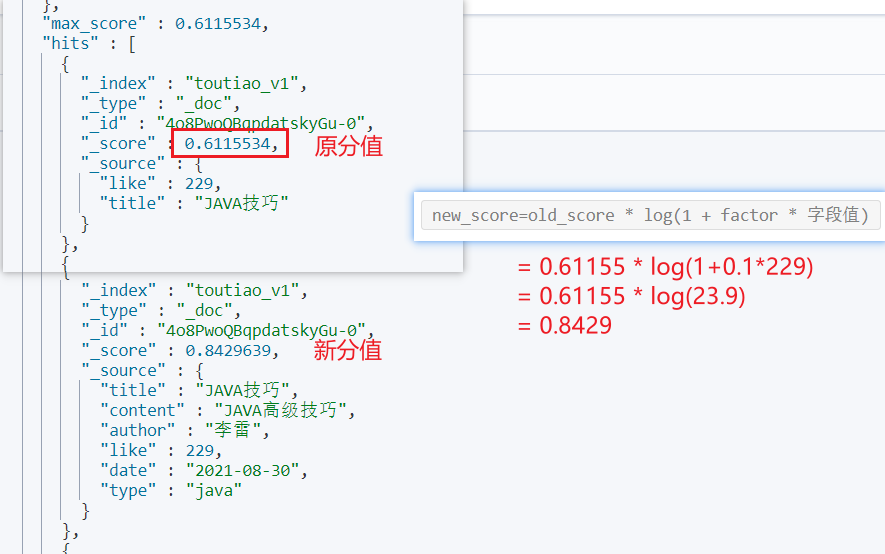
设置 字段值的权重,即:new_score=old_score * log(1 + factor * 字段值)
GET /toutiao_v1/_search
{
  "query": {
    "function_score": {
      "query": {
        "match": {
          "title": "java"
        }
      },
      "field_value_factor": {
        "field": "like",
        "modifier": "log1p",
        "factor": 0.1
      }
    }
  }
}
boost_mode
boost_mode : 决定 old_score 和 加强 score 如何合并
multiply(默认) : new_score = old_score * 加强score
sum : new_score = old_score + 加强score
min : old_score 和 加强score 取较小值,new_score = min(old_score, 加强score)
max : old_score 和 加强score 取较大值,new_score = max(old_score, 加强score)
replace : 加强score直接替换掉old_score,new_score = 加强score
GET /toutiao_v1/_search
{
  "query": {
    "function_score": {
      "query": {
        "match": {
          "title": "java"
        }
      },
      "field_value_factor": {
        "field": "like"
      },
      "boost_mode": "sum" // newScore=like+old_score
    }
  }
}
max_boost
限制加强函数的最大效果,就是 限制加强score最大能多少,但要注意不会限制old_score
如果加强score超过了max_boost限制的值,会把加强score的值设成max_boost的值
假设加强score是5,而max_boost是2,因为加强score超出了max_boost的限制,所以max_boost就会把加强score改为2
GET /toutiao_v1/_search
{
  "query": {
    "function_score": {
      "query": {
        "match": {
          "title": "java"
        }
      },
      "field_value_factor": {
        "field": "like"
      },
      "max_boost": 0.5 // 为了演示效果,如果 like 大于0.5,那么取值0.5
    }
  }
}
注意
不要执著在调整function_score上
文档相关度的调整非常玄,”最相关的文档” 是一个难以触及的模糊概念,每个人对文档排序有著不同的想法,这很容易使人陷入持续反覆调整,但是确没有明显的进展
为了避免跳入这种死循环,在调整function_score时,一定要搭配监控用户操作,才有意义
像是如果返回的文档是用户想要的高相关的文档,那麽用户就会选择前10个中的一个文档,得到想要的结果,反之,用户可能会来回点击,或是尝试新的搜索条件
一旦有了这些监控手段,想要调适完美的function_score就不是问题
因此调整function_score的重点在于,要透过监控用户、和用户互动,慢慢去调整我们的搜索条件,而不要妄想一步登天,第一次就把文档的相关度调整到最好,这几乎是不可能的,因为,连用户自己也不知道他自己想要什麽
感谢:
https://blog.csdn.net/weixin_40341116/article/details/80913045