说明
flink 提供了多个层次的 api,越上层,使用越简单;越底层,功能越强大
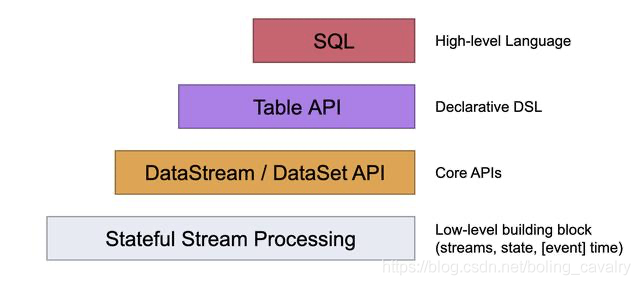
分为4层(一般使用上面 3 层):
- SQL:支持SQL语句
- Table API:通过方法对表进行查询、统计
- Core API:
- DataStream API:流式处理。
1.12版,流、批一体 - DataSet API:批处理。
1.12版不推荐使用
- DataStream API:流式处理。
- 低级api:ProcessFunction
官方文档
https://nightlies.apache.org/flink/flink-docs-release-1.12/
Table API 和 SQL
Table API和SQL,就是 流、批 统一的 上层处理API。
目前功能 尚未完善,处于活跃的开发阶段。
无论输入是 批输入 还是 流输入,在这两套API中,指定的查询都具有相同的语义,得到相同的结果。
官方文档:
https://ci.apache.org/projects/flink/flink-docs-release-1.12/dev/table/
Table API
Table API是一套内嵌在Java和Scala语言中的查询API,它允许我们以非常直观的方式,组合来自一些关系运算符的查询(比如select、filter和join)。
SQL
于Flink SQL,就是直接可以在代码中写SQL,来实现一些查询(Query)操作。Flink的SQL支持,基于实现了SQL标准的Apache Calcite(Apache开源SQL解析工具)。
Core API
DataStream API
DataStream是Flink编写流处理作业的API。
包含三部分:
- 数据源(Source):加载数据
- 转换操作(Transformation):处理数据
- 结果接收(Sink):输出结果
官方文档:
https://ci.apache.org/projects/flink/flink-docs-release-1.12/dev/datastream_api.html
DataSet API
在 1.12 不推荐使用
官方文档
https://ci.apache.org/projects/flink/flink-docs-release-1.12/dev/batch/
ProcessFunction
ProcessFunction是一个 低层次 的流处理操作,允许访问:
- 时间戳
- watermark
- 注册定时事件
能够为许多有事件驱动的应用程序实现复杂的事件处理逻辑
使用复杂,较少使用
参考:
https://www.jianshu.com/p/e6297fac67cb
https://blog.csdn.net/heiren_a/article/details/123084820