QJM解决方案
QJM全称 Quorum Journal Manager(仲裁日志管理器),是Hadoop 官方推荐 的HDFS HA解决方案之一。
使用zookeeper中ZKFC来实现主备切换;
使用Journal Node(JN)集群实现edits log的共享以达到数据同步的目的
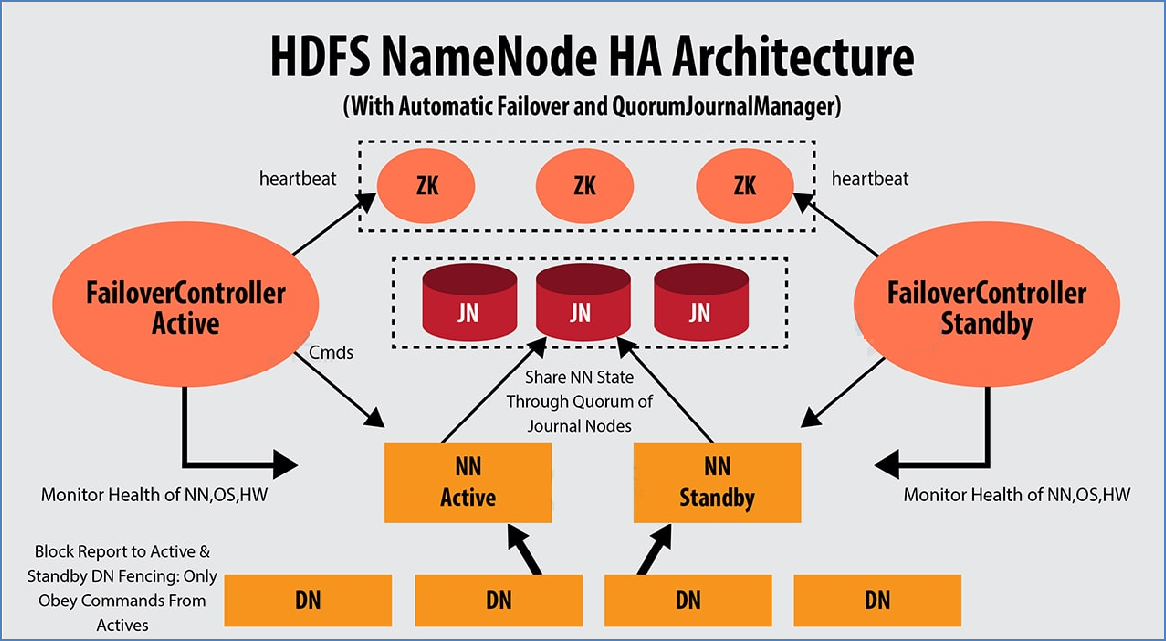
主备切换的实现 - ZKFailoverController(zkfc)
ZK Failover Controller(ZKFC)是一个ZooKeeper客户端。
Apache ZooKeeper
是一款高可用分布式协调服务软件,用于维护少量的协调数据。 Zookeeper的下列特性功能参与了HDFS的HA解决方案中:
临时znode
如果一个znode节点是临时的,那么该znode的生命周期将和创建它的客户端的session绑定。客户端断开连接session结束,znode将会被自动删除。Path路径唯一性
zookeeper中维持了一份类似目录树的数据结构。每个节点称之为Znode。Znode具有唯一性,不会重名。也可以理解为排他性。监听机制
客户端可以针对znode上发生的事件设置监听,当事件发生触发条件,zk服务会把事件通知给设置监听的客户端。
ZKFailoverController(ZKFC)
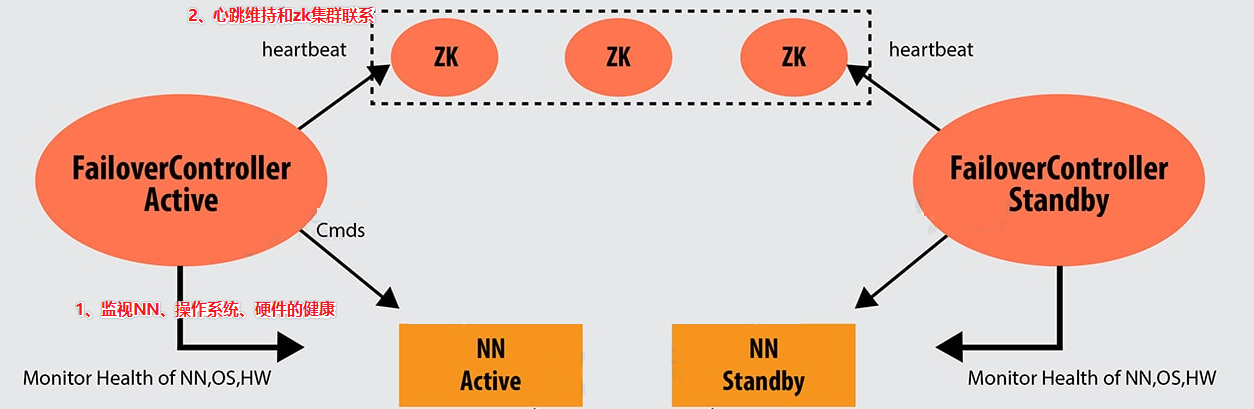
是一个ZooKeeper客户端。
运行 NameNode 的每台计算机也都运行 ZKFC,主要职责:
监视和管理
NameNode健康状态
ZKFC通过命令定期ping本地负责监视的NameNode节点。维持和
ZooKeeper集群联系
如果本地NameNode运行状况良好,并且ZKFC看到当前没有其他节点持有锁znode,它将自己尝试获取该锁。如果成功,则表明它赢得了选举,并负责运行故障转移以使其本地NameNode处于Active状态。
如果已经有其他节点持有锁,zkfc选举失败,则会对该节点注册监听,等待下次继续选举。
ZKFailoverController 的缺点
如果 ZKFC 出现问题,会造成 多个 NN 都在运行
如:左侧的 NN Active 正常运行,但 左侧 ZKFC 出现问题,说 该 NN 出现故障,此时,右侧的 NN Standby 就会变成 NN Active ,那就会发生脑裂问题
Fencing隔离机制 避免 脑裂问题
Fencing 机制来避免 脑裂问题,将先前的 Active 节点 杀死,然后将本地 NameNode 转换为 Active 状态。
Hadoop公共库中对外提供了两种 fenching 实现:
sshfence:通过ssh登陆目标节点上,使用命令fuser将进程杀死(通过tcp端口号定位进程pid,该方法比jps命令更准确)shellfence(缺省实现),执行一个用户事先定义的shell命令(脚本)完成隔离
主备数据同步 - Journal Node
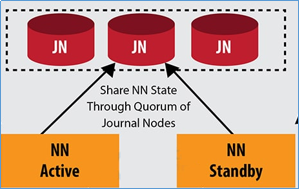
Journal Node(JN)集群是 轻量级 分布式系统,主要用于 高速 读写数据、存储数据。
通常使用 2N+1 台 JournalNode 存储共享 Edits Log(编辑日志)。
任何修改操作在 Active NN 上执行时,JournalNode 进程同时也会记录 edits log 到 至少半数以上 的JN中,这时 Standby NN 监测到 JN 里面的同步 log 发生变化了会读取JN 里面的 edits log,然后重演操作记录同步到自己的目录镜像树里面.
当发生故障 Active NN 挂掉后,Standby NN 会在它成为 Active NN 前,读取所有的 JN 里面的 edits log,这样就能高可靠的保证与挂掉的 NN 的目录镜像树一致,然后无缝的接替它的职责,维护来自客户端请求,从而达到一个高可用的目的。