介绍
Sequence File是Hadoop提供的一种 二进制 文件存储格式
这种二进制文件直接以 <key, value>键值对 形式 序列化到文件中
优点
- 二进制 格式存储,比文本文件更紧凑
- 支持不同级别压缩
- Record
- Block
- 文件可以 拆分 和 并行处理,适用于MapReduce
局限性
- 二进制格式文件不方便查看
- 特定于hadoop,只有Java API可用于与之件进行交互。尚未提供多语言支持。
Sequence File格式
有3种不同的Sequence File格式:
- 未压缩格式
- record压缩格式
- block压缩格式
组成
Sequence File由 一个 header 和一个或多个 record 组成
以上三种格式的 header 结构相同,如下:
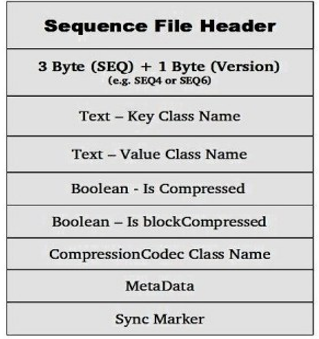
前3个字节为SEQ,表示该文件是序列文件,后跟一个字节表示实际版本号(例如SEQ4或SEQ6)
Header中其他部分包括
key、value class名字、 压缩细节、metadata、Sync marker。Sync Marker同步标记,用于可以读取任意位置的数据。
未压缩格式
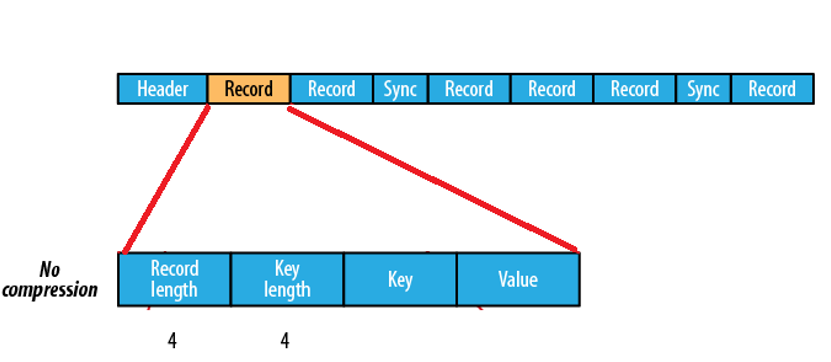
组成:
headerrecord,包含了4个部分:- record length(记录长度)
- key length(键长)
- key
- value
sync
每隔几个record(100字节左右)就有一个同步标记
基于record压缩格式
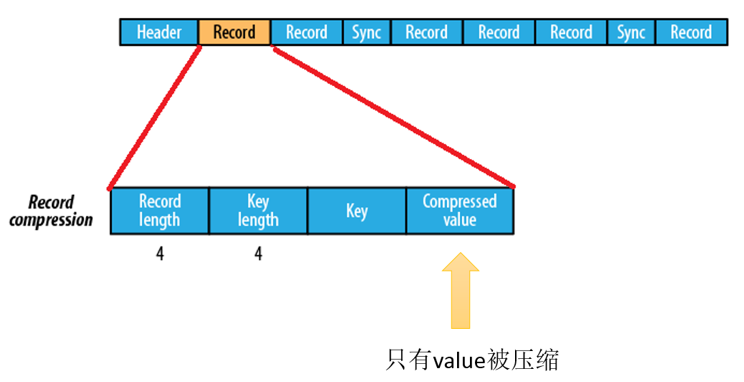
组成:
headerrecord,包含了4个部分:- record length(记录长度)
- key length(键长)
- key
- compressed value(被压缩的值)
sync
每隔几个record(100字节左右)就有一个同步标记。
基于block压缩格式(推荐)
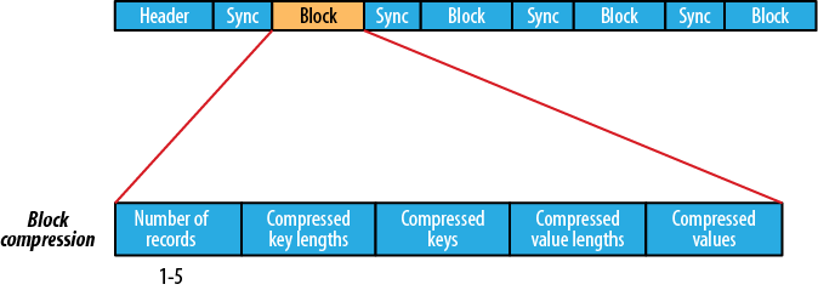
组成:
headerblock,record block,多个record记录组成的块(这个block和HDFS中分块存储的block(128M)是不同的概念)。
包含以下部分:- record条数
- 压缩的key长度
- 压缩的keys
- 压缩的value长度
- 压缩的values
sync
每隔一个block就有一个同步标记。
block 压缩比 record 压缩提供 更好的压缩率。
使用Sequence File时,通常首选块压缩。