为什么Spark读取Hive数据
Hive主要用于 大规模数据的 存储,也可以查询分析,但性能较差
Spark主要用于 大规模数据的 查询分析
Hive 定位
Hive的定位是 数据仓库,主要是以下功能:
- 负责数据的存储(底层是 HDFS)
- 通过 SQL查询分析数据,降低技术门槛。底层计算使用的是MapReduce,由于需要繁的磁盘IO,其计算 性能很差
Hive一般用来处理结构化数据
Spark 定位
spark是一个通用的处理大规模数据的 分析引擎,不负责数据存储。
Spark基于 内存计算,凭借着DAG和RDD特性(保证中间数据如果丢失可以重新计算恢复),可以将计算的中间结果以RDD的形式保存在内存中,而不需要频繁的磁盘IO,计算性能远高于Hadoop的MapReduce
分析处理数据的方式,可以使用SQL,也可以使用java,scala, python、R等api
分析处理数据的模式,既可以是 批处理,也可以是 流处理,主要是 批处理
Spark读取Hive数据的方法
spark读取hive数据,有两种方式
- Spark on Hive
- Spark JDBC
Spark on Hive
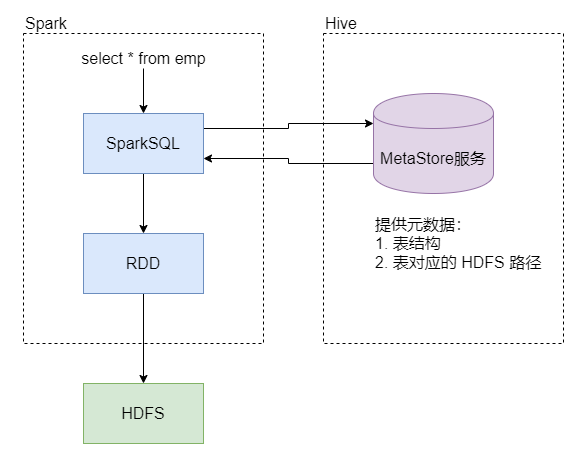
将Spark构建在Hive之上,Spark需要用到Hive:
- 通过SparkSQL,加载Hive的配置文件,获取到Hive的 metastore信息,进而获得metadata;
- SparkSQL 获取到metadata之后就可以去访问Hive的所有表的数据(在 HDFS 上)
- 接下来就可以通过SparkSQL来操作Hive表中存储的数据(查询速度快)
这种方式的特点是 效率高、数据吞吐量大、使用spark操作起来更加友好
Spark JDBC
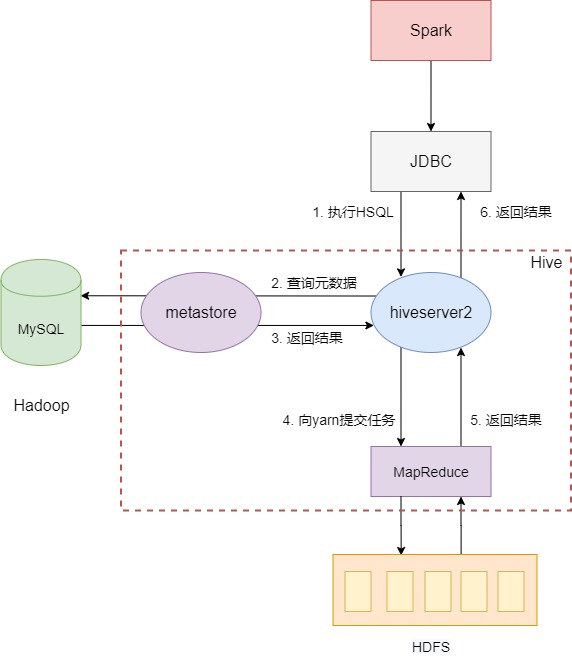
通过 Spark JDBC 的方式访问,通过连接 hiveserver2 的方式获取数据,这样大部分 数据计算压力在 Hive上,Hive底层用 MapReduce ,会将中间结果保存到 HDFS 上,查询慢