介绍
local模式,如果不需要读取 HDFS上的文件,就不需要启动hadoop,只需要一个命令,就可以执行 Spark 环境,一般用于学习,演示等
安装
上传到linux
登录 hadoop1,上传 spark-3.0.0-bin-without-hadoop.tgz 到 /program 目录下
从 Spark 1.4 版本开始,该项目打包了 Hadoop free 版本,可以更轻松地将单个 Spark 二进制文件连接到任何 Hadoop 版本
但要设置 SPARK_DIST_CLASSPATH,下面有详细解释
解压缩
tar -zxvf spark-3.0.0-bin-without-hadoop.tgz --no-same-owner
修改文件名
mv spark-3.0.0-bin-without-hadoop spark-3.0.0
配置环境变量
vim /etc/profile.d/bigdata_env.sh
增加下面内容:
export SPARK_HOME=/program/spark-3.0.0
export PATH=${SPARK_HOME}/bin:$PATH
增加 python3 环境变量(推荐)
spark-submit 和 pyspark 都使用python3
export PYSPARK_PYTHON=python3
立即生效
source /etc/profile
测试
echo $SPARK_HOME
创建 spark-env.sh
cd /program/spark-3.0.0/conf/
根据模板复制 spark-env.sh 文件:
cp spark-env.sh.template spark-env.sh
编辑文件:
vim spark-env.sh
在末尾添加下面内容:
export HADOOP_CONF_DIR=/program/hadoop-3.0.3/etc/hadoop
export SPARK_DIST_CLASSPATH=$(hadoop classpath)
export LD_LIBRARY_PATH=$HADOOP_HOME/lib/native
解释:
指定
HADOOP_CONF_DIR配置目录,可以读取 HDFS 集群相关的配置由于是
without-hadoop版本,所以需要指定SPARK_DIST_CLASSPATH,否则找不到 hadoop相关jar包LD_LIBRARY_PATH:详见 链接
增加 python3 环境变量(不推荐)
spark-submit 和 pyspark 都使用python3
export PYSPARK_PYTHON=python3
测试 spark-submit
通过内置的计算 PI 程序,进行测试,如果能够正常运行,说明 部署成功
spark-submit --master local[*] /program/spark-3.0.0/examples/src/main/python/pi.py 10
解释:
10:蒙特卡洛 算法计算 PI,这个数字越大,那么计算出PI的结果越准确
执行结果如下图:
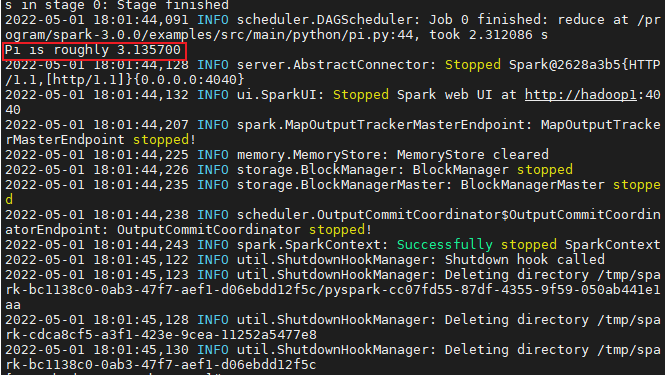
红框处是 PI 的计算结果
web 页面
程序没运行结束时,访问 http://hadoop1:4040 ,显示 web监控页面,如下:
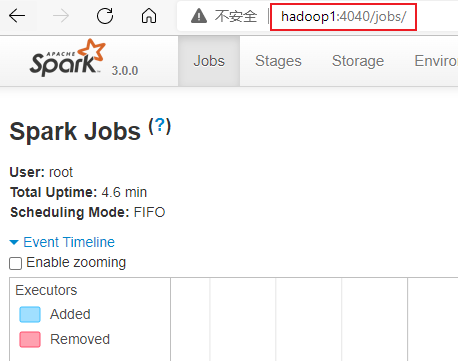
可以看到上面运行的任务
测试 pyspark
https://www.malaoshi.top/show_1IX3EWnrOnr0.html