案例
默认shuffle 有200个分区
执行下面的代码:
from time import sleep
import findspark
findspark.init()

from pyspark.sql import  SparkSession

spark = SparkSession.builder.\
    appName("test").\
    master("local[*]").\
    enableHiveSupport().\
    getOrCreate()

spark.sparkContext.setLogLevel("ERROR")

# 200个任务
df = spark.sql("select gender,avg(age) as avg_age from soh_student group by gender order by avg_age")

# 75+100+20+4+2个任务
# df = spark.sql("select gender,avg(age) as avg_age from soh_student group by gender order by avg_age")

df.show()

sleep(60) # 休眠60秒
spark.stop()
执行上面的代码时,控制显示如下:

可见有 200个任务
查看 web 监控页面
访问 http://hadoop1:4040 ,页面如下:

有 200个任务
点击超链接,显示如下:
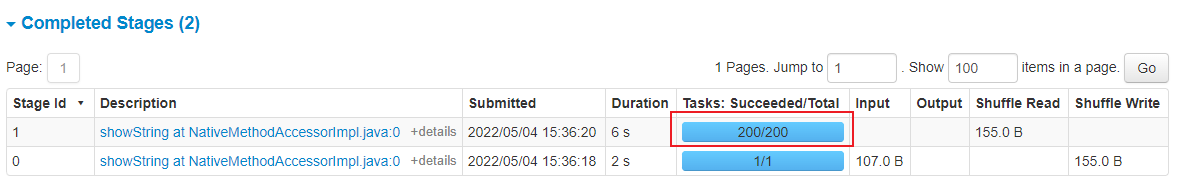
有一个操作,开启了 200个任务,点击该任务的 超链接,显示如下:
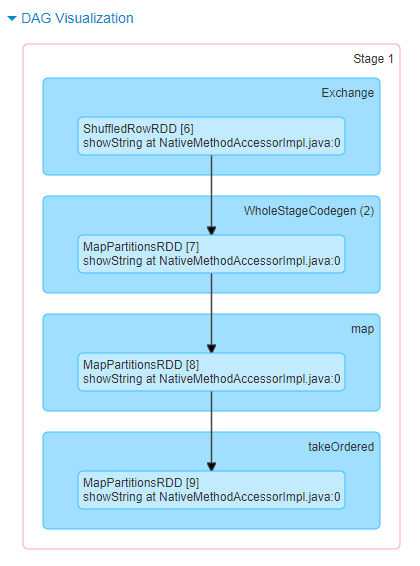
是 shuffle 阶段
提出问题
默认 200个任务,有以下问题:
- 单机运行,开启这么多任务,效率反而低
- 集群运行,当数据量较小,开启这么多任务,浪费资源。而且任务执行时间较短,大部分时间都用在调度
- 集群运行,当数据量较大,开启任务较少,不能充分利用集群资源,效率低
解决
设置初始分区的 1.5-2倍之间
config("spark.sql.shuffle.partitions", "2").\
代码
# 默认shuffle 有200个分区

from time import sleep
import findspark
findspark.init()

from pyspark.sql import  SparkSession

spark = SparkSession.builder.\
    appName("test").\
    master("local[*]").\
    enableHiveSupport().\
    config("spark.sql.shuffle.partitions", "2").\
    getOrCreate()

spark.sparkContext.setLogLevel("ERROR")

# 200个任务
df = spark.sql("select gender,avg(age) as avg_age from soh_student group by gender order by avg_age")

df.show()

sleep(60)
spark.stop()