HashPartitioner
HashPartitioner采用 哈希 的方式进行分区
缺点
可能导致每个分区中数据量的 不均匀,极端情况下会导致某些分区拥有RDD的全部数据,导致 数据倾斜
原理
查看 HashPartitioner.getPartition()源代码可知,底层实现是 key.hashCode % 分区数量
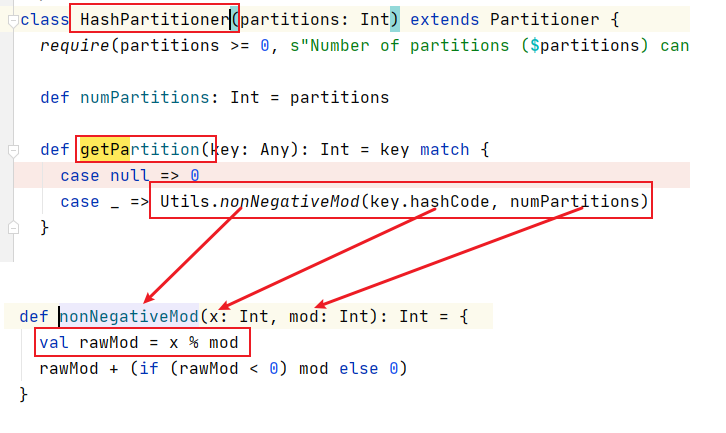
验证
spark代码:
def main(args: Array[String]): Unit = {
  val conf: SparkConf = new SparkConf().setMaster("local[*]").setAppName("mywordcount")

  val sc: SparkContext = new SparkContext(conf)
  val rdd = sc.makeRDD(List("李雷", "lucy", "lili", "韩梅梅", "张三", "李四", "王五"),2)
  rdd.groupBy(e => e)
    .map( _._1)
    .saveAsTextFile("res/grp")
  sc.stop()
}
生成2个文件:
- 第一个文件,数据:
lili - 第二个文件,数据:
张三
李雷
韩梅梅
李四
王五
lucy
scala 验证:
def main(args: Array[String]): Unit = {
    val list = List("李雷", "lucy", "lili", "韩梅梅", "张三", "李四", "王五")

    def nonNegativeMod(x: Int, mod: Int): Int = {
      val rawMod = x % mod
      rawMod + (if (rawMod < 0) mod else 0)
    }

    for(item <- list){
      val i = nonNegativeMod(item.hashCode, 2)
      println(i,"--",item)
    }
}
执行结果:
李雷--1号文件
lucy--1号文件
lili--0号文件
韩梅梅--1号文件
张三--1号文件
李四--1号文件
王五--1号文件
验证结果与spark生成文件相同
RangePartitioner
可避免 HashPartitioner 的数据倾斜,将一定范围内的数映射到某一个分区内,尽量保证
每个分区中数据量的 均匀,而且 分区与分区之间是 有序的,一个分区中的元素肯定都是比另一个分区内的元素小或者大
但是分区内的元素是不能保证顺序的。
将一定范围内的数映射到某一个分区内,实现过程为:
第一步:先重整个RDD中抽取出样本数据,将样本数据排序,计算出每个分区的最大key值,形成一个Array[KEY]类型的数组变量rangeBounds;
第二步:判断key在rangeBounds中所处的范围,给出该key值在下一个RDD中的分区id下标;该分区器要求RDD中的KEY类型必须是可以排序的
自定义分区
要实现自定义的分区器,需要继承
org.apache.spark.Partitioner
并实现下面三个方法。
numPartitions: Int:返回创建出来的分区数。
getPartition(key: Any): Int:返回给定键的分区编号(0到numPartitions-1)。
equals():Java 判断相等性的标准方法。这个方法的实现非常重要,Spark 需要用这个方法来检查你的分区器对象是否和其他分区器实例相同,这样 Spark 才可以判断两个 RDD 的分区方式是否相同。
参考:
https://www.cnblogs.com/tongxupeng/p/10435976.html
https://www.cfanz.cn/resource/detail/OzYKJXWYvmzZG