说明
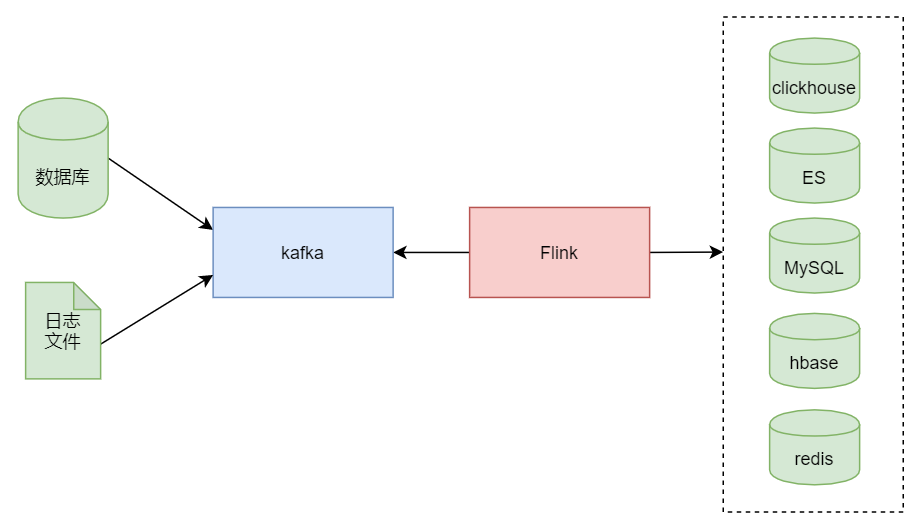
消息队列符合Flink的流处理,数据源源不断的流入到消息队列,Flink从消息队列中源源不断的读取数据
Kafka作为分布式消息队列,特点是:高吞吐、易扩展,所以kafka与Flink是黄金搭档
企业开发中,通常架构如下图:
Kafka 消费者连接器 api
FlinkKafkaConsumer(String topic, DeserializationSchema<T> valueDeserializer, Properties props)
形参:
- topic:主题
- valueDeserializer:反序列化器
- props:kafka相关配置,如:
- kafka服务器ip、port
- group_id
- 偏移量
案例
pom.xml
添加下面依赖
<!-- kafka Dependency -->
<dependency>
    <groupId>org.apache.flink</groupId>
    <artifactId>flink-connector-kafka_2.12</artifactId>
    <version>${flink.version}</version>
</dependency>
完整依赖
<properties>
    <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding>
    <maven.compiler.source>1.8</maven.compiler.source>
    <maven.compiler.target>1.8</maven.compiler.target>
    <flink.version>1.12.0</flink.version>
</properties>

<dependencies>
    <!--java-->
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-java</artifactId>
        <version>${flink.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-streaming-java_2.12</artifactId>
        <version>${flink.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-clients_2.12</artifactId>
        <version>${flink.version}</version>
    </dependency>
    <dependency>
        <groupId>org.slf4j</groupId>
        <artifactId>slf4j-api</artifactId>
        <version>1.7.30</version>
    </dependency>
    <dependency>
        <groupId>org.slf4j</groupId>
        <artifactId>slf4j-log4j12</artifactId>
        <version>1.7.30</version>
    </dependency>
    <dependency>
        <groupId>log4j</groupId>
        <artifactId>log4j</artifactId>
        <version>1.2.17</version>
    </dependency>
    <!-- kafka Dependency -->
    <dependency>
        <groupId>org.apache.flink</groupId>
        <artifactId>flink-connector-kafka_2.12</artifactId>
        <version>${flink.version}</version>
    </dependency>
</dependencies>
java
package top.malaoshi;

import org.apache.flink.api.common.serialization.SimpleStringSchema;
import org.apache.flink.streaming.api.datastream.DataStreamSource;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.connectors.kafka.FlinkKafkaConsumer;
import org.apache.kafka.clients.consumer.ConsumerConfig;

import java.util.Properties;

public class FromKafka {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();

        // 定义kafka相关配置项
        Properties pro = new Properties();
        pro.setProperty(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG,"hadoop1:9092,hadoop2:9092,hadoop3:9092");
        pro.setProperty(ConsumerConfig.GROUP_ID_CONFIG,"consumer-group");
        pro.setProperty(ConsumerConfig.AUTO_OFFSET_RESET_CONFIG,"latest");

        // 内置连接器,创建FlinkKafka消费者,需要指定主题、反序列化、kafka配置
        FlinkKafkaConsumer<String> fkc = new FlinkKafkaConsumer<>("kafka2flink", new SimpleStringSchema(), pro);
        DataStreamSource<String> dss = env.addSource(fkc);
        dss.print();

        env.execute();
    }
}
启动zk
登录 hadoop1,执行下面命令:
/program/bin/zk.sh start
启动kafka
登录 hadoop1,执行下面命令:
/program/bin/kafka.sh start
启动 flink
在 idea 中运行 flink 程序
启动生产者、指定主题
登录 hadoop1,执行下面命令:
/program/kafka_2.12-2.4.1/bin/kafka-console-producer.sh --broker-list hadoop1:9092,hadoop2:9092,hadoop3:9092 --topic kafka2flink
然后输入:
>lucy 韩梅梅
>lili lilei
>java hadoop
执行结果
在 idea 控制台中打印结果如下:
lucy ��÷÷
lili lilei
java hadoop
linux 控制台输入中文,会有问题,可忽略