整体架构
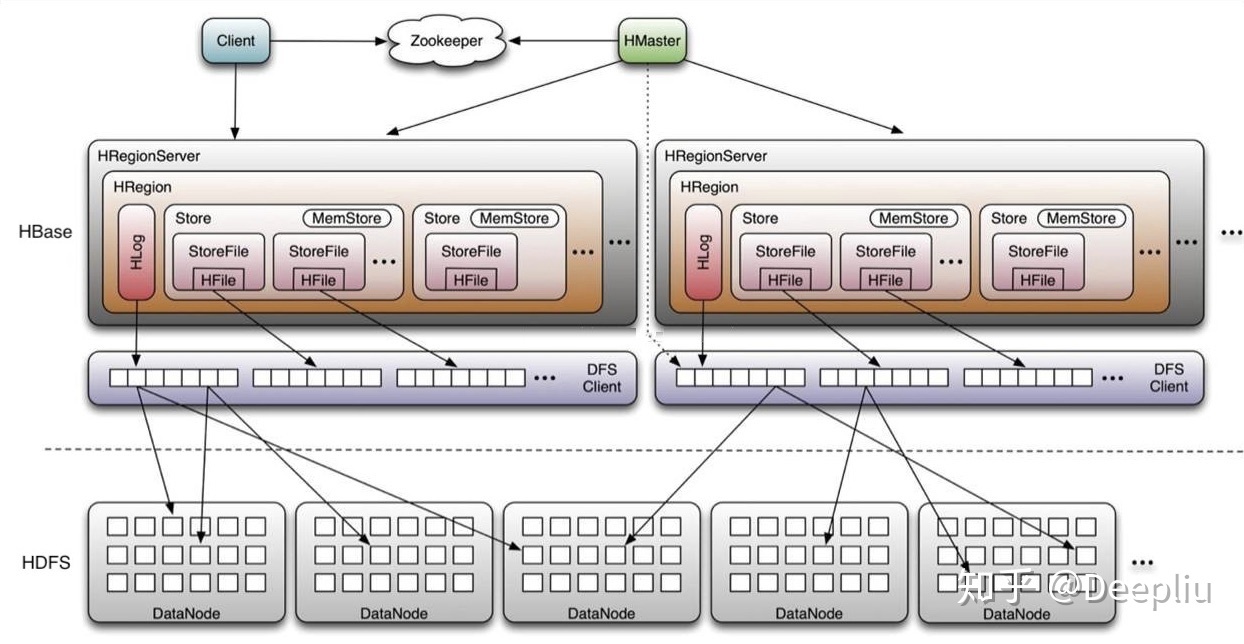
HBase由三种类型的服务器以主从模式构成:
ZooKeeper:负责 维护集群的状态(某台服务器是否在线,服务器之间数据的同步操作及master的选举等)。
HBase HMaster:负责 Region 的分配、数据库的 创建和删除 等操作。
Region Server:负责 数据的读写 服务,用户通过与Region server交互来实现对数据的访问。
HDFS的DataNode,负责 存储 Region Server 所管理的数据,即:HBase中的所有数据都是存储到 HDFS。
Region server是根据DataNode分布的,HBase的数据在写入的时候都存储在本地。
(当某一个region被移除或被重新分配的时候,就可能产生数据不在本地的情况。这种情况只有在所谓的compaction之后才能解决。)
Zookeeper
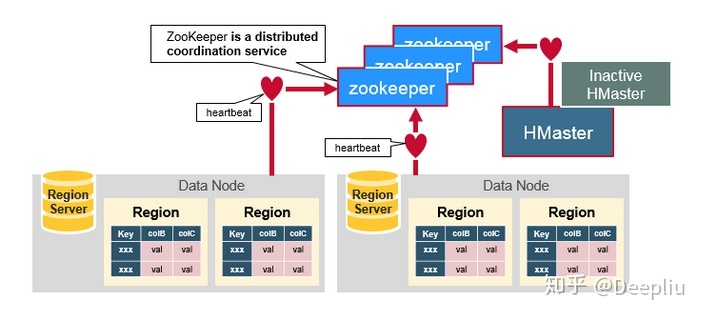
HBase利用ZooKeeper维护集群中服务器的状态并协调分布式系统的工作,其功能如下:
- 维护服务器 是否存活,是否可访问的状态并提供服务器故障/宕机的通知。
- 使用一致性算法来保证服务器之间的同步。
- 负责Master选举的工作。
注意:保证良好的一致性、顺利选举Master,集群中的服务器数目必须是 奇数(如三台或五台)。
组件间的协作
HBase 通过 ZooKeeper 来完成选举 HMaster、监控 Region Server、维护元数据集群配置等工作
包括:
- 选举HMaster:通zooKeeper来保证集中有HMaster在运行,如果 HMaster 异常,则会通过 选举机制 产生新的 HMaster 来提供服务;
- 监控Region Server: 通过 ZooKeeper 来监控 Region Server 的状态,当Region Server 有异常的时候,通过回调的形式通知 HMaster 有关Region Server 上下线的信息;
- 维护元数据和集群配置:通过 zooKeeper 存储信息并对外提供访问接口。
详细(了解)
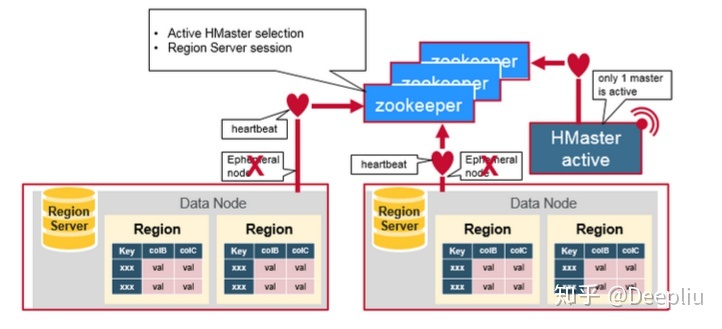
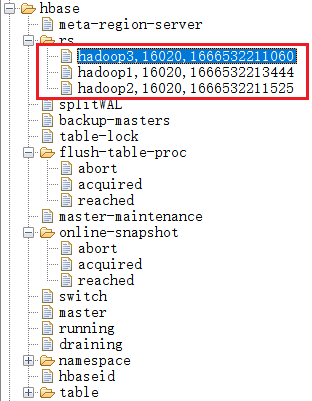
每一个Region server都在ZooKeeper中创建相应的 临时节点(ephemeral node) 。
HMaster通过监控这些 临时节点 (ephemeral node) 的状态来发现正常工作的或发生故障下线的Region server。
HMaster之间通过互相竞争创建ephemeral node进行Master选举。ZooKeeper会选中第一个创建成功的HMaster。活跃的HMaster向ZooKeeper发送心跳信息来表明自己在线的状态。不活跃的HMaster则监听活跃HMaster的状态,并在活跃HMaster发生故障下线之后重新选举,从而实现了HBase的高可用性。
如果Region server或者HMaster不能成功向ZooKeeper发送心跳信息,则其与ZooKeeper的连接超时之后与之相应的ephemeral node就会被删除。
监听ZooKeeper状态的其他节点就会得到相应node不存在的信息,从而进行相应的处理。活跃的HMaster监听Region Server的信息,并在其下线后重新分配Region server来恢复相应的服务。不活跃的HMaster监听活跃HMaster的信息,并在起下线后重新选出活跃的HMaster进行服务。
HMaster
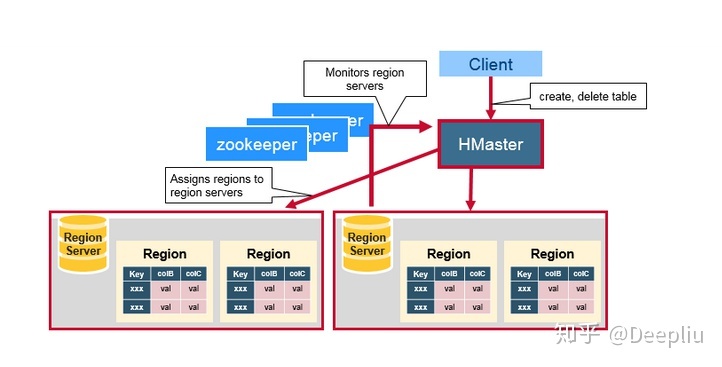
HMaster负责region的分配,数据库的创建和删除操作
包括:
- 调控Region server的工作
- 在集群启动的时候分配region,根据恢复服务或者负载均衡的需要重新分配region。
- 监控集群中的Region server的工作状态。(通过监听zookeeper对于ephemeral node状态的通知)。
- 管理数据库
- 提供创建,删除或者更新表格的接口。
Region Server
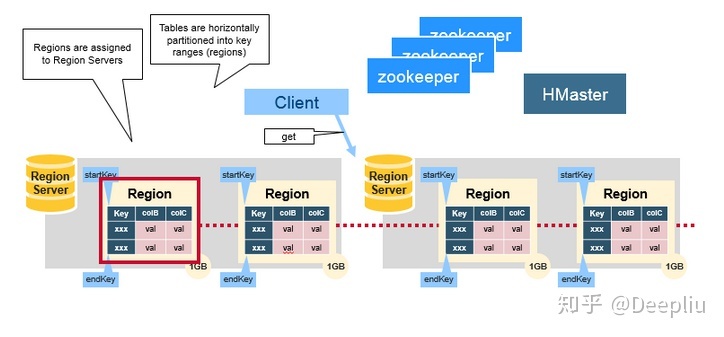
HBase中的表是根据 rowkey 的值水平分割成所谓的 region 的。一个region包含表中所有row key位于region的 起始键值 和 结束键值 之间的行。
集群中负责管理 Region 的结点叫做 Region server。
Region server 负责数据的读写。每一个Region server大约可以管理 1000个region。
Region的结构如下图:
组成部分
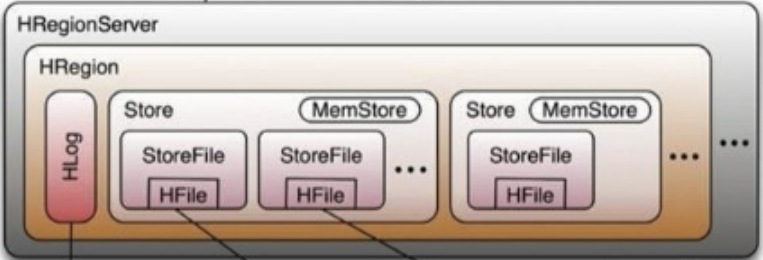
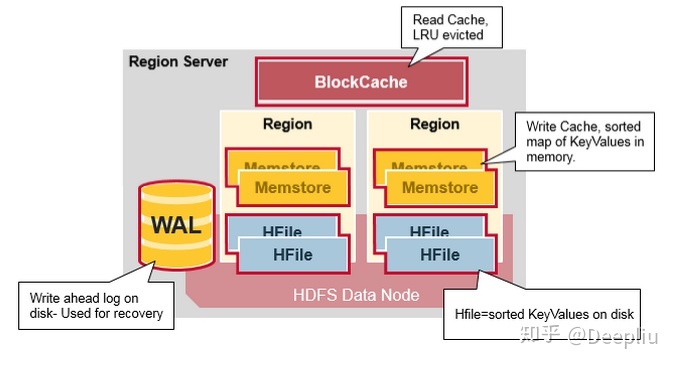
Region server由如下几个部分组成:
Store:一个 Region 由多个 Store 组成,每个 Store 都对应一个 Column Family, Store 包含 MemStore 和 StoreFile
WAL:既Write Ahead Log。WAL是HDFS分布式文件系统中的一个文件,即HLog。WAL用来存储尚未写入永久性存储区中的新数据。WAL也用来在服务器发生故障时进行数据恢复。
Block Cache:Block cache是读缓存。Block cache将经常被读的数据存储在内存中来提高读取数据的效率。当Block cache的空间被占满后,其中被读取频率最低的数据将会被杀出。
MemStore:MemStore是写缓存。其中存储了从WAL中写入但尚未写入硬盘的数据。MemStore中的数据在写入硬盘之前会先进行 排序 操作。每一个region中的每一个column family对应一个MemStore。
Hfiles:Hfiles存在于硬盘上,其数据是已经 排序 的。
HLog:负责记录着数据的操作日志,当HBase出现故障时可以进行日志重放、故障恢复。例如,磁盘掉电导致 MemStore中的数据没有持久化存储到 StoreFile,这时就可以通过HLog日志重放来恢复数据。
数据读写
META Table
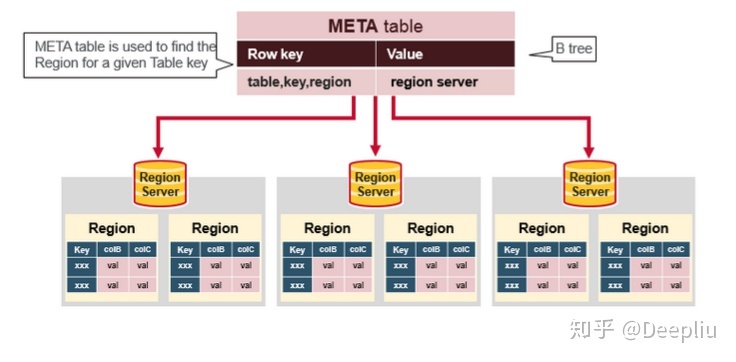
META table中保存集群 region 的地址信息。ZooKeeper中会保存META table的位置。
META table中保存了HBase中所有region的信息,格式类似于B tree。其结构如下:
- 键:region的起始键,region id。
- 值:Region server
第一次读写
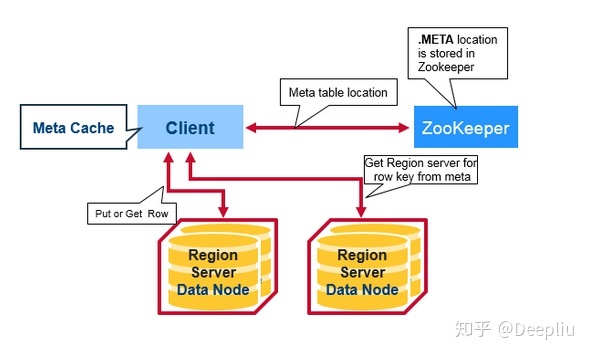
当用户第一次从HBase中进行读或写操作时,执行以下步骤:
- 客户端从ZooKeeper中得到保存META table的Region server的信息。
- 客户端向该Region server查询负责管理自己想要访问的row key的所在的region的Region server的地址。客户端会缓存这一信息以及META table所在位置的信息。
- 客户端与负责其row所在region的Region Server通信,实现对该行的读写操作。
在未来的读写操作中,客户端会根据缓存寻找相应的Region server地址。除非该Region server不再可达。这时客户端会重新访问META table并更新缓存。这一过程如下图所示:
写操作
步骤一
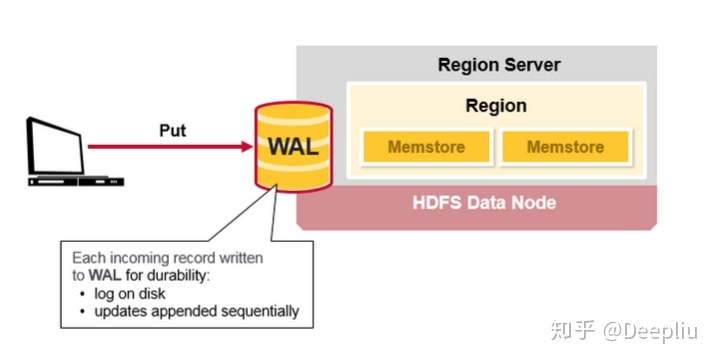
当HBase的用户发出一个 PUT 请求时(也就是HBase的写请求),HBase进行处理的第一步是将数据写入HBase的 WAL(write-ahead log)中。
WAL文件是顺序写入的,也就是所有新添加的数据都被 追加WAL文件的末尾。WAL文件存在硬盘上。
当server出现问题之后,WAL可以被用来 恢复 尚未写入HBase中的 数据(因为WAL是保存在硬盘上的)。
步骤二
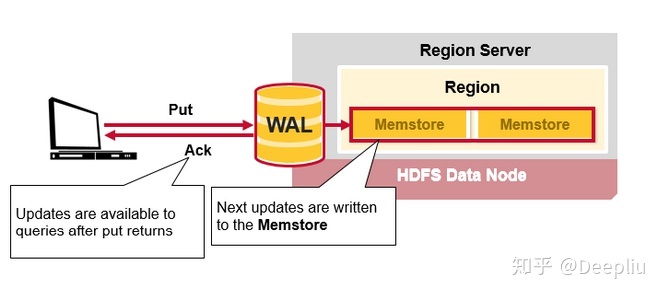
当数据被成功写入WAL后,HBase将数据存入 MemStore。这时HBase就会通知用户PUT操作已经成功了。
MemStore flush到磁盘
MemStore存在于内存中,其中存储的是 按键排好序 的待写入硬盘的数据。
数据也是按键排好序写入HFile中的。每一个Region中的每一个 Column family 对应一个 MemStore 文件(所以Column family的数目有限制)。因此对数据的更新也是对应于每一个Column family。
如下图所示:
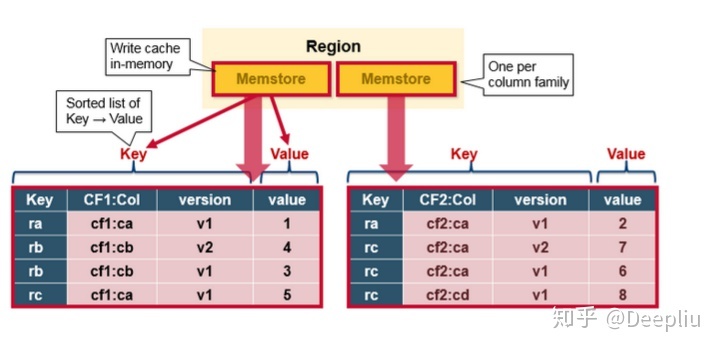
当MemStore中 积累了足够多 的数据之后,整个MemCache中的数据会被 一次性写入到HDFS里的一个新的HFile中。因此HDFS中一个 Column family 可能对应 多个 HFile。这个HFile中包含了相应的cell,或者说键值的实例。这些文件随着MemStore中积累的对数据的操作被flush到硬盘上而创建。
StoreFile
在磁盘上保存原始数据的存储文件,要求 数据是有序的
StoreFile是以Hfile的形式存储在HDFS的。每个 Store 会有
一个或多个 StoreFile,数据在每个 StoreFile 中都是有序的(按照Rowkey的字典顺序排序)。
Hfile
在磁盘上保存原始数据的存储文件,要求 数据是有序的
上面已经说过,当MemStore中积累足够多的数据的时候就会将其中的数据整个写入到HDFS中的一个新的HFile中。因为MemStore中的数据已经 按照键排好序,所以这是一个顺序写的过程。由于顺序写操作避免了磁盘大量寻址的过程,所以这一操作非常高效。
StoreFile 和 HFile 关系
StoreFile是以HFile格式保存在HDFS上,对HFile做了轻量级封装。
HFile 和 StoreFile 是同一个文件,只不过站在 HDFS 的角度称这个文件为HFile,站在HBase的角度就称这个文件为StoreFile。
读合并(Read Merge)
HBase中对应于某一行数据的 cell 可能位于 多个不同的文件 或 存储介质 中。
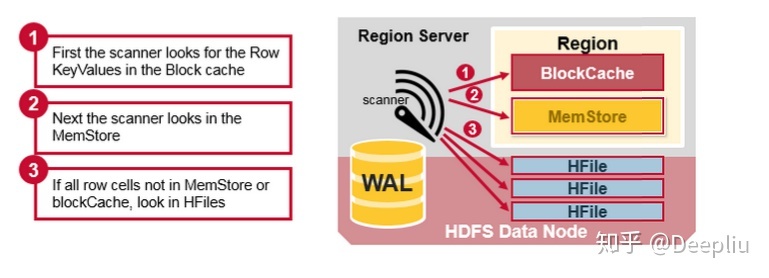
比如已经存入 硬盘上的HFile 中,新加入或更新的数据位于 内存 中的 MemStore 中,最近读取过的数据则位于 内存中的Block cache中。所以当我们读取某一行的时候,为了返回相应的行数据,HBase需要根据Block cache,MemStore以及硬盘上的HFile中的数据进行所谓的 读合并操作。
HBase会首先从
Block cache(HBase的读缓存)中寻找所需的数据。接下来,HBase会从
MemStore中寻找数据。因为作为HBase的写缓存,MemStore中包含了最新版本的数据。如果HBase从
Block cache和MemStore中没有找到行所对应的cell所有的数据,系统会接着根据索引和 bloom filter(布隆过滤器) 从相应的HFile中读取目标行的cell的数据。
如下图所示:
读放大(Read amplification)
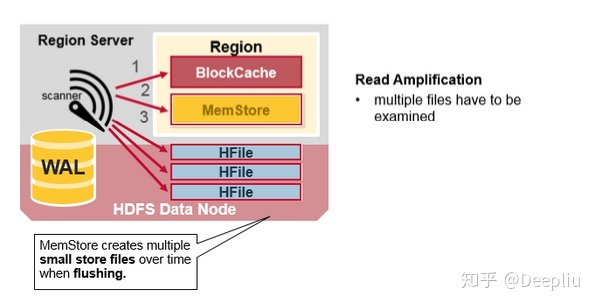
这里一个需要注意读放大效应(Read amplification)。根据前文所说,一个MemStore对应的数据可能存储于多个不同的HFile中(由于多次的flush),因此在进行读操作的时候,HBase可能需要读取多个HFile来获取想要的数据。这会影响HBase的性能表现。
如下图所示:
参考:
https://zhuanlan.zhihu.com/p/159052841
https://blog.csdn.net/pxg943055021/article/details/124815832
https://blog.csdn.net/weixin_43726774/article/details/105193483