提出问题
判断一个元素是否在某个集合中
分析
一般想到的是将集合中所有元素保存起来,然后通过比较确定。
链表、树、散列表(又叫哈希表,Hash table)等等数据结构都是这种思路。
缺点
随着集合中元素的增加,需要的存储空间也会呈现线性增长,最终达到瓶颈。
同时检索速度也越来越慢:
- 链表 检索时间复杂度:
O(n) - 树 检索时间复杂度:
O(logn) - 散列表检索时间复杂度:
O(1)
解决
使用 布隆过滤器(Bloom Filter)
布隆过滤器
布隆过滤器(Bloom Filter)是 1970 年由布隆提出的。它实际上是一个很长的二进制向量和一系列随机映射函数。主要用于判断一个元素是否在一个集合中。
应用场景
数据库防止穿库。 Google Bigtable,HBase 和 Cassandra 以及 Postgresql 使用BloomFilter来减少不存在的行或列的磁盘查找。避免代价高昂的磁盘查找会大大提高数据库查询操作的性能。
业务场景中判断用户是否阅读过某视频或文章,比如抖音或头条,当然会导致一定的误判,但不会让用户看到重复的内容。
WEB拦截器,如果相同请求则拦截,防止重复被攻击、刷单。用户第一次请求,将请求参数放入布隆过滤器中,当第二次请求时,先判断请求参数是否被布隆过滤器命中。可以提高缓存命中率。Squid 网页代理缓存服务器在 cache digests 中就使用了布隆过滤器。Google Chrome浏览器使用了布隆过滤器加速安全浏览服务。
原理
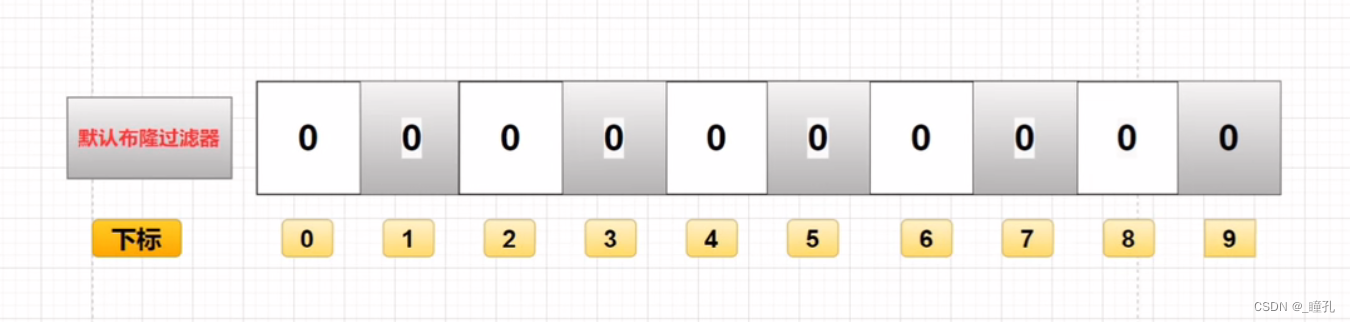
布隆过滤器是由一个固定大小的二进制向量或者位图(bitmap)和一系列映射函数组成的。在初始状态时,对于长度为 m 的位数组,它的所有位都被置为0,如下图所示:
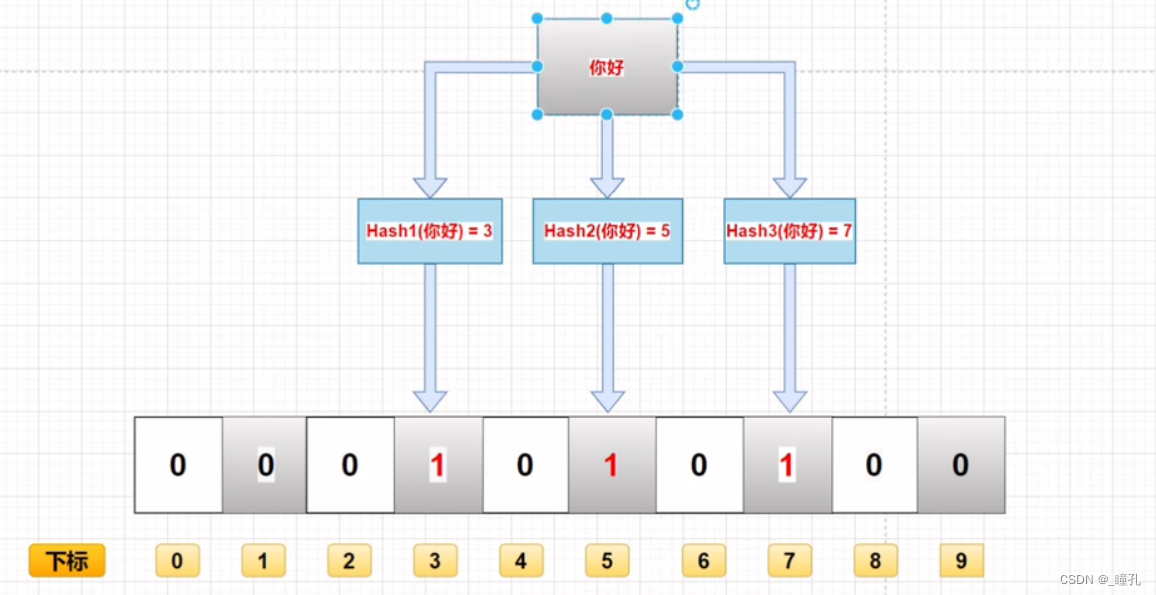
当有变量被加入集合时,通过 K 个映射函数将这个变量映射成位图中的 K 个点,把它们置为 1,如下图:
判断元素是否存在
判断某个元素是否在该集合中,进行下面判断:
如果这些点有任何一个
0,则被查询变量 一定不在如果都是
1,则被查询变量 很可能存在
为什么是 可能存在
因为 映射函数 本身就是 散列函数,散列值可能 碰撞(如:String类的 hashCode() 方法)
误判率
由于 哈希函数 的值 会发生 碰撞,所以不同元素,经过哈希之后在 相同的bit位置 都为 1,就无法判断 是否真的存在
同时也造成了布隆过滤器的 删除问题,因为布隆过滤器的每一个 bit 并不是独占的,很有可能多个元素共享了某一位。如果直接删除这一位的话,会影响其他的元素。
特性
- 判断元素为存在的时候,元素不一定存在
- 判断元素为不存在的时候,则一定不存在
- 可以 添加元素
- 不能删除元素,因为删掉元素会 导致误判率增加
优点
相比于其它的数据结构,布隆过滤器在空间和时间方面都有巨大的优势。布隆过滤器存储空间和插入/查询时间都是常数 O(K)
散列函数相互之间没有关系,方便由硬件并行实现。
布隆过滤器 不需要存储元素本身,在某些对保密要求非常严格的场合有优势。
布隆过滤器可以表示全集,其它任何数据结构都不能;
缺点
- 随着存入的元素数量增加,误算率随之增加。
- 如果元素数量较少,则使用散列表足矣
- 一般不能删除元素
变种
为了降低误算率,有很多布隆过滤器的变种
参考:
https://blog.csdn.net/tongkongyu/article/details/124842847