上接:flink1.12.x sink-发送数据到kafka(自定义序列化器)
说明
有时需要根据 数据 进行分区,需要以下两个步骤
步骤一
继承 FlinkKafkaPartitioner 类,并重写 partition() 方法 ,该类源码如下:
public abstract class FlinkKafkaPartitioner<T> implements Serializable {

    private static final long serialVersionUID = -9086719227828020494L;

    /**
     * 分区器初始化方法,每个并行度都会调用一次该方法(仅在初始化时调用一次)
     *
     * @param parallelInstanceId 当前并行任务的索引
     * @param parallelInstances  并行度的总数
     */
    public void open(int parallelInstanceId, int parallelInstances) {
        // overwrite this method if needed.
    }

    /**
     * 自定义分区规则
     *
     * @param record flink上游算子传入的数据
     * @param key 序列化的key
     * @param value 序列化的value
     * @param targetTopic 主题
     * @param partitions 该主题的分区索引
     *
     * @return 返回分区索引,从0开始,负数会报错
     */
    public abstract int partition(T record, byte[] key, byte[] value, String targetTopic, int[] partitions);
}
步骤二
创建 Producer 时,指定该分区器
Properties properties = new Properties();
properties.setProperty(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG,"hadoop1:9092,hadoop2:9092,hadoop3:9092");
FlinkKafkaProducer myProducer = new FlinkKafkaProducer(
        "userlog2", // 主题 topic,
        new JsonSerializationSchema(),
        properties,
        Optional.of(new FlinkKafkaPartitionerImpl())); // 容错
例子
package sink;

import org.apache.flink.api.common.functions.RichFlatMapFunction;
import org.apache.flink.api.common.serialization.SerializationSchema;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.streaming.api.datastream.DataStreamSource;
import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.connectors.kafka.FlinkKafkaProducer;
import org.apache.flink.streaming.connectors.kafka.partitioner.FlinkKafkaPartitioner;
import org.apache.flink.util.Collector;
import org.apache.kafka.clients.producer.ProducerConfig;

import java.util.Optional;
import java.util.Properties;

/**
 * 运行时需要指定参数:--config d:/flink.properties
 */
public class Stdkafka {

    public static void main(String[] args) throws Exception {

        final StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(3);
        DataStreamSource<String> dss = env.fromElements(
                "李雷 韩梅梅",
                "韩梅梅 lili",
                "lucy 李雷",
                "lili lucy");
        // 处理
        SingleOutputStreamOperator<Tuple2<String, Integer>> soso = dss
                .flatMap(new FlatMapFunImpl())
                .keyBy(value -> value.f0)
                .sum(1);

        soso.print("res:");
        // 发送到 kafka
        soso.addSink(buildKafkaProducer());
        env.execute("myjob");
    }

    private static FlinkKafkaProducer buildKafkaProducer(){

        Properties properties = new Properties();
        properties.setProperty(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG,"hadoop1:9092,hadoop2:9092,hadoop3:9092");
        FlinkKafkaProducer myProducer = new FlinkKafkaProducer(
                "userlog2", // 主题 topic,
                new JsonSerializationSchema(),
                properties,
                Optional.of(new FlinkKafkaPartitionerImpl())); // 容错

        return myProducer;
    }

    /**
     * kafka分区器
     */
    static class FlinkKafkaPartitionerImpl extends FlinkKafkaPartitioner<Tuple2<String,Integer>> {

        @Override
        public void open(int parallelInstanceId, int parallelInstances) {
            System.out.println("open-----------");
        }

        /**
         *
         * @param data the record value 数据
         * @param bytes serialized key of the record
         * @param bytes1 serialized value of the record
         * @param s target topic for the record 主题
         * @param ints found partitions for the target topic 该主题的分区
         *
         * @return
         */
        @Override
        public int partition(Tuple2<String,Integer> data, byte[] bytes, byte[] bytes1, String s, int[] ints) {
            // 分区总数
            int partitionNum = ints.length;
            // 根据 单词 的hashCode计算分区索引,注意:hashCode可能是负数,由于分区索引不能是负数,所以取绝对值
            int partitionIndex = Math.abs( data.f0.hashCode()) % partitionNum;
            return partitionIndex;
        }
    }
    static class FlatMapFunImpl extends RichFlatMapFunction<String, Tuple2<String, Integer>> {

        @Override
        public void flatMap(String value, Collector<Tuple2<String, Integer>> out) throws Exception {
            String[] arr = value.split(" ");
            for(String item : arr){
                Tuple2<String, Integer> temp = Tuple2.of(item, 1);
                out.collect(temp);
            }

        }
    }

    /**
     * 自定义序列化器
     */
    static class JsonSerializationSchema implements SerializationSchema<Tuple2<String, Integer>> {
        @Override
        public byte[] serialize(Tuple2<String, Integer> element) {
            String data = element.f0+","+element.f1;

            return data.getBytes();
        }
    }
}
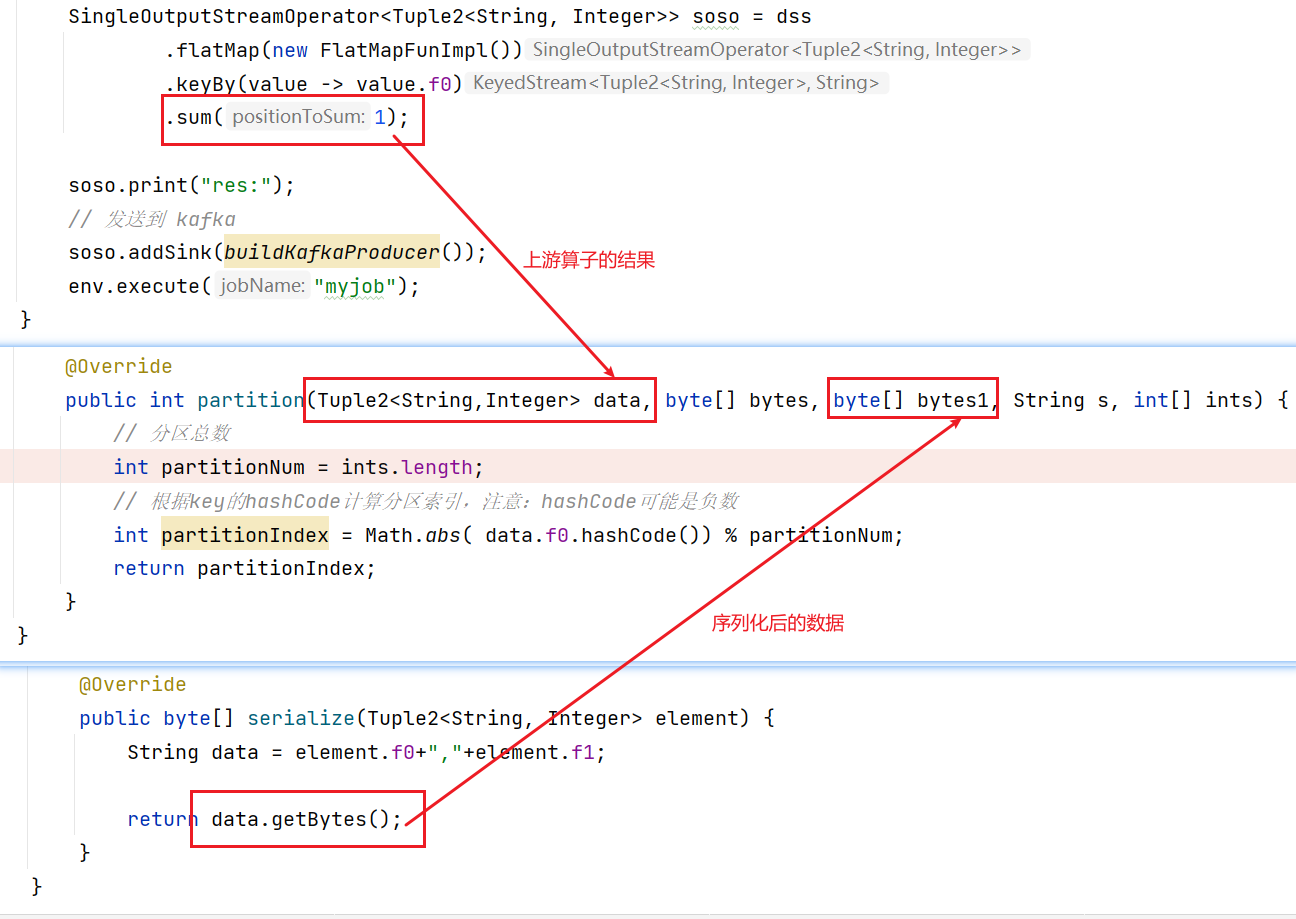
解释
执行结果
分区  偏移量  数据  时间戳
0    66    lili,2    2022-12-17 16:34:54.054
2    16    李雷,1    2022-12-17 16:34:54.054
2    17    李雷,2    2022-12-17 16:34:54.054
1    28    lucy,1    2022-12-17 16:34:50.050
1    29    lucy,2    2022-12-17 16:34:54.054